1 简介
Apache Flume 是一个分布式,高可用的数据收集系统。它可以从不同的数据源收集数据,经过聚合后发送到存储系统中,通常用于日志数据的收集。Flume 分为 NG 和 OG (1.0 之前) 两个版本,NG 在 OG的基础上进行了完全的重构,是目前使用最为广泛的版本。
Flume 跟 Sqoop、Kettle 有类似的地方但是又有不同,随后会详细分析。
2 基本架构及核心概念
基本架构图【官网】:

来自尚硅谷的资料,侵删,【这个较为详尽】: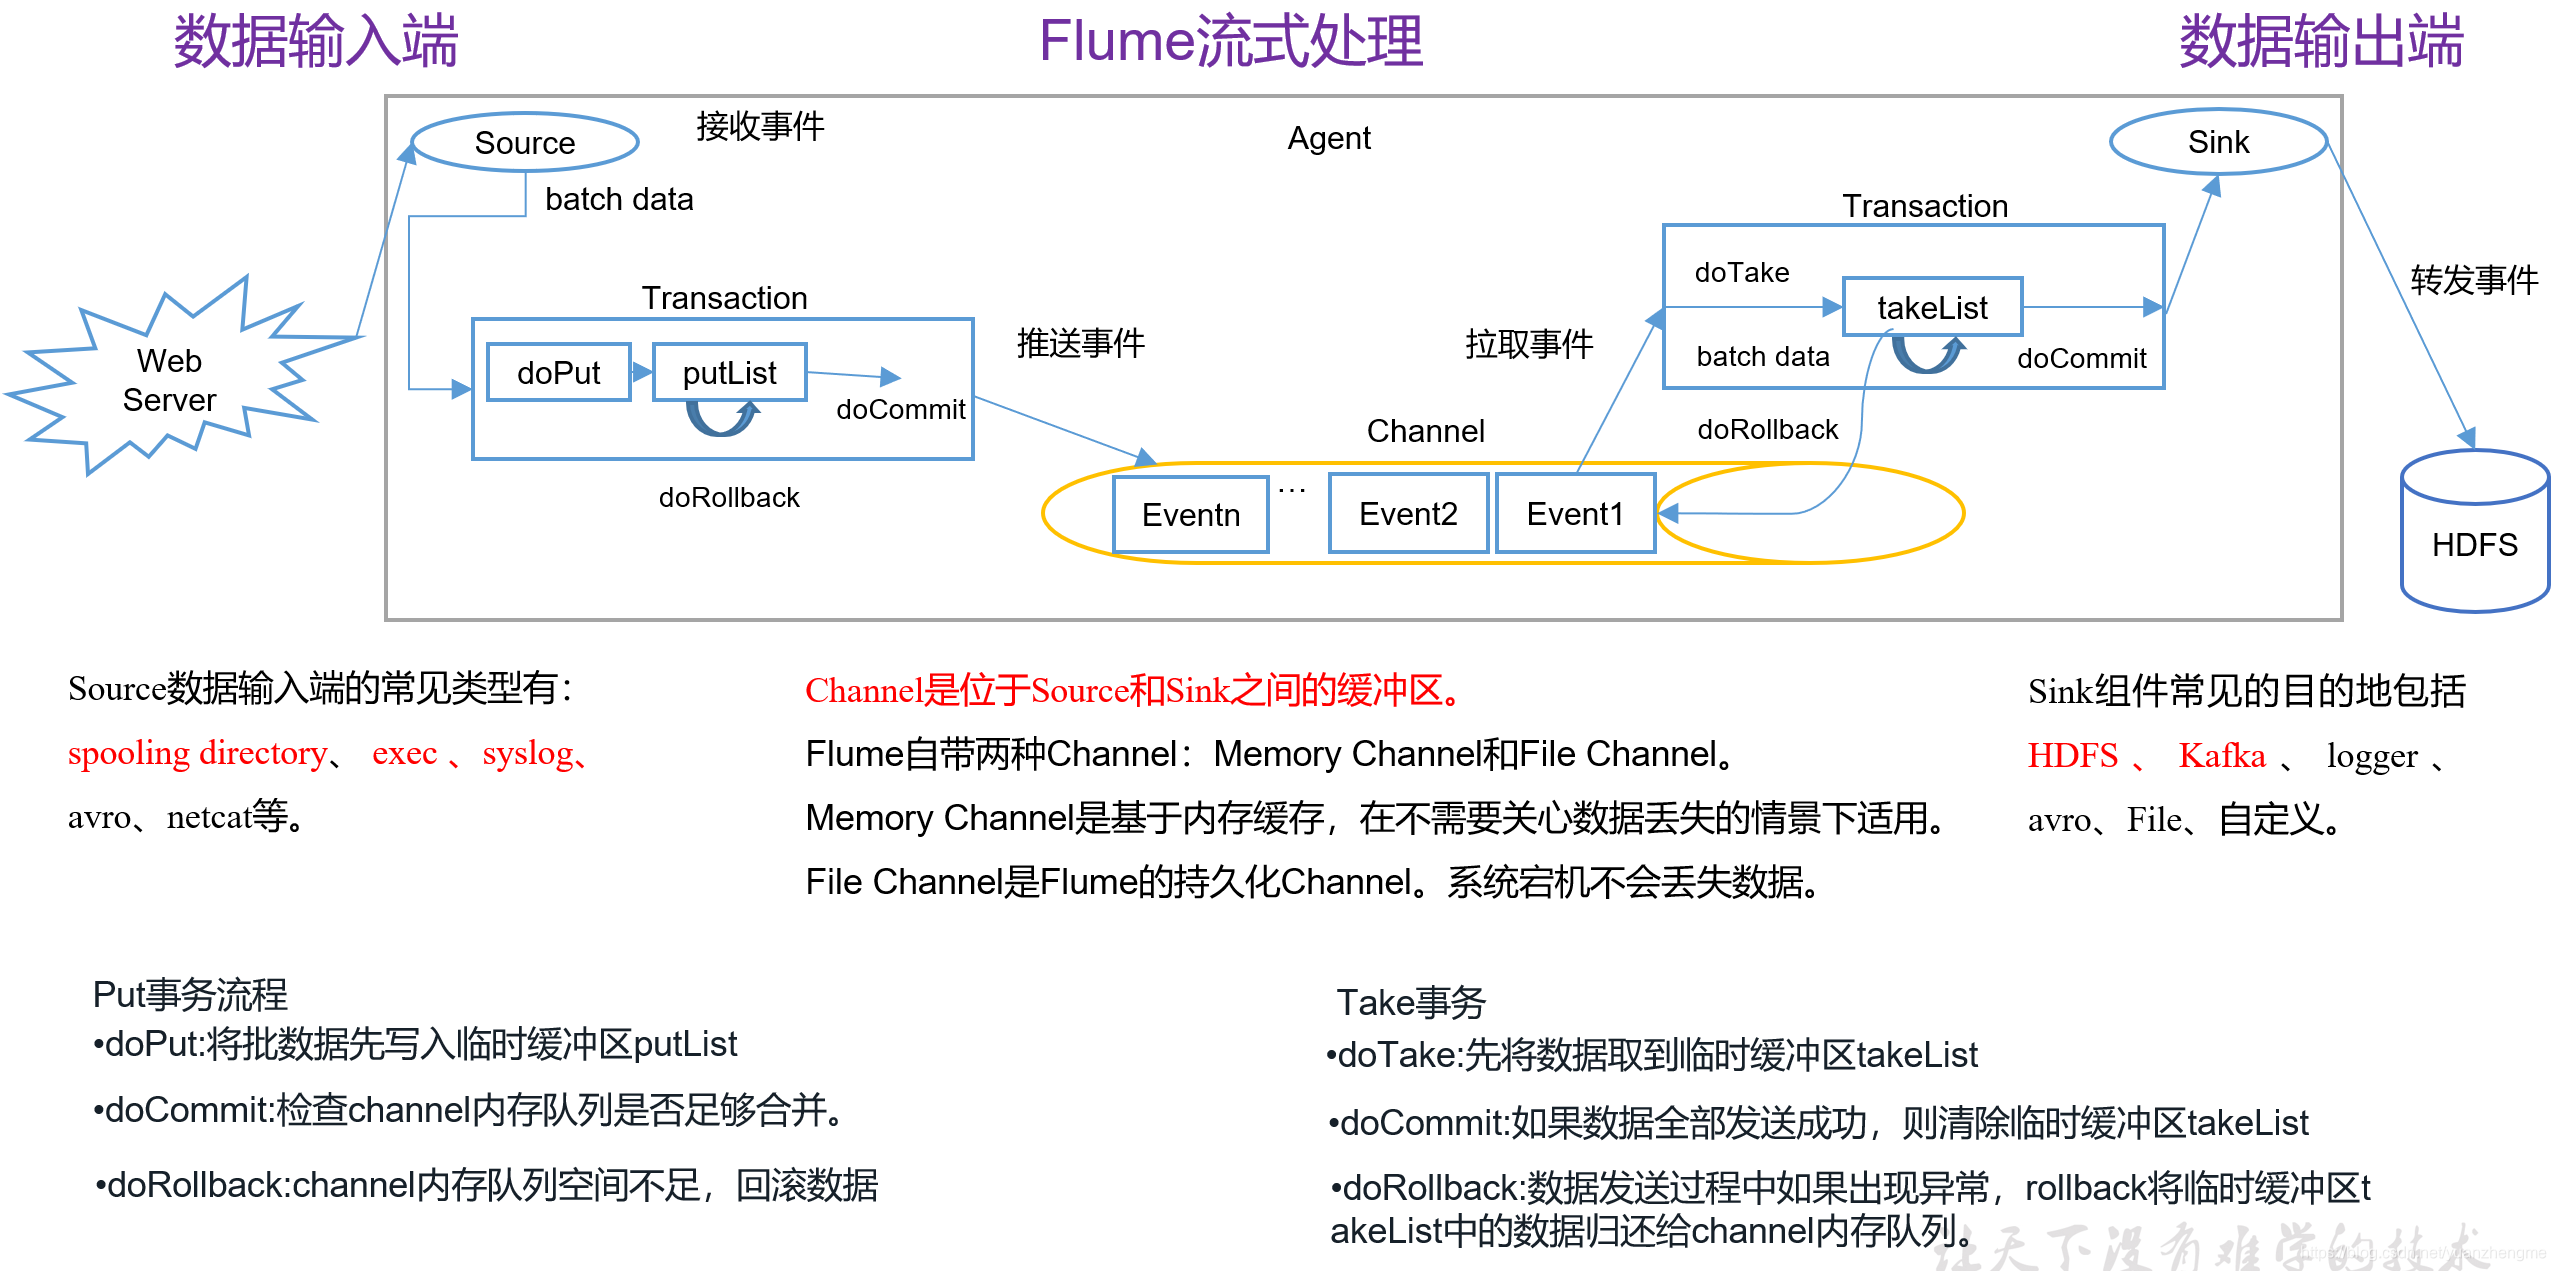
2.1 基本架构
这里我们可以类比Kafka进行理解,外部数据源【扮演Kafka的生产者】以特定格式向 Flume 发送 events (事件)【就像Kafka的message一样】,当 source 接收到 events 时,它将其存储到一个或多个 channel【是不是很像Kafka的副本】,channe 会一直保存 events 直到它被 sink 所消费。sink 的主要功能从 channel 中读取 events 【是不是很像Kafka的消费者】,并将其存入外部存储系统或转发到下一个 source,成功后再从 channel 中移除 events。【跟Kafka多么的像】:elephant:
2.2 核心概念
Agent: 是一个JVM进程,它以事件的形式将数据从源头送至目的,是Flume数据传输的基本单元。Agent主要有3个部分组成,Source、Channel、Sink。
Event: 它是 Flume NG 数据传输的基本单元。类似于 JMS 和消息系统中的消息。一个 Event 由标题和正文组成:前者是键/值映射,后者是任意字节数组。
Source: 数据收集组件,从外部数据源收集数据,并存储到 Channel 中。Source组件可以处理各种类型、各种格式的日志数据,包括 avro、thrift、exec、jms、spooling directory、netcat、sequence generator、syslog、http、legacy。
Channel: 是源和接收器之间的管道,用于临时存储数据。Channel允许Source和Sink运作在不同的速率上。Channel是线程安全的,可以同时处理几个Source的写入操作和几个Sink的读取操作。可以是内存或持久化的文件系统:
Memory Channel : 使用内存中的队列,优点是速度快,但数据可能会丢失 (程序死亡、机器宕机或者重启都会导致数据丢失);
File Channel : 使用持久化的文件系统,将所有事件写到磁盘,因此在程序关闭或机器宕机的情况下不会丢失数据,优点是能保证数据不丢失,但是速度慢。
Sink: Sink不断地轮询Channel中的事件且批量地移除它们,并将这些事件批量写入到存储或索引系统、或者被发送到另一个Flume Agent。
Sink是完全事务性的。在从Channel批量删除数据之前,每个Sink用Channel启动一个事务。批量事件一旦成功写出到存储系统或下一个Flume Agent,Sink就利用Channel提交事务。事务一旦被提交,该Channel从自己的内部缓冲区删除事件。Sink组件目的地包括hdfs、logger、avro、thrift、ipc、file、null、HBase、solr、自定义。
2.3 组件种类
Flume 中的每一个组件都提供了丰富的类型,适用于不同场景:
- Source 类型 :内置了几十种类型,如 Avro Source , Thrift Source , Kafka Source , JMS Source ;
- Sink 类型 : HDFS Sink , Hive Sink , HBaseSinks , Avro Sink 等;
- Channel 类型 : Memory Channel , JDBC Channel , Kafka Channel , File Channel 等。
对于 Flume 的使用,除非有特别的需求,否则通过组合内置的各种类型的 Source,Sink 和 Channel就能满足大多数的需求。在 Flume 官网 上对所有类型组件的配置参数均以表格的方式做了详尽的介绍【Flume的官网是真的很不错,清晰 :clap: 】,并附有配置样例;同时不同版本的参数可能略有所不同,所以使用时建议选取官网的《Flume 1.9.0 User Guide》作为主要参考资料。
3 架构模式
3.1 multi-agent flow
Flume 支持跨越多个 Agent 的数据传递,这要求前一个 Agent 的 Sink 和下一个 Agent 的 Source 都必须是 Avro 类型,Sink 指向 Source 所在主机名 (或 IP 地址) 和端口。
3.2 Consolidation
Consolidation(联合,统一;合并) 日志收集中常常存在大量的客户端(比如分布式 web 服务),Flume 支持使用多个 Agent 分别收集日志,然后通过一个或者多个 Agent 聚合后再存储到文件系统中。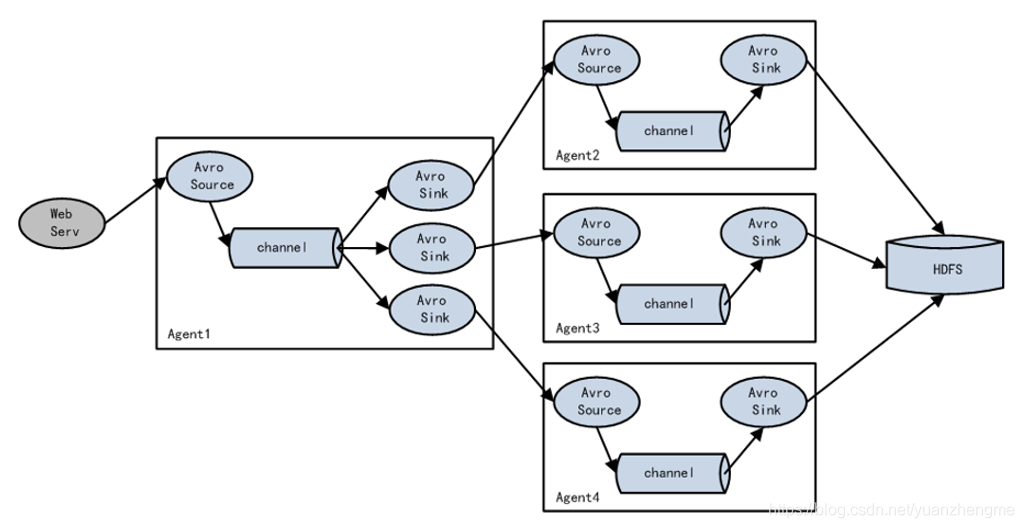
3.3 Multiplexing the flow
Flume 支持从一个 Source 向多个 Channel,也就是向多个 Sink 传递事件,这个操作称之为 Fan Out (扇出)。默认情况下 Fan Out 是向所有的 Channel 复制 Event ,即所有 Channel 收到的数据都是相同的。同时 Flume 也支持在 Source 上自定义一个复用选择器 (multiplexing selector) 来实现自定义的路由规则。
3.4 负载均衡

4 Agent内部原理
【来自尚硅谷的资料 侵删】这里不详细说明了,大家理解理解: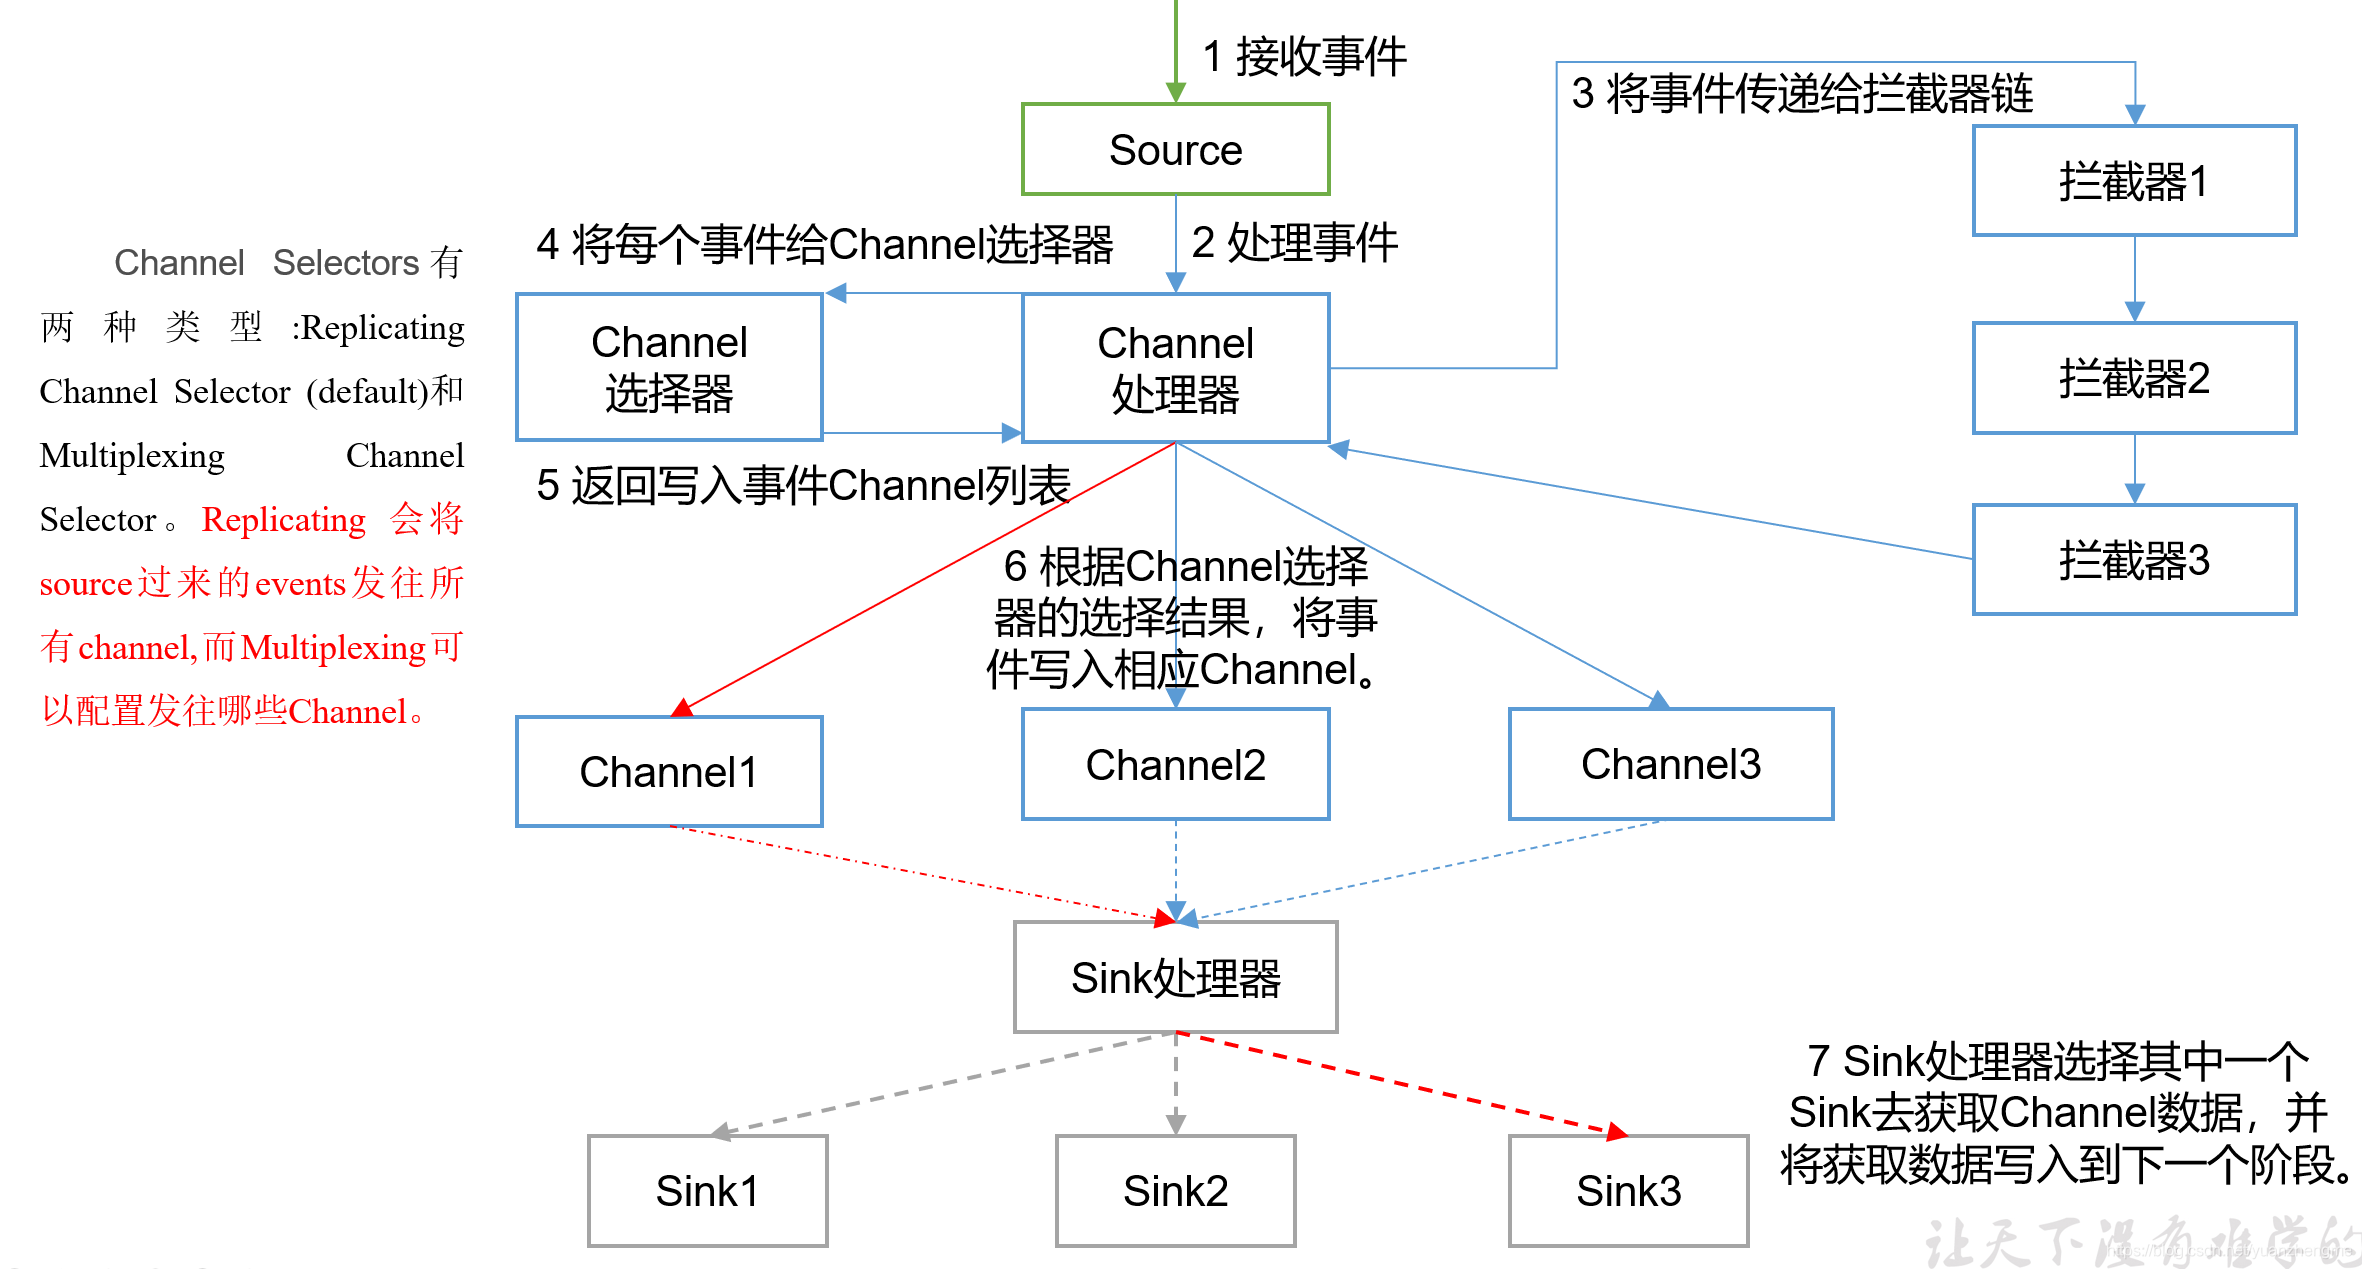
5 配置格式
配置通常需要【定义】和【绑定】两个部分,放在哪个可以随自己的习惯:
- 定义 Agent 的 Sources,Channels,Sinks 及其具体参数【参数可以从官网查询】。基本格式如下:
```xml定义agentName的sources、channels、sinks
.sources =
.channels =
.sinks =
定义sources的具体属性
.sources.. =
定义channels的具体属性
.channels.. =
.channels.. =
定义sinks的具体属性
.sinks.. =
2. 绑定 Sources 和 Sinks 的 Channels。需要注意的是一个Sources可以配置多个Channels,但一个 Sink只能配置一个Channel。【sources后的是channels,sinks后的是channel,一定要注意。】基本格式如下:
```xml
# 绑定sources的channels
<agentName>.sources.<sourceName>.channels = <channelName1> <channelName2> ...

# 绑定sinks的channel
<agentName>.sinks.<sinkName>.channel = <channelName1>