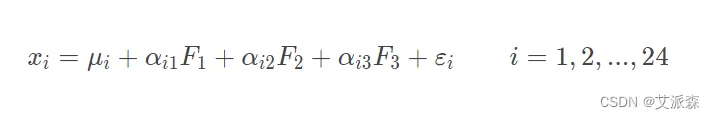因子分析

因子分析的基本思想
因子分析以最少的信息丢失为前提,将众多的原有变量综合成较少的几个综合指标,名为因子。因子有以下几个特点:
- 因子个数远远少于原有变量的个数
- 因子能够反映原有变量的绝大部分信息
- 因子之间的线性关系不显著
判断因子分析的前提条件是否满足
因子分析有一个前提要求:原有变量之间应具有较强的相关关系。
一般在因子分析时需首先对原有变量是否相关进行研究,常用的方法有:
- 计算相关系数矩阵
- 巴特利特球度检验
- 原假设H0是:相关系数矩阵是单位阵,如果巴特利特球度检验对应的概率P值小于等于给定的显著性水平α,则应拒绝原假设,认为相关系数矩阵不太可能是单位阵, 原有变量适合作因子分析。
- KMO检验
- KMO统计量的取值在0~1之间。KMO值越接近0,意味着变量间的相关性越弱,原有变量越不适合作因子分析;KMO值越接近1,意味着变量间的相关性越强,原有变量越适合作因子分析。
因子分析案例

【案例】—— 对高校学报的原有变量进行因子分析
①导入数据
②选择菜单【分析】----> 【降维】----> 【因子】
③选择变量,点击描述

④勾选选项,点击继续

⑤提取

⑥旋转

⑦因子得分

⑧选项

⑨点击“确定”,在输出窗口中查看输出结果:

从描述统计中可以看到各个变量的平均值,标准偏差及分析个案数。
⑩相关性矩阵

从相关性矩阵中可以看到,每个变量与每个变量之间的相关性高。如从表中可以看到载文量与基金论文比的相关系数是 0.391。 从显著性值可以看每个变量与每个变量之间是否显著相关。如载文量和基金论文比的显著性0.075>0.05,说明这两个变量相关性不显著。而载文量和被引期刊数的显著小于0.05,说明载文量和被引期刊数有显著性相关。从表中发现大多数概率P值都是小于 0.05的,说明大多数变量之间相关性显著。

KMO 检验统计量是用于比较变量间简单相关系数和偏相关系数的指标。主要应用于多元统计的因子分析。KMO 统计量是取值在0和1之间。0.9 以上表示非常适合;0.8 表示适合;0.7 表示一般;0.6 表示不太适合;0.5 以下表示极不适合。

从公因子方差表中可以看到提取值都比较高,表明变量中大部分信息能被因子所提取,说明因子分析结果有效。

总方差解释图表,也称主成分列表。一个因子所解释的方差比例越高,这个因子包含原有变量信息的量就越多。第一个成分的初始特征值为4.864能解释的方差比例为60.804%,第二个特征 值为1.163,能解释的方差比例为14.541。其余四个成分都小于1,说明这几个成分的解释力度还不如直接引入原变量大。这七个变量只需要提取出头两个成分即可。

碎石图中,从第二个成分以后的特征值就降得非常低。第二个成分就是这一图形的“拐点”。在这一实例中,只需要提取两个主要成分就行了。

表中列出未使用旋转方法时使用因子能解释的各个变量的比例(各变量的信息被主成分提取了多少)。

表中列出了使用旋转方法后因子能解释的各个变量的比例。和上面未旋转对比可以看出,旋转后,原先较大的比例值仍然大,较小的比例则变得更小。

成分转换矩阵表,用来说明旋转前后主成份间的系数对应关系。

从旋转后的空间中的组件图中可以看到,被引半衰期和基金论文比属于一类成分,其余属于另外一类。