线程池引言
池分类
- 线程池
- 数据库连接池
- 内存池
- 异步请求池
池化优势
缓冲, 重复利用, 大大减少重建, 节约资源, 提高效率, 提高利用率
核心优势在哪里?
- 提前创建, 申请, 反复利用, 而不是重新创建, 申请.
- 反复利用所以利用率高, 也节约了资源
- 提前创建, 而不是临时创建, 省去了创建时间, 提高了效率
用在何处
- 频繁需要申请释放处。 反正经常用, 我何不提前创建好, 等待你用, 用完我也不扔掉, 继续等你其他时候用.
- 多线程处:均可以考虑抛入线程池, 减少线程频繁创建销毁
- 注意:频繁是核心.
- 生活例子: 蓄水池, 酒池肉林, 好处何在? 方便吧, 提前放好, 随用随取
线程池组件

线程队列:
提前开启线程,
多线程同步消费任务队列中的任务
多线程同步消费:加锁 + 条件消费, 同步等待, 一个线程需要消费必须同时具备两个条件, 1.获取锁 2. 满足条件 (存在任务)
同步:核心在于条件等待, 等待着一个条件满足,然后同步触发一个事件, 阻塞函数, 同步等待.
同步优势:对于共享资源的有序消费, 多线程之间互相等待, 互相同步, 稳定消费
任务队列
也可叫做阻塞队列: blocking queue 学名
阻塞队列作用:异步解耦合, 任务放入任务队列中, 立刻返回, 在工作线程繁忙的时候,不至于需要等待线程空闲.
线程队列
组织成双向队列的多线程. 工作线程, 消费者线程, 提前开启, 等待处理任务
生活实例:办事窗口
线程池
将上述两大组件组合在一起 + mutex锁 + cond条件变量 实现同步消费

Reactor分解
何为Reactor
反应堆, 事件反应堆, 反射堆: 将对io的操作封装成对事件的操作
Reactor组件
- 多路复用器 收集反应事件 epoll
- 事件处理器 回调处理机制
- 利用回调封装事件循环
网络IO处理分解
- io检测封装: epoll活跃io事件收集
- io操作封装, 读写io
- 对数据的解析操作封装, parser 业务逻辑
Reactor抛入线程池的方式
single reactor thread + worker threadpool
抛线程池方式1: 将parser业务处理抛入线程池
单线程reactor + 工作线程池

做法: 将业务逻辑处理单独抛入一个工作线程池进行处理. 实现网络IO跟业务的解耦合
使用场景: 相比IO, 业务逻辑处理耗时相当严重. 比如说写日志呀, XML 文件的解析、数据库记录的查找、文件资料的读取和传输、计算型工作的处理等,它们会拖慢整个反应堆模式的执行效率。此时我们就可以将其单独抛到另外的Thread pool 中去执行业务需求.
好处:反应堆线程仅仅处理网络IO 而 decode、compute、enode 型工作放置到另外的线程池中, 两者解耦,在业务处理耗时情况下大大提高效率
抛线程池方式2: 将IO操作 + parser都抛入线程池处理
使用场景:IO操作跟parser的处理都相当耗时的情境下, 将其放在事件循环中会拖慢整个事件循环的进程。
好处:事件循环可以最快的响应活跃事件.
缺陷:针对IO操作: 我们可能存在对于fd的一个共享问题. 一个线程在操作fd,另外一个线程给fd关闭了,这个就是一个大的问题. (核心在于可能出现fd的多线程共用的问题)
处理方式: 要么不应该使多个线程共享同一个fd,要么对fd进行简单的加锁操作。
充分利用多核CPU,主从Reactor
单Reactor的时候, reactor 反应堆同时分发Acceptor 上的连接建立事件和已建立连接的 I/O 事件。这样对于客户端接入量不高的情况下是完全OK的.
但是一旦客户端接入量特别大的情况下, reactor既要分发连接建立,又分发已建立连接的 I/O,有点忙不过来,在实战中的表现可能就是客户端连接成功率偏低。
引出 --- 主从Reactor模式, 多Reactor模型, 将 acceptor 上的连接建立事件和已建立连接的 I/O 事件分离
核心思想: main Reactor只负责分发连接建立事件, sub Reactor 来负责已经建立连接的事件的分发.
sub Reactor的数量设置: 依据CPU数量而定
优势:服务器稳定性大大提升, 客户端连接成功率大大提高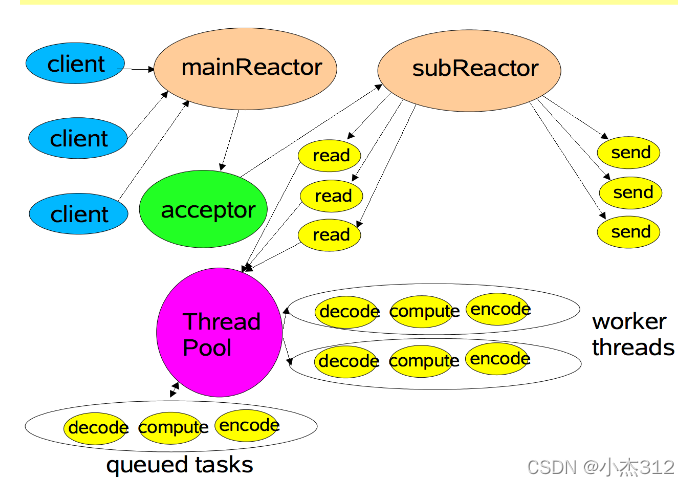
面试项目书写小技巧 (文末彩蛋)
对比书写, 分版本书写, 不同的版本优势是什么, 加入了什么技术, 带来了什么样的好处, 获益是什么
eg:本文中的reactor.
我在简历项目上书写, 实现了一个多线程reactor网络服务器框架
最开始使用什么样的技术, 实现了单线程reactor的框架, 然后对比单线程reacor跟多线程reactor, 表明加入线程池 + 主从reactor之后的优势所在. 带来了什么样的提升, 服务器稳定性提升呀, 性能抗压性提升等. (此处仅为小杰己见, 可能会有益处)
如下是我在网上找到的一个大佬写的单Reactor + 线程池的实现, 我觉得写的很棒, 其中的代码很多都是特别值得我们去品味的
如下是小杰自己封装的一款单线程 reactor + 方式1 抛入线程池.
threadpool.h
#ifndef _THREADPOOL_H_
#define _THREADPOOL_H_
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <pthread.h>
typedef void (*Func)(void*);
/*
  线程池组件
  1. 任务队列 (阻塞队列)
  2. 工作队列 (消化任务队列中的任务)
  3. 管理组件, 管理平衡工作 + 任务队列  (线程池)
*/
#define LL_ADD(item, list) do {\
  item->pre = NULL;\
  item->next = list;\
  list = item;\
} while (0)
#define LL_REMOVE(item, list) do {\
  if (item->pre != NULL) item->pre->next = item->next;\
  if (item->next != NULL) item->next->pre = item->pre;\
  if (item == list) list = item->next;\
  item->pre = item->next = NULL;\
} while (0)
typedef struct Task {
  Func task_run; //执行task任务, 处理user_data
  void* user_data;
  struct Task* pre;
  struct Task* next;
} Task;
//工作线程, 消化执行 task
typedef struct Wocker {
  pthread_t tid;
  int terminate;//终止, 停止工作
  struct Mannger* pool;
  struct Wocker* pre;
  struct Wocker* next;
} Wocker;
//管理组件, 管理平衡上述的Task + Wocker
typedef struct Mannger {
  struct Wocker* wockers;//工作队列
  struct Task* tasks;//任务队列
  pthread_mutex_t lock;
  pthread_cond_t cond;
} ThreadPool;
//线程执行函数, 核心所在
void* thread_routine(void* arg) {
  Wocker* wocker = (Wocker*)arg;
  while (1) {
    pthread_mutex_lock(&wocker->pool->lock);
    if (wocker->pool->tasks == NULL) {
      if (wocker->terminate) break;//中断
      pthread_cond_wait(&wocker->pool->cond, &wocker->pool->lock);
    }
    //至此说明获取到锁了
    if (wocker->terminate) {
      pthread_mutex_unlock(&wocker->pool->lock);
      break;
    }
    Task* task = wocker->pool->tasks;
    if (task != NULL) {
      LL_REMOVE(task, wocker->pool->tasks);
    }
    pthread_mutex_unlock(&wocker->pool->lock);
    task->task_run(task);
  }
  free(wocker);//delete掉
}
//创建线程池, 开启消费者线程
ThreadPool* thread_pool_create(int thread_num) {
  ThreadPool* pool = (ThreadPool*)malloc(sizeof(ThreadPool));
  pool->wockers = NULL;
    pool->tasks = NULL;
  pthread_mutex_init(&pool->lock, NULL);
  pthread_cond_init(&pool->cond, NULL);
  int i = 0;
  for (i = 0; i < thread_num; ++i) {
    Wocker* wocker = (Wocker*)calloc(sizeof(Wocker), 1);
    wocker->pool = pool;
    pthread_create(&wocker->tid, NULL, thread_routine, (void*)wocker);
    LL_ADD(wocker, pool->wockers);
  }
  return pool;
}
void thread_pool_destroy(ThreadPool* pool) {
  if (pool == NULL) return ;
  Wocker* wocker = NULL;
  for (wocker = pool->wockers; wocker != NULL; wocker = wocker->next) {
    wocker->terminate = 1;//中断运行, 所有的工作线程中断工作
  }
  pthread_mutex_lock(&pool->lock);
  pthread_cond_broadcast(&pool->cond);//核心所在
  //广播让所有的工作线程退出工作
  pthread_mutex_unlock(&pool->lock);
  pthread_cond_destroy(&pool->cond);
  pthread_mutex_destroy(&pool->lock);
  //释放所有资源
  //free_all(pool);
}
void thread_pool_push_task(ThreadPool* pool, Task* task) {
    pthread_mutex_lock(&pool->lock);
    LL_ADD(task, pool->tasks);
    pthread_cond_signal(&pool->cond);//通知有任务可以消费了
    pthread_mutex_unlock(&pool->lock);
}
#endif
reactor.h
#ifndef _REACTOR_H_
#define _REACTOR_H_
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/socket.h>
#include <sys/epoll.h>
#include <arpa/inet.h>
#include <fcntl.h>
#include <errno.h>
#include <string.h>
#include <fcntl.h>
#include "threadpool.h"
//简易reactor封装, 实现事件循环, 事件驱动
//io检测封装: epoll事件收集
//事件驱动, 事件循环封装, 设置回调
//IO操作封装, 设置收发缓冲区 + 处理返回
//reactor进一步升级, 更符合业务需求.
//网络 跟 业务需求 隔离解除耦合性
#define MAX_N 512
typedef struct sockaddr SA;
typedef int (*CallBack)(int fd, int events, void* arg);
#define BUFFSIZE 1024
void err_exit(const char* reason) {
  fprintf(stderr, "%s : %d : %s\n", reason, errno, strerror(errno));
  exit(EXIT_FAILURE);
}
//封装epoll
typedef struct reactor {
  int epfd;
  struct epoll_event* events;//容器, 收集活跃事件
  int stop;
  ThreadPool* pool;
} reactor;
typedef struct sockitem {
  int sockfd;
  //封装回调, 事件驱动
  CallBack callback;
  struct reactor* eventloop;
  //每条连接读写缓冲区封装
  char recvbuffer[BUFFSIZE];
  int rlen;
  char sendbuffer[BUFFSIZE];
  int slen;
} sockitem;
//事件处理器声明
int accept_cb(int fd, int events, void* arg);
int recv_cb(int fd, int events, void* arg);
int send_cb(int fd, int events, void* arg);
struct reactor* init_reactor(int n) {
  struct reactor* eventloop = (struct reactor*)malloc(sizeof(struct reactor));
  eventloop->epfd = epoll_create(1);
  eventloop->events = (struct epoll_event*)malloc(sizeof(struct epoll_event) * n);
  eventloop->stop = 0;
  eventloop->pool = thread_pool_create(10);
  return eventloop;
}
void release_reactor(struct reactor* eventloop) {
  if (NULL == eventloop) return;
  close(eventloop->epfd); //关闭epfd
  free(eventloop);
  return ;
}
struct sockitem* init_sockitem(struct reactor* eventloop, int sockfd, CallBack callback) {
  struct sockitem* si = (struct sockitem*)malloc(sizeof(struct sockitem));
  si->sockfd = sockfd;
  si->callback = callback;
  si->eventloop = eventloop;
  return si;
}
void setnoblock(int fd) {
  int flag = fcntl(fd, F_GETFL, 0);
  if (-1 == fcntl(fd, F_SETFL, flag | O_NONBLOCK)) {
    err_exit("fcntl");
  }
}
int add_event(struct reactor* eventloop, int events, sockitem* si) {
  struct epoll_event ev;
  ev.events = events;
  ev.data.ptr = si;
  if (-1 == epoll_ctl(eventloop->epfd, EPOLL_CTL_ADD, si->sockfd, &ev)) {
    err_exit("epoll_ctl add");
  }
  return 0;
}
int del_event(struct reactor* eventloop, sockitem* si) {
  if (NULL == si) return 1;
  if (-1 == epoll_ctl(eventloop->epfd, EPOLL_CTL_DEL, si->sockfd, NULL)) {
    err_exit("epoll_ctl del");
  }
  free(si);
  return 0;
}
int mod_event(struct reactor* eventloop, int events, sockitem* si) {
  struct epoll_event ev;
  ev.events = events;
  ev.data.ptr = si;
  if (-1 == epoll_ctl(eventloop->epfd, EPOLL_CTL_MOD, si->sockfd, &ev)) {
    err_exit("epoll_ctl mod");
  }
  return 0;
}
int accept_cb(int fd, int events, void* arg) {
  struct sockitem* si = (struct sockitem*)arg;
  socklen_t cli_addr_len = sizeof(struct sockaddr_in);
  struct sockaddr_in cli_addr;
  char ip_buff[INET_ADDRSTRLEN] = {0};
  int cli_fd = accept(fd, (SA*)&cli_addr, &cli_addr_len);
  setnoblock(cli_fd);//非阻塞, 避免因为一条连接的事件阻塞其他连接得不到处理
  if (-1 == cli_fd) {
    err_exit("accept");
  }
  printf("recv from ip %s at port %d\n", inet_ntop(AF_INET, &cli_addr.sin_addr, ip_buff, sizeof(ip_buff)),
    ntohs(cli_addr.sin_port));
  //封装si事件
  struct sockitem* newsi = init_sockitem(si->eventloop, cli_fd, recv_cb);
  //将si 放入eventloop事件循环
  add_event(si->eventloop, EPOLLIN | EPOLLET, newsi);
  return cli_fd;
}
void task_run(void* arg) {
  Task* task = (Task*)arg;
  //拿取任务执行
  struct sockitem* si = (struct sockitem*)task->user_data;
  char* data = si->recvbuffer;
  //处理数据, 进行运算
  int i = 0;
  char op;
  int lhs = 0, rhs = 0;
  int flag = 0;//标记lhs, rhs
  int ans = 0;
  while (data[i]) {
    if (data[i] >= '0' && data[i] <= '9') {
      if (!flag) {
        for (; data[i] >= '0' && data[i] <= '9'; ++i) {
          lhs = lhs * 10 + (data[i] - '0');
        }
        flag = 1;
        i -= 1;
      } else {
        for (; data[i] >= '0' && data[i] <= '9'; ++i) {
          rhs = rhs * 10 + (data[i] - '0');
        }
        break;
      }
    } else if (data[i] == ' ') {
      i += 1;
          continue;
    } else {
      op = data[i];
    }
    i += 1;
  }
  switch(op) {
    case '+' : {
      ans = lhs + rhs;
    } break;
    case '-' : {
      ans = lhs - rhs;
    } break;
    case '*' : {
      ans = lhs * rhs;
    } break;
    case '/' : {
      ans = lhs / rhs;
    } break;
  }
    printf("%d %c %d = %d\n", lhs, op, rhs, ans);
  sprintf(si->sendbuffer, "%d %c %d = %d\n", lhs, op, rhs, ans);
  //数据写入到sendbuffer种去
  si->slen = strlen(si->sendbuffer);
  memset(si->recvbuffer, 0, BUFFSIZE);//清空读缓冲区.
  si->rlen = 0;
  si->callback = send_cb;
  mod_event(si->eventloop, EPOLLOUT | EPOLLET, si);
  free(task);
}
int recv_cb(int fd, int events, void* arg) {
  struct sockitem* si = (struct sockitem*)arg;
  struct epoll_event ev;
    int ret = 0;
  while (1) {
    ret = recv(fd, si->recvbuffer, BUFFSIZE, 0);
    if (ret < 0) {
      if (errno == EINTR) {//信号打断
        continue;
      }
      if (errno == EWOULDBLOCK) {//写缓冲区满了
        break;
      }
      del_event(si->eventloop, si);
      close(fd);
      err_exit("recv");//出错了
    } else if (ret == 0) {
      //对端断开连接
      printf("fd %d disconnect\n", fd);
      del_event(si->eventloop, si);
      close(fd);
      return 0;
    } else {
      break;
    }
  }
  //接收到数据之后进行处理, 将其抛入到线程池处理
  #if 0
  //打印接收到的数据
  printf("recv: %s, %d Bytes\n", si->recvbuffer, ret);
  //设置sendbuffer
  si->rlen = ret;
  memcpy(si->sendbuffer, si->recvbuffer, si->rlen);
  si->slen = si->rlen;
    //清空recvbuffer
    memset(si->recvbuffer, 0,BUFFSIZE);
  si->callback = send_cb;
  mod_event(si->eventloop, EPOLLOUT | EPOLLET, si);
  #elif 1
  //如何抛入到线程池进行处理?
  /*
    假设业务逻辑是: 将字符串转换为算式进行计算
  */
  printf("recv: %s, %d Bytes\n", si->recvbuffer, ret);
  si->rlen = ret;
  Task* task = (Task*)malloc(sizeof(Task));
  //先创建任务结构体
  task->next = task->pre = NULL;
  task->task_run = task_run;
  task->user_data = (void*)si;
  thread_pool_push_task(si->eventloop->pool, task);
  #endif
  return 0;
}
int send_cb(int fd, int events, void* arg) {
  struct sockitem* si = (struct sockitem*)arg;
  while (1) {
    int n = send(fd, si->sendbuffer, BUFFSIZE, 0);
    if (-1 == n) {
      if (errno == EINTR) {//信号打断
        continue;
      }
      if (errno == EWOULDBLOCK) {//写缓冲区满了
        break;
      }
      //出错了
      err_exit("send");
    }
    printf("send %d bytes\n", n);
    //每一次send之后从新将senbuffer置为空
    memset(si->sendbuffer, 0, BUFFSIZE);
    break;//正常写完
  }
  si->callback = recv_cb;
  mod_event(si->eventloop, EPOLLIN | EPOLLET, si);
}
//事件循环一次
void eventloop_once(struct reactor* eventloop) {
  int nready = epoll_wait(eventloop->epfd, eventloop->events, MAX_N, -1);
  int i = 0;
  for (i = 0; i < nready; ++i) {
    int mask = 0;
    struct epoll_event* ev= &eventloop->events[i];
    if (ev->events & EPOLLIN) mask |= EPOLLIN;
        if (ev->events & EPOLLOUT) mask |= EPOLLOUT;
        //将EPOLLERR + EPOLLHUP 的处理交付到io函数中进行处理, 放到回调中处理
        if (ev->events & EPOLLERR) mask |= EPOLLIN|EPOLLOUT;
        if (ev->events & EPOLLHUP) mask |= EPOLLIN|EPOLLOUT;
        if (mask & EPOLLIN) {
          struct sockitem* si = (struct sockitem*)ev->data.ptr;
          si->callback(si->sockfd, mask, si);
        }
        if (mask & EPOLLOUT) {
          struct sockitem* si = (struct sockitem*)ev->data.ptr;
          si->callback(si->sockfd, mask, si);
        }
  }
}
//开启事件循环
void start_eventloop(struct reactor* eventloop) {
  while (!eventloop->stop) {
    eventloop_once(eventloop);
  }
}
//停止事件循环
void stop_eventloop(struct reactor* eventloop) {
  eventloop->stop = 1;
}
#endif
reator.c
#include "reactor.h"
int init_sock(short port) {
  int sockfd = socket(AF_INET, SOCK_STREAM, 0);
  if (-1 == sockfd) {
    err_exit("socket");
  }
  struct sockaddr_in addr;
  memset(&addr, 0, sizeof(addr));
  addr.sin_family = AF_INET;
  addr.sin_port = htons(port);
  addr.sin_addr.s_addr = INADDR_ANY;
  if (-1 == bind(sockfd, (SA*)&addr, sizeof(addr))) {
    err_exit("bind");
  }
  if (-1 == listen(sockfd, 5)) {
    err_exit("listen");
  }
  return sockfd;
}
int main(int argc, char* argv[]) {
  if (2 != argc) {
    fprintf(stderr, "usage: %s <port>", argv[0]);
    exit(EXIT_FAILURE);
  }
  short port = atoi(argv[1]);
  int sockfd = init_sock(port);
  //至此完成了网络连接了
  struct reactor* mainloop = init_reactor(MAX_N);
  //封装listen的
  struct sockitem* si = init_sockitem(mainloop, sockfd, accept_cb);
  add_event(mainloop, EPOLLIN, si);//对于监视套接字一般是水平触发
  start_eventloop(mainloop);
  //回收资源
  release_reactor(mainloop);
  return 0;
}