大数据翻页的难点和技巧

简介:

screenshot

今天要讨论一个传统的问题,问题本身比较简单,就是针对大数据,如何优化方案做到性能与成本的平衡。我们经常会遇到一种Key-list类型数据, 如一个用户的好友关系 {“uid”:{1,2,3,4,5}},表示uid包含有5个好友;一条微博下面的评论id列表{“weibo_id”: {comment_id1, comment_id2……}},一个用户发表的微博id列表等。

在list长度较少时候,我们可以直接的使用数据库的翻页功能,如

SELECT * FROM LIST_TABLE LIMIT offset, row_count;

根据经验,在大部分场景下,单个业务的list数据长度99%在1000条以下,在数据规模较小时候,上面的方法非常适合。但剩下的1%的数据可能多达100万条,在数据规模较大的时候,当访问offset较大的数据,上述方法非常低效(可参看Why does MYSQL higher LIMIT offset slow the query down?),但在实现方案的时候不能忽视这些超大数据集的问题,因此要实现一个适合各种变长list的翻页方案,考虑到数据的长尾问题,并没有简单高效的方案。这也体现了常说的80%+的时间在优化20%-的功能。

List数据访问模型常见的有两种方式

1 . 扶梯方式

扶梯方式在导航上通常只提供上一页/下一页这两种模式,部分产品甚至不提供上一页功能,只提供一种“更多/more”的方式,也有下拉自动加载更多的方式,在技术上都可以归纳成扶梯方式。

screenshot
(图:blogspot的导航条)
screenshot

(图:很多瀑布流式的产品只提供一个more的导航条)

扶梯方式在技术实现上比较简单及高效,根据当前页最后一条的偏移往后获取一页即可,在MySQL可使用以下方法实现。

SELECT * FROM LIST_TABLE WHERE id > offset_id LIMIT n;

由于where条件中指定了位置,因此算法复杂度是O(log n)

2. 电梯方式

另外一种数据获取方式在产品上体现成精确的翻页方式,如1,2,3……n,同时在导航上也可以由用户输入直达n页。国内大部分产品经理对电梯方式有特殊的喜好,如图
screenshot

但电梯方式在技术实现上相对成本较高,当使用以下SQL时

SELECT * FROM LIST_TABLE LIMIT offset, row_count;

我们可以使用MySQL explain来分析,从下文可以看到,当offset=10000时候,实际上MySQL也扫描了10000行记录。

screenshot

为什么会这样?在MySQL中,索引通常是b-tree方式(但存储引擎如InnoDB实际是b+tree),如图

screenshot

从图中可以看到,使用电梯方式时候,当用户指定翻到第n页时候,并没有直接方法寻址到该位置,而是需要从第一楼逐个count,scan到 countpage时候,获取数据才真正开始,所以导致效率不高。对应的算法复杂度是O(n),n指offset,也就是pagecount。

另外Offset并不能有效的缓存,这是由于

1、在数据存在新增及删除的情况下,只要有一条变化,原先的楼层可能会全部发生变化。在一个用户并发访问的场景,频繁变化的场景比较常见。

2、电梯使用比较离散,可能一个20万条的list,用户使用了一次电梯直达100楼之后就走了,这样即使缓存100楼之下全部数据也不能得到有效利用。

以上描述的场景属于单机版本,在数据规模较大时候,互联网系统通常使用分库的方式来保存,实现方法更为复杂。

在面向用户的产品中,数据分片通常会将同一用户的数据存在相同的分区,以便更有效率的获取当前用户的数据。如下图所示

screenshot

(图:数据按用户uid进行hash拆分)

图中的不同年份的数据的格子是逻辑概念,实际上同一用户的数据是保存在一张表中。因此方案在常见的使用场景中存在很大不足,大部分产品用户只访问最 近产生的数据,历史的数据只有极小的概率被访问到,因此同一个区域内部的数据访问是非常不均匀,如图中2014年生成的属于热数据,2012年以前的属于 冷数据,只有极低的概率被访问到。但为了承担红色部分的访问,数据库通常需要高速昂贵的设备如SSD,因此上面方案所有的数据都需要存在SSD设备中,即 使这些数据已经不被访问。

简单的解决方案是按时间远近将数据进行进一步分区,如图。

screenshot

注意在上图中使用时间方式sharding之后,在一个时间分区内,也需要用前一种方案将数据进行sharding,因为一个时间片区通常也无法用一台服务器容纳。

上面的方案较好的解决了具体场景对于key list访问性能及成本的平衡,但是它存在以下不足

  • 数据按时间进行滚动无法全自动,需要较多人为介入或干预
  • 数据时间维度需要根据访问数据及模型进行精巧的设计,如果希望实现一个公用的key-list服务来存储所有业务的数据,这个公用服务可能很难实现
  • 为了实现电梯直达功能,需要增加额外的二级索引,比如2013年某用户总共有多少条记录

由于以上问题,尤其是二级索引的引入,显然它不是理想中的key list实现,后文继续介绍适合大数据翻页key list设计的一些思路及尝试。
文章转载自 开源中国社区 [http://www.oschina.net]

相关实践学习
基于MaxCompute的热门话题分析
Apsara Clouder大数据专项技能认证配套课程:基于MaxCompute的热门话题分析
相关文章
|
存储 算法 Python
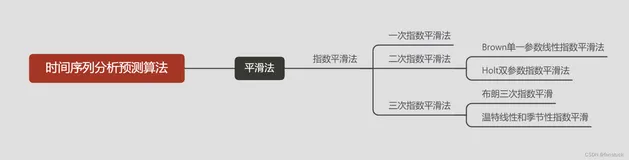
一文速学-时间序列分析算法之指数平滑法详解+Python代码实现
3665 0
一文速学-时间序列分析算法之指数平滑法详解+Python代码实现
|
存储 负载均衡 Kubernetes
Openresty动态更新(无reload)TCP Upstream的原理和实现
本文介绍了对Openresty或Nginx的TCP Upstream的动态更新(无需Reload)的一种实现方式,这种实现对于正在尝试做Nginx扩展的开发者是一种参考。文中我们对nginx结合lua对一次请求的处理流程和可扩展方式也进行了说明,重要的是给出了实际代码帮助开发者理解。目前社区中比如Kong、nginx-ingress-controller等基于Nginx扩展的项目都是类似的思路。
12577 1
Openresty动态更新(无reload)TCP Upstream的原理和实现
|
Java API PHP
(转载)为什么不推荐使用swoole和hyperf官方框架
5996 0
|
数据可视化 小程序 程序员
uni-app 配置编译环境与动态修改manifest.json参数
2945 0
|
Web App开发 小程序 前端开发
微信小程序自动化测试最佳实践(附 Python 源码)
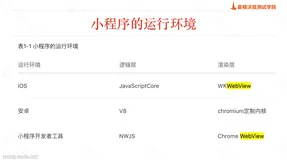
本文主要分享下微信小程序自动化测试的一些最佳实践心得,包括微信小程序的基本测试技术和操作方法,以及如何利用 Appium 的 WebView 测试技术 + adb proxy 完成微信小程序的自动化测试(可能是目前最实用的小程序自动化测试技术),并附上 Python 版源码。
微信小程序自动化测试最佳实践(附 Python 源码)
|
6月前
|
缓存 监控 网络协议
通过IP地址查询判断网络风险,有哪些具体指标和判断方法?
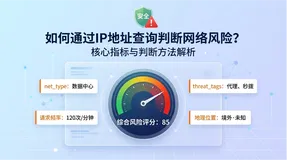
本文详解IP风险评估三大核心维度:基础属性(如net_type、地理位置)、行为特征(频率、IP段聚集性)与历史信誉(risk_score、threat_tags),结合离线库毫秒查询与动态阈值策略,提供可落地的分级风控方案,有效识别代理、秒拨及云主机恶意流量。
通过IP地址查询判断网络风险,有哪些具体指标和判断方法?
|
7月前
|
存储 缓存 安全
Go map 底层原理
虽然大家天天都在用 `map`,但很多人对它的理解只停在“查得快”“底层是哈希表”“桶里有 8 个槽位”这几句。或许跟别人吹牛的时候,还有几分用处;但真到线上排查延迟抖动、锁竞争、内存占用、热点键冲突,这点认识往往是不够的。
516 1
|
8月前
|
安全 Go API
Go1.26新提案:errors.AsType —— 更安全、更简洁的错误类型检查方案
Go 1.26 新增 `errors.AsType[E error](err error) (E, bool)`,以泛型替代反射实现错误类型匹配。相比传统 `errors.As`,它无需预声明变量、避免指针误用、杜绝运行时 panic,支持 `if x, ok := AsType[T](err); ok` 短声明,作用域更安全,性能更高,代码更简洁清晰。(239字)
394 6
|
消息中间件 人工智能 监控
Go与定时任务
Go语言凭借其高效的并发能力和简洁的语法,广泛应用于分布式系统和云计算领域。本文从控制台Admin、触发器Trigger、调度器Scheduler、执行器Executor四方面,详解Go语言实现分布式定时任务的设计与代码示例。
382 0
|
canal 关系型数据库 MySQL
"揭秘阿里数据同步黑科技Canal:从原理到实战,手把手教你玩转MySQL数据秒级同步,让你的数据处理能力瞬间飙升,成为技术界的新晋网红!"
【8月更文挑战第18天】Canal是一款由阿里巴巴开源的高性能数据同步系统,它通过解析MySQL的增量日志(Binlog),提供低延迟、可靠的数据订阅和消费功能。Canal模拟MySQL Slave与Master间的交互协议来接收并解析Binary Log,支持数据的增量同步。配置简单直观,包括Server和Instance两层配置。在实战中,Canal可用于数据库镜像、实时备份等多种场景,通过集成Canal Client可实现数据的消费和处理,如更新缓存或写入消息队列。
2270 0