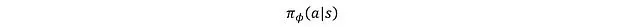Actor-Critic:强化学习中的参与者-评价者算法简介

简介: Actor-Critic:强化学习中的参与者-评价者算法简介

640.png

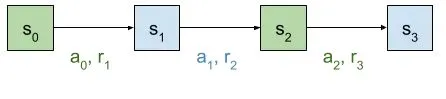
Actor-Critic从名字上看包括两部分,参与者(Actor)和评价者(Critic)。其中Actor使用策略函数,负责生成动作(Action)并和环境交互。而Critic使用我们之前讲到了的价值函数,负责评估Actor的表现,并指导Actor下一阶段的动作。

基于策略和基于价值的RL算法

在基于策略的RL中,最优策略是通过直接操纵策略来计算的,而基于价值的函数通过找到最优值函数来隐式地找到最优策略。基于策略的RL在高维和随机的连续动作空间以及学习随机策略方面非常有效。同时,基于价值的RL在样品效率和稳定性方面表现出色。

策略梯度RL的主要挑战是高梯度方差。减少梯度估计方差的标准方法是使用基线函数b(st)[4]。关于添加基线会引起很多关注,这会在梯度估计中引起偏差。有证据表明,基线不能为梯度估算提供基础。

证明基线是无偏见的

REINFORCE算法的策略梯度表达式如下所示:

640.png

REINFORCE的策略梯度表达的期望形式

我们可以写出轨迹的奖励R(τ)如下:

640.png

然后添加基线函数,如下所示修改策略梯度表达式:

640.png

插入基线功能

我们可以将奖励和基准期限称为优势函数。可以表示如下:

640.png

优势功能

在上面的等式中要注意的重要一点是基线b是s_t而不是s_t` [4]的函数

我们可以重新排列表达式,如下所示:

640.png

上式是等效的E(X-Y)。由于期望的线性,因此我们可以将E(X-Y)重新排列为E(X)-E(Y)[3]。因此,对上面的等式进行了如下修改:

640.png

如果带有基线的第二项为零,则可以证明添加基线函数b在梯度估计中未添加偏差。那意味着

640.png

我们可以将期望概括如下:

640.png

第二项的证明为零,如下所示:

640.png

上面的推论证明,添加基线函数对梯度估计没有偏差

Actor-critic

简单来说,Actor-Critic是策略梯度的时间差异(TD)版本[3]。它有两个网络:参与者和评论家。参与者决定应该采取哪种行动,评论家告知参与者该行动有多好,应该如何调整。参与者的学习基于策略梯度方法。相比之下,评论家通过计算价值函数来评估参与者的行动。

这种类型的架构是在生成对抗网络(GAN)中,鉴别器和生成器都参与游戏[2]。生成器生成伪图像,鉴别器使用其真实图像的表示来评估所生成的伪图像的质量[2]。随着时间的流逝,生成器可以创建伪造的图像,这些伪造的图像对于鉴别器是无法区分的[2]。同样,Actor和Critic都参与了游戏,但是与GAN [2]不同,他们都在不断改进。

Actor-critic类似于带有基准的称为REINFORCE的策略梯度算法。强化是MONTE-CARLO的学习,它表示总收益是从整个轨迹中采样的。但是在参与者评论家中,我们使用引导程序。因此,优势功能的主要变化。

640.png

策略梯度总回报中的原始优势函数更改为自举。资料来源:[3]

最后,b(st)更改为当前状态的值函数。可以表示如下:

640.png

我们可以为actor-critic编写新的修改后的优势函数:

640.png

或者,将优势函数称为TD错误,如Actor-Critic框架所示。如上所述,参与者的学习是基于策略梯度的。参与者的策略梯度表达式如下所示:

640.png

参与者的政策梯度表达

Actor-Critic算法的伪代码[6]

1、使用来自参与者网络的策略πθ对{s_t,a_t}进行采样。

2、评估优势函数A_t。可以将其称为TD误差δt。在Actor-critic算法中,优势函数是由评论者网络产生的。

640.png

3、使用以下表达式评估梯度:

640.png

4、更新策略参数θ

640.png

5、更新基于评价者的基于价值的RL(Q学习)的权重。δt等于优势函数。

640.png

6、重复1到5,直到找到最佳策略πθ。

引用

  1. https://inst.eecs.berkeley.edu/~cs188/sp20/assets/files/SuttonBartoIPRLBook2ndEd.pdf
  2. https://theaisummer.com/Actor_critics/
  3. http://machinelearningmechanic.com/deep_learning/reinforcement_learning/2019/12/06/a_mathematical_introduction_to_policy_gradient.html
  4. https://danieltakeshi.github.io/2017/03/28/going-deeper-into-reinforcement-learning-fundamentals-of-policy-gradients/
  5. https://en.wikipedia.org/wiki/Expected_value
  6. http://rail.eecs.berkeley.edu/deeprlcourse-fa17/f17docs/lecture_5_actor_critic_pdf
目录
相关文章
|
机器学习/深度学习 数据采集 算法
智能限速算法:基于强化学习的动态请求间隔控制
本文分享了通过强化学习解决抖音爬虫限速问题的技术实践。针对固定速率请求易被封禁的问题,引入基于DQN的动态请求间隔控制算法,智能调整请求间隔以平衡效率与稳定性。文中详细描述了真实经历、问题分析、技术突破及代码实现,包括代理配置、状态设计与奖励机制,并反思成长,提出未来优化方向。此方法具通用性,适用于多种动态节奏控制场景。
929 7
智能限速算法:基于强化学习的动态请求间隔控制
|
机器学习/深度学习 算法 机器人
多代理强化学习综述:原理、算法与挑战
多代理强化学习是强化学习的一个子领域,专注于研究在共享环境中共存的多个学习代理的行为。每个代理都受其个体奖励驱动,采取行动以推进自身利益;在某些环境中,这些利益可能与其他代理的利益相冲突,从而产生复杂的群体动态。
1181 5
|
机器学习/深度学习 存储 算法
强化学习算法基准测试:6种算法在多智能体环境中的表现实测
本文系统研究了多智能体强化学习的算法性能与评估框架,选用井字棋和连珠四子作为基准环境,对比分析Q-learning、蒙特卡洛、Sarsa等表格方法在对抗场景中的表现。实验表明,表格方法在小规模状态空间(如井字棋)中可有效学习策略,但在大规模状态空间(如连珠四子)中因泛化能力不足而失效,揭示了向函数逼近技术演进的必要性。研究构建了标准化评估流程,明确了不同算法的适用边界,为理解强化学习的可扩展性问题提供了实证支持与理论参考。
692 0
强化学习算法基准测试:6种算法在多智能体环境中的表现实测
|
机器学习/深度学习 算法 数据可视化
基于Qlearning强化学习的机器人迷宫路线搜索算法matlab仿真
本内容展示了基于Q-learning算法的机器人迷宫路径搜索仿真及其实现过程。通过Matlab2022a进行仿真,结果以图形形式呈现,无水印(附图1-4)。算法理论部分介绍了Q-learning的核心概念,包括智能体、环境、状态、动作和奖励,以及Q表的构建与更新方法。具体实现中,将迷宫抽象为二维网格世界,定义起点和终点,利用Q-learning训练机器人找到最优路径。核心程序代码实现了多轮训练、累计奖励值与Q值的可视化,并展示了机器人从起点到终点的路径规划过程。
806 0
|
机器学习/深度学习 算法 PyTorch
深度强化学习中SAC算法:数学原理、网络架构及其PyTorch实现
软演员-评论家算法(Soft Actor-Critic, SAC)是深度强化学习领域的重要进展,基于最大熵框架优化策略,在探索与利用之间实现动态平衡。SAC通过双Q网络设计和自适应温度参数,提升了训练稳定性和样本效率。本文详细解析了SAC的数学原理、网络架构及PyTorch实现,涵盖演员网络的动作采样与对数概率计算、评论家网络的Q值估计及其损失函数,并介绍了完整的SAC智能体实现流程。SAC在连续动作空间中表现出色,具有高样本效率和稳定的训练过程,适合实际应用场景。
6581 7
深度强化学习中SAC算法:数学原理、网络架构及其PyTorch实现
|
机器学习/深度学习 算法 机器人
强化学习:时间差分(TD)(SARSA算法和Q-Learning算法)(看不懂算我输专栏)——手把手教你入门强化学习(六)
本文介绍了时间差分法(TD)中的两种经典算法:SARSA和Q-Learning。二者均为无模型强化学习方法,通过与环境交互估算动作价值函数。SARSA是On-Policy算法,采用ε-greedy策略进行动作选择和评估;而Q-Learning为Off-Policy算法,评估时选取下一状态中估值最大的动作。相比动态规划和蒙特卡洛方法,TD算法结合了自举更新与样本更新的优势,实现边行动边学习。文章通过生动的例子解释了两者的差异,并提供了伪代码帮助理解。
1332 2
|
机器学习/深度学习 算法
强化学习之父Richard Sutton给出一个简单思路,大幅增强所有RL算法
Richard Sutton领导的团队提出了一种称为“奖励中心化”的方法,通过从观察到的奖励中减去其经验平均值,使奖励更加集中,显著提高了强化学习算法的性能。该方法在解决持续性问题时表现出色,尤其是在折扣因子接近1的情况下。论文地址:https://arxiv.org/pdf/2405.09999
540 15
|
机器学习/深度学习 人工智能 算法
探索人工智能中的强化学习:原理、算法与应用

热门文章

最新文章