开发者学堂课程【大数据分析之企业级网站流量运营分析系统开发实战(第二阶段):网站流量日志Flume收集--新组件taildir source介绍】学习笔记,与课程紧密联系,让用户快速学习知识。
课程地址:https://developer.aliyun.com/learning/course/694/detail/12184
网站流量日志Flume收集--新组件taildir source介绍
内容介绍:
一、 Flume采集简介
二、 TaildirSourse
三、 小结
一、Flume采集简介
了解数据采集当中的另外一种采集,flume 采集。在当下的大数据环境当中,采集有两种含义:一个指的是从无到有,一个指的是数据搬运的过程。以这个项目而言,当在页面上进行买点,进行用户行为数据收集的时候,可以解决从无到有的过程。如果要把收集的数据传输传递到分布式文件存储系统当中就要使用flume来帮助完成。比如:在一个 root 的目录下,对通过买点收集到的用户的相关数据,这里叫做access.log是2018年11月1号的,首先查看这个日志文件,可以发现里面的就是一条条的访问记录,有用户的IP、访问时间等相关的信息。问题在于这个数据采集是一个无到有的采集,就是说通过用户的行为把它记录下来的,如果要把这个数据给他采集到 apr 当中的话就需要 flume 来完成。
二、 TaildirSourse
扩展一个在 flume1.7之后的一个新的组件叫做TaildirSourse,这个组件的功能非常的强大,相当于把 flume 当中的两个组件做了一个整合并且支持断点续传的功能。
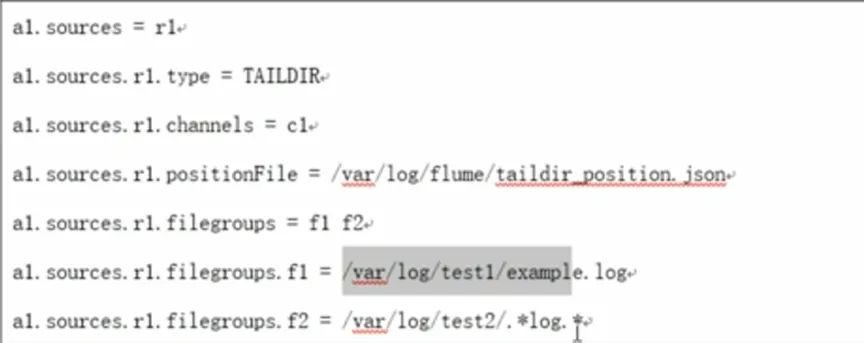
1.第一个功能,sourse 可以直接去指定一个文件,如果你路径是具体到一个文件,那么它就会去实时追踪这个文件的变化。比如:这里指向的是一个var路径下的example.log,一旦这个文件有变化,那么这个 sourse 就会感知到它的变化,进行数据收集,这种情况下相当于之前的 exec。
2.此外它还可以监控一个目录,并且通过正则匹配下面的文件名。第二个路径监控的是 test2路径下,这里并没有去指向一个具体的文件,而是一个正则匹配的文件格式.*log.*,就是说只要这个路径下能够生成符合这个格式的文件,那么这类文件也会被采集到,这种情况下就相当于spooldir sourse,从这一点可以发现taildir把这两个 sourse 做了一个整合,也就是说在一个 sourse 当中既可以去追踪文献的变化,又可以去监控文件夹的变化。
3.这个 sourse 还支持断点续传的功能,断点续传这个概念在生活当中处处可见。比如:大家都有通过用某种下载软件去下载电影的经历,比如说下载到了95%,这时候你点击暂停,那么暂停之后,在点继续下载之后,通常会有两种现象,第一种是从95%的地方继续下载,第二种是从头开始下载。这背后所包含的知识点就是所谓的断点续传。在上传文件,下载文件,传送文件的时候如果能够记录下来,了解文件传输到哪里,那么当出现故障或者中断重启之后,就可以从中断间隔的地方继续进行数据的上传,数据的采集,这个功能将会将会非常的棒。如果没有这个功能,比如去采集一个文件,采集到一半或60%的突然之间出故障了,然后重启,如果显示的是从零开始收集,那么还要把之前收集的删除掉,避免数据的重复。
所以组件相当于针对之前的两个组件做了一个升级,并且支持所谓断点续传,把采集的文件以及相关的路径以json文件的格式保存在文件当中。这几个参数就是1.7之后新sourse的一个核心配置,它的类型叫做taildir,可以坚持不同的文件组。比如:两个组一个叫f1,一个叫f2,f1的指向的是一个文件,f2指向的是一个文件夹下面匹配正则路径,那么这个positionfile指向的是支持断点续传保存位置路径。
三、小结:
flume 新 source taildir
1.监控文件的变化,追踪文件变化,此时相当于exec sourse:tail-f xxx。
2.监控文件夹下的文件的变化,并且支持正则匹配,相当于 spooldir sourse。
3.支持断点续传功能。通过文件记录上传的位置,那么在重启或者出现故障的时候呢可以继续工作。
这是一个新的 sourse,企业当中用的比较多,它相当于做了一个整合。通过这个新的组件把根目录下这个组件进行上传,这时候的采集叫做数据搬运的采集。