Centos7 搭建单机Spark分布式集群

简介: Centos7 搭建单机Spark分布式集群

1. JDK Hadoop Spark安装与配置


1.1 解压包


官网下载jdk、hadoop、sprak对应的包,注意版本


tar -zxvf jdk-8u241-linux-x64.tar.gz
tar -zxvf hadoop-3.2.2.tar.gz     
tar -zxvf spark-3.2.0-bin-hadoop3.2.taz 


1.2 配置环境变量


添加配置,注意文件路径以及文件名


vim /root/.bashrc


export JAVA_HOME=/root/ClassWork/jdk1.8.0_241
export CLASSPATH=.:${JAVA_HOME}/jre/lib/rt.jar:${JAVA_HOME}/lib/dt.jar:${JAVA_HOME}/lib/tools.jar
export PATH=$PATH:${JAVA_HOME}/bin
export HADOOP_HOME=/root/ClassWork/hadoop-3.2.2
export PATH=${HADOOP_HOME}/bin:${HADOOP_HOME}/sbin:$PATH
export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native
export HADOOP_OPTS="-Djava.library.path=$HADOOP_HOME/lib"
export CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath --glob):$CLASSPATH
export SPARK_HOME="/root/ClassWork/spark-3.2.0-bin-hadoop3.2"
export PATH=$SPARK_HOME/bin:$SPARK_HOME/sbin:$PATH 
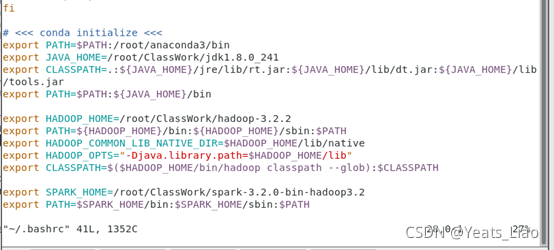


使配置生效


source /root/.bashrc


2. Scala安装与配置


2.1 Scala安装


wget http://www.scala-lang.org/files/archive/scala-2.11.8.tgz


tar -zxf scala-2.11.8.tgz


2.2 配置环境变量


添加配置


vim /root/.bashrc


export SCALA_HOME=/root/ClassWork/scala-2.11.8
export PATH=$PATH:$SCALA_HOME/bin
source /root/.bashrc


使配置生效


source /root/.bashrc


3. 配置集群


3.1 配置sprak


进入sprak的conf文件夹


把spark-env.sh.template复制一份spark-env.sh


cp spark-env.sh.template spark-env.sh


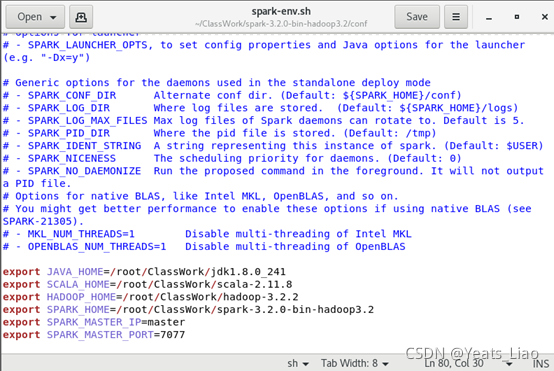
vim spark-env.sh


加入以下配置,注意目录以及版本号,对应上面第1步下载的版本


export JAVA_HOME=/home/hadoop/jdk1.8.0_241
export SCALA_HOME=/home/hadoop/scala-2.11.8
export HADOOP_HOME=/home/hadoop/hadoop-3.2.2
export SPARK_HOME=/home/hadoop/spark-3.2.0-bin-hadoop3.2
export SPARK_MASTER_IP=master
export SPARK_MASTER_PORT=7077


3.2 启动spark


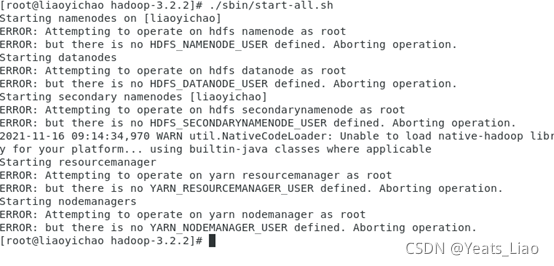
进入hadoop安装目录,启动hadoop


/sbin/start-all.sh


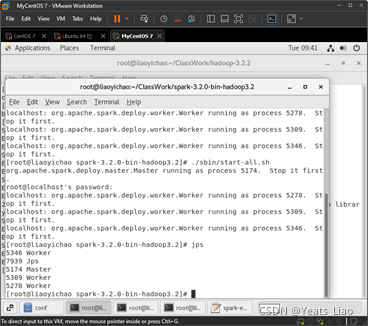
在进入spark安装目录,启动spark


/sbin/start-all.sh


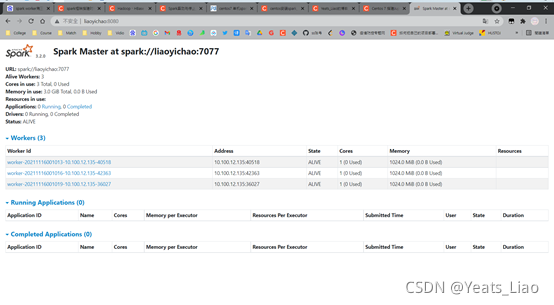
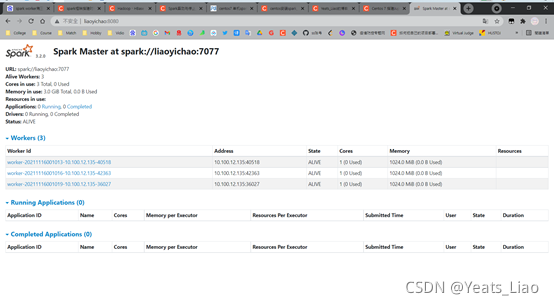
然后输入jps,看到了进程,说明已经启动了spark


4. 问题:虚拟机能运行,本机却不行?


原因:Centos防火墙拦截了端口


解决方法2选1


4.1 关闭Centos防火墙


查看防火墙状态


systemctl status firewalld.service


看到绿色字样标注的“active(running)”,说明防火墙是开启状态


停止防火墙


systemctl stop firewalld


4.2 如果不关闭防火墙,则开放端口


查看已开放的端口


firewall-cmd --list-ports


开放端口(上面配置的端口)


firewall-cmd --zone=public --add-port=8080/tcp --permanent


重启防火墙


firewall-cmd --reload


解决

目录
相关文章
|
存储 负载均衡 NoSQL
【赵渝强老师】Redis Cluster分布式集群
Redis Cluster是Redis的分布式存储解决方案,通过哈希槽(slot)实现数据分片,支持水平扩展,具备高可用性和负载均衡能力,适用于大规模数据场景。
977 2
|
Cloud Native 关系型数据库 分布式数据库
登顶TPC-C|云原生数据库PolarDB技术揭秘:Limitless集群和分布式扩展篇
阿里云PolarDB云原生数据库在TPC-C基准测试中以20.55亿tpmC的成绩刷新世界纪录,展现卓越性能与性价比。其轻量版满足国产化需求,兼具高性能与低成本,适用于多种场景,推动数据库技术革新与发展。
|
Cloud Native 关系型数据库 分布式数据库
登顶TPC-C|云原生数据库PolarDB技术揭秘:Limitless集群和分布式扩展篇
云原生数据库PolarDB技术揭秘:Limitless集群和分布式扩展篇
|
并行计算 PyTorch 算法框架/工具
融合AMD与NVIDIA GPU集群的MLOps:异构计算环境中的分布式训练架构实践
本文探讨了如何通过技术手段混合使用AMD与NVIDIA GPU集群以支持PyTorch分布式训练。面对CUDA与ROCm框架互操作性不足的问题,文章提出利用UCC和UCX等统一通信框架实现高效数据传输,并在异构Kubernetes集群中部署任务。通过解决轻度与强度异构环境下的挑战,如计算能力不平衡、内存容量差异及通信性能优化,文章展示了如何无需重构代码即可充分利用异构硬件资源。尽管存在RDMA验证不足、通信性能次优等局限性,但该方案为最大化GPU资源利用率、降低供应商锁定提供了可行路径。源代码已公开,供读者参考实践。
1735 3
融合AMD与NVIDIA GPU集群的MLOps:异构计算环境中的分布式训练架构实践
|
人工智能 分布式计算 调度
打破资源边界、告别资源浪费:ACK One 多集群Spark和AI作业调度
ACK One多集群Spark作业调度,可以帮助您在不影响集群中正在运行的在线业务的前提下,打破资源边界,根据各集群实际剩余资源来进行调度,最大化您多集群中闲置资源的利用率。
|
存储 SpringCloudAlibaba Java
【SpringCloud Alibaba系列】一文全面解析Zookeeper安装、常用命令、JavaAPI操作、Watch事件监听、分布式锁、集群搭建、核心理论
一文全面解析Zookeeper安装、常用命令、JavaAPI操作、Watch事件监听、分布式锁、集群搭建、核心理论。
1069 1
【SpringCloud Alibaba系列】一文全面解析Zookeeper安装、常用命令、JavaAPI操作、Watch事件监听、分布式锁、集群搭建、核心理论
|
存储 分布式计算 调度
Spark Master HA 主从切换过程不会影响到集群已有作业的运行, 为什么?
Spark Master 的高可用性(HA)机制确保主节点故障时,备用主节点能无缝接管集群管理,保障稳定运行。关键在于: 1. **Driver 和 Executor 独立**:任务执行不依赖 Master。 2. **应用状态保持**:备用 Master 通过 ZooKeeper 恢复集群状态。 3. **ZooKeeper 协调**:快速选举新 Master 并同步状态。 4. **容错机制**:任务可在其他 Executor 上重新调度。 这些特性保证了集群在 Master 故障时仍能正常运行。
|
存储 监控 大数据
构建高可用性ClickHouse集群:从单节点到分布式
【10月更文挑战第26天】随着业务的不断增长,单一的数据存储解决方案可能无法满足日益增加的数据处理需求。在大数据时代,数据库的性能、可扩展性和稳定性成为企业关注的重点。ClickHouse 是一个用于联机分析处理(OLAP)的列式数据库管理系统(DBMS),以其卓越的查询性能和高吞吐量而闻名。本文将从我的个人角度出发,分享如何将单节点 ClickHouse 扩展为高可用性的分布式集群,以提升系统的稳定性和可靠性。
1846 0
|
人工智能 分布式计算 大数据
大数据≠大样本:基于Spark的特征降维实战(提升10倍训练效率)
本文探讨了大数据场景下降维的核心问题与解决方案,重点分析了“维度灾难”对模型性能的影响及特征冗余的陷阱。通过数学证明与实际案例,揭示高维空间中样本稀疏性问题,并提出基于Spark的分布式降维技术选型与优化策略。文章详细展示了PCA在亿级用户画像中的应用,包括数据准备、核心实现与效果评估,同时深入探讨了协方差矩阵计算与特征值分解的并行优化方法。此外,还介绍了动态维度调整、非线性特征处理及降维与其他AI技术的协同效应,为生产环境提供了最佳实践指南。最终总结出降维的本质与工程实践原则,展望未来发展方向。
|
分布式计算 大数据 Apache
ClickHouse与大数据生态集成:Spark & Flink 实战
【10月更文挑战第26天】在当今这个数据爆炸的时代,能够高效地处理和分析海量数据成为了企业和组织提升竞争力的关键。作为一款高性能的列式数据库系统,ClickHouse 在大数据分析领域展现出了卓越的能力。然而,为了充分利用ClickHouse的优势,将其与现有的大数据处理框架(如Apache Spark和Apache Flink)进行集成变得尤为重要。本文将从我个人的角度出发,探讨如何通过这些技术的结合,实现对大规模数据的实时处理和分析。
1407 2
ClickHouse与大数据生态集成:Spark & Flink 实战

热门文章

最新文章