一、前言
上篇文章我们学习了Selenium页面操作原理及如何高效的进行元素定位
那Selenium的工作原理又是什么?是如何驱动浏览器的呢?这篇文章为你讲解Selenium工作原理及Webdriver对浏览器的配置和操作。
二、Selenium工作原理
Selenium进行自动化测试主要依赖三项:
测试脚本(你写的代码)
浏览器驱动(Webdriver,比如:chromedriver)
浏览器
其中核心部分就是Webdriver,它提供了一系列的API来供我们使用,以至于驱动浏览器做一些操作。
它的工作原理有时也会作为面试题,不少小伙伴Selenium用的很熟练,但因为答不出它的工作原理而被Pass!
所以我简单总结了一下,为了面试不被pass的标准答案
Webdriver工作原理:
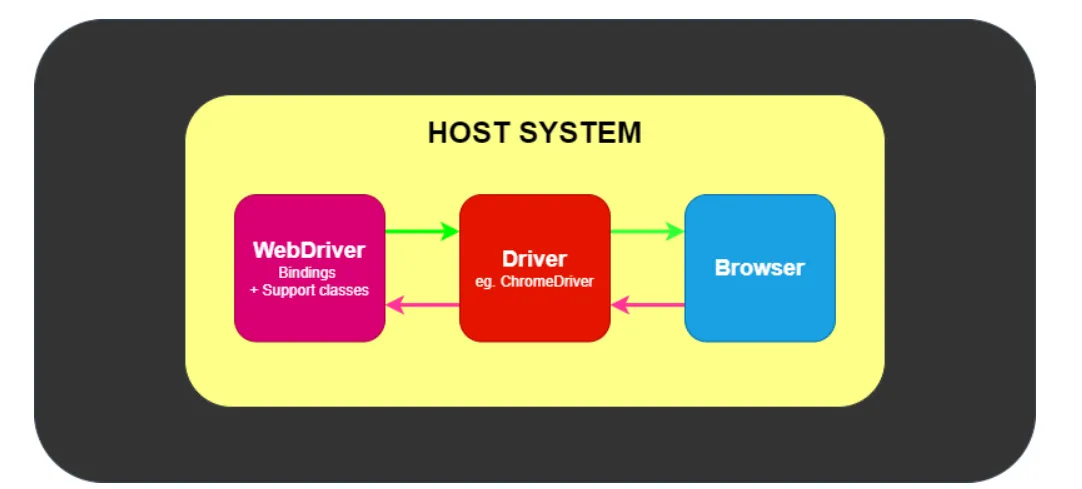
webdriver用于通信用户编写的代码和浏览器。
当使用类似webdriver.Chrome()启动浏览器后,webdriver会将启动的浏览器绑定到特定的端口,并作为服务端 (类似前后端分离项目的后端)
客户端 (用户编写的代码),通过ComandExecutor发送HTTP请求给服务端
服务端通过WebService将其翻译为浏览器读的懂的脚本传给浏览器进行执行,执行完成后,浏览器把执行结果返回给WebService,WebService再把返回的结果做一些封装,然后返回给客户端。
三、Webdriver常用配置
1. 启动浏览器
通过查看Selnium->webdriver文件夹,发现Selnium支持6种浏览器:
chrome、edge、firefox、ie、opera、safari
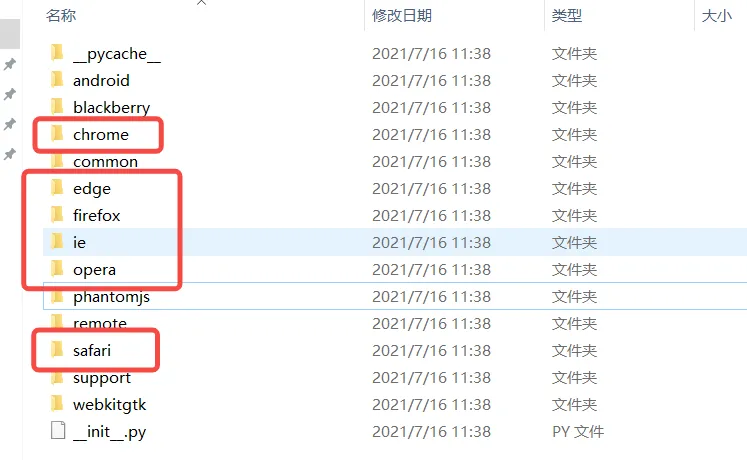
这里用谷歌、火狐的启动来举例
- 启动谷歌浏览器(需要chromedriver)
from selenium import webdriver
browser = webdriver.Chrome()
- 启动火狐浏览器(需要geckodriver)
from selenium import webdriver
browser = webdriver.Firefox()
2. Webdriver配置项
webdriver有很多配置项,例如设置请求头、隐藏浏览器运行、配置Webdriver路径等;下面为你介绍常用的配置项:
2.1 首先调用对应的配置类(以chrome举例)
chrome_options = webdriver.ChromeOptions()
2.2 最大化浏览器窗口
chrome_options.add_argument('--start-maximized')
2.3 隐藏浏览器运行(无界面Linux时,不加这条会报错)
chrome_options.add_argument('--headless')
2.4 给予root执行权限(Linux上运行时需要)
chrome_options.add_argument('--no-sandbox')
2.5 不加载图片,提升速度
chrome_options.add_argument('blink-settings=imagesEnabled=false')
2.6 使用已打开的浏览器
以chrome浏览器举例,我们可以通过【cmd】在chrome所在目录执行命令:
chrome.exe --remote-debugging-port=9222 --user-data-dir="C:\selenum\AutomationProfile"
-remote-debugging-port:用于配置浏览器启动占用的端口,可以指定任何未被占用的端口
-user-data-dir:指定创建新Chrome配置文件的目录;它是为了确保在单独的配置文件中启动chrome,不会污染你的默认配置文件。
然后在代码中加入下面的配置即可使用刚刚打开的浏览器了
chrome_options.add_experimental_option("debuggerAddress", "127.0.0.1:9222")
这样做的好处是:
- 是一个由chrome启动的浏览器,不容易被所测网站检测出是自动化程序、有利于爬虫的过检测。
- 基于该运行浏览器所产生的缓存、cookie等数据都会被记录。下次启动的时候不用重新登录帐号,也不用因为没有缓存导致页面加载时间过长。
2.7 手动指定浏览器位置
当存在多个谷歌浏览器或谷歌浏览器环境异常时,可以指定其浏览器文件路径进行驱动
chrome_options.binary_location = r"C:\Program Files (x86)\Google\Chrome\Application\chrome.exe"
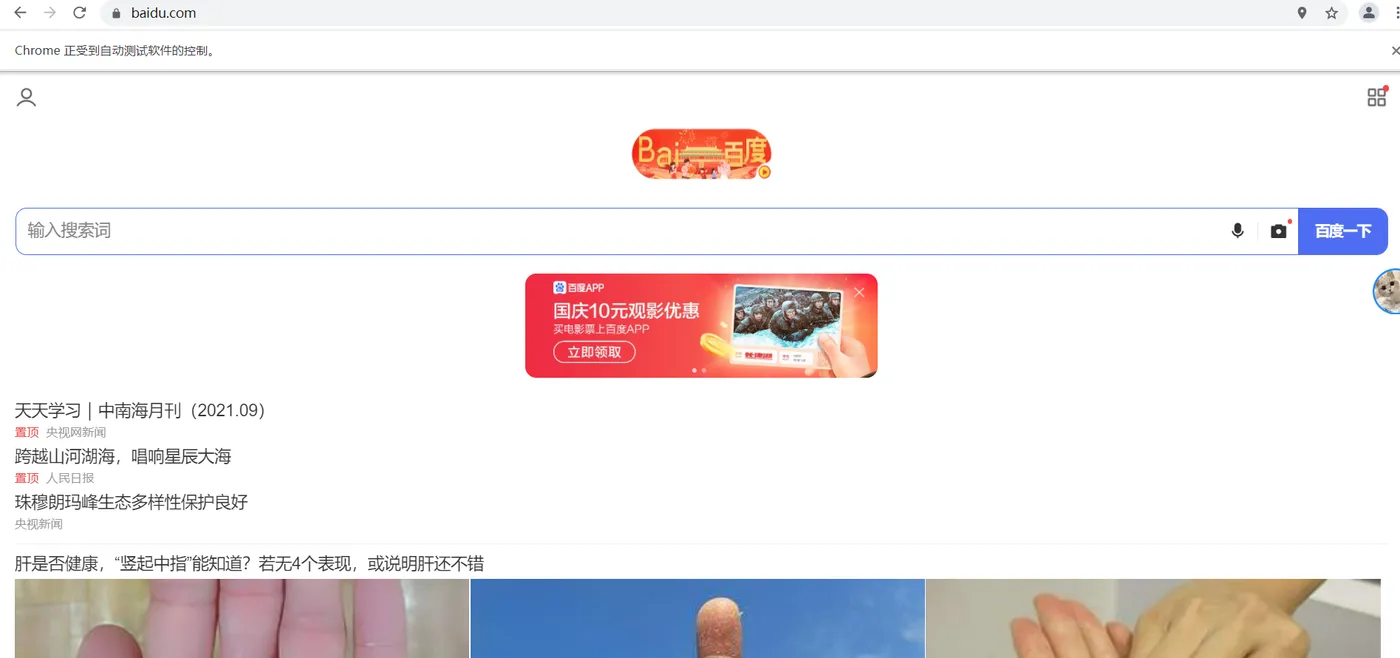
2.8 隐藏【受到自动化测试软件的控制】提示

通过该配置项可以隐藏上图的提示
chrome_options.add_experimental_option('excludeSwitches', ['enable-automation'])
2.9 指定浏览器大小
下面的代码会启动一个宽100,长1000的浏览器
chrome_options.add_argument(f'--window-size={100},{1000}')
2.10 指定浏览器位置
下面的代码会启动一个左边距为100,上边距为200的浏览器
chrome_options.add_argument(f'--window-position={100},{200}')
2.11 指定浏览器启动语言
有时候开启浏览器需要特别的语言版本,如果未进行配置则启动的是系统语言对应的浏览器,我们的被测网站如果是英文的,但系统是中文的,开启的浏览器就是中文的,提交的某些数据按照zh_CN.UTF-8的格式提交了,导致数据报错,那么我们就需要设置浏览器启动语言。
chrome_options.add_argument('lang=en-us')
2.12 更换浏览器请求头
有时候需要模拟手机访问某些页面的时候,可以通过配置user-agent项来实现
下面的代码会将浏览器模拟为安卓手机访问
user_ag = 'MQQBrowser/26 Mozilla/5.0 (Linux; U; Android 7.3.7; zh-cn; MB200 Build/GRJ22;CyanogenMod-7) ' \
              'AppleWebKit/533.1 (KHTML, like Gecko) Version/4.0 Mobile Safari/533.1 '
chrome_options.add_argument('user-agent=%s' % user_agent)
执行效果
2.13 设置浏览器代理
chrome_options.add_argument('--proxy-server=你的代理ip地址')
2.14 使用配置
下面的代码会【最大化窗口】且【不加载图片】的启动一个浏览器:
from selenium import webdriver
chrome_options = webdriver.ChromeOptions()
chrome_options.add_argument('--start-maximized')
chrome_options.add_argument('blink-settings=imagesEnabled=false')
browser = webdriver.Chrome(options=chrome_options)
3. Webdriver常用操作
3.1 获取浏览器名称
browser.name
3.2 最大化浏览器窗口
browser.maximize_window()
3.3 最小化浏览器窗口(Selenium4支持)
browser.minimize_window()
3.4 全屏窗口
类似浏览器中按下【F11】
browser.fullscreen_window()
3.5 访问指定网址
browser.get("https://www.baidu.com") #访问百度
3.6 获取当前页url
browser.current_url
3.7 获取当前页的title
browser.title
3.8 获取当前页窗口句柄
browser.current_window_handle
3.9 截屏当前窗口
browser.save_screenshot('test.png') #截取当前窗口并命名为`test.png`保存
3.10 刷新
browser.refresh()
3.11 前进(浏览器的【前进】按钮)
browser.forward()
3.12 后退(浏览器的【后退】按钮)
browser.back()
3.13 设置浏览器大小
设置浏览器宽为480,高为800
browser.set_window_size(480, 800)
3.14 设置浏览器位置
设置浏览器宽为480,高为800
browser.set_window_position(480, 800)
3.15 获取浏览器大小
设置浏览器宽为480,高为800
browser.get_window_size(480, 800)
3.16 获取浏览器位置
设置浏览器宽为480,高为800
browser.get_window_position(480, 800)
3.17 执行js脚本
如果需要进行页面滑动(模拟鼠标滚轮操作)可以通过执行js脚本实现
例如滑动到'//*[@id="asideHotArticle"]/h3'元素:
target
3.18 切换窗口
有多个窗口时,可以通过下面的方法进行切换才能够顺利的进行定位
browser.switch_to.window(browser.window_handles[1])
3.19 切换iframe
页面中的iframe弹窗,需要使用下面的代码切换才能够顺利的进行定位
iframe = browser.find_element(By.CSS_SELECTOR, "#modal > iframe")
# 切换到iframe
browser.switch_to.frame(iframe)
如果iframe有明确的id则可以直接这样写
driver.switch_to.frame('appIframe-product')
3.20 离开iframe
离开iframe,回到默认页面
browser.switch_to.default_content()
3.21 关闭当前窗口
有多个页面的时候,只会关闭当前所在页面
browser.close()
3.22 退出浏览器
会直接关闭浏览器,所有页面都将关闭
browser.quit()
四、总结
实际上webdriver的操作还有很多,比如远程控制项的配置,cookie相关配置等,但都不常用,掌握这些些已经足够了!