scrapy 请求继承体系
Request
  |-- FormRequest
通过以下请求测试
POST: https://httpbin.org/post
get请求
方式:通过Request 发送
import json
from scrapy import Spider, Request, cmdline
class SpiderRequest(Spider):
    name = "spider_request"
    def start_requests(self):
        url = "https://httpbin.org/get?name=tom"
        yield Request(url, body=json.dumps({"age": "23"}))
    def parse(self, response):
        print(response.text)
if __name__ == '__main__':
    cmdline.execute("scrapy crawl spider_request".split())
服务端收到url链接中的参数name,而没有收到body里边的参数age
"args": {
    "name": "tom"
  },
post请求
方式一:通过FormRequest 发送
from scrapy import Spider, cmdline, FormRequest
class SpiderFormData(Spider):
    name = "spider_form_data"
    def start_requests(self):
        url = "https://httpbin.org/post"
        yield FormRequest(url, formdata={"name": "Tom"})
    def parse(self, response):
        print(response.text)
if __name__ == '__main__':
    cmdline.execute("scrapy crawl spider_form_data".split())
服务器接收到参数
"form": {
    "name": "Tom"
  },
而且headers里边有一个参数
"headers": {
    "Content-Type": "application/x-www-form-urlencoded",
  },
方式二:通过Request发送
需要添加参数 method="POST"
import json
from scrapy import Spider, Request, cmdline
class SpiderPost(Spider):
    name = "spider_post"
    def start_requests(self):
        url = "https://httpbin.org/post"
        yield Request(url, method="POST", body=json.dumps({"name": "Tom"}))
    def parse(self, response):
        print(response.text)
if __name__ == '__main__':
    cmdline.execute("scrapy crawl spider_post".split())
1、直接发送post请求,服务器端收到参数data,和json:
"data": "{\"name\": \"Tom\"}",
"form": {},
"json": {
    "name": "Tom"
  },
2、如果添加headers参数:
"headers": {
    "Content-Type": "application/x-www-form-urlencoded",
  },
服务器收到参数,form将接收到参数,也就是FormRequest的提交方式
"data": "",
"form": {
    "{\"name\": \"Tom\"}": ""
  },
"json": null,
3、如果添加headers参数:
"headers": {
    "Content-Type": "application/json",
  },
服务器端将收到data 和json 参数,和第一个情形一样,不过有时候不加这个请求头参数获取,会请求错误
"data": "{\"name\": \"Tom\"}",
"form": {},
"json": {
    "name": "Tom"
  },
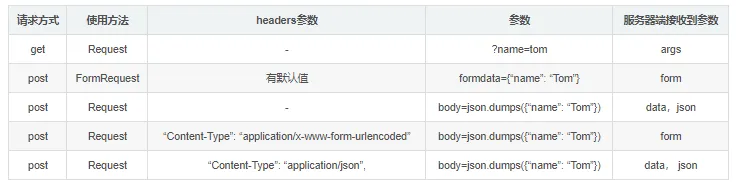
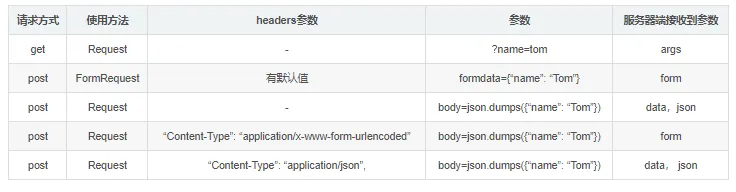
总结
参考
Scrapy Requests and Responses