

通义妙谈 -图像模型玩转更多可能!通义万相新升级 一个包罗万象的“应用广场”!
“买家秀”秒变“卖家秀”,AI一键更换商品模特,虚拟模特功能等你解锁🔒 “小草图”秒变“大制作”,AI涂鸦作画让你的草图“一秒”成画🖌️ “2-4图”生成“个人写真”,AI虚拟分身在线创作,在家也是巴厘岛🏖️ 阿里云的微博视频 全网征集灵魂画手,几笔生成精美大作,精美礼物等你来拿


通义妙谈-阿里云图像生成大模型通义万相,Composer算法实现绘图精准可控
通义妙谈-阿里云图像生成大模型通义万相,Composer算法实现绘图精准可控
facechain人物写真生成工业级开源
facechain人物写真应用自8月11日开源了第一版证件照生成后。目前在github(GitHub - modelscope/facechain: FaceChain is a deep-learning toolchain for generating your Digital-Twin.)上已有5.7K的star,论文链接:FaceChain: A Playground for Identity-Preserving Portrait Generation:https://arxiv.org/abs/2308.14256。

【IJCAI 2023】流感知优化之 DAMO-StreamNet 论文解读
传统视频目标检测(Video Object Detection, VOD)是离线(offline)的检测任务,即仅考虑算法的检测精度,未考虑算法的延时。流感知(Streaming Perception)任务作为VOD的一个细分方向,采用流平均精度(Streaming Average Precision, sAP)指标,衡量算法的在线(online)检测能力,即同时衡量算法的精度和延时。本文针对现有的流感知工作在训练方式和模型感受野两方面的不足,提出了DAMO-StreamNet,在保证算法实时性的前提下,实现了SOTA的性能。

ChatGPT最强专业学习资料集锦
本文旨在整理一份可供参考和学习的专业ChatGPT相关资料,包括ChatGPT相关论文、Github项目、以及当前市场上出现的ChatGPT相关产品等。
【阿里云OpenVI-人脸感知理解系列之人脸识别】基于Transformer的人脸识别新框架TransFace ICCV-2023论文深入解读
本文介绍 阿里云开放视觉智能团队 被计算机视觉顶级国际会议ICCV 2023接收的论文 "TransFace: Calibrating Transformer Training for Face Recognition from a Data-Centric Perspective"。TransFace旨在探索ViT在人脸识别任务上表现不佳的原因,并从data-centric的角度去提升ViT在人脸识别任务上的性能。

【阿里云OpenVI-视觉生产系列之图片上色】照片真实感上色算法DDColor ICCV2023论文深入解读
图像上色是老照片修复的一个关键步骤,本文介绍发表在 ICCV 2023 上的最新上色论文 DDColor

AIGC视频生成/编辑技术调研报告
随着图像生成领域的研究飞速发展,基于diffusion的生成式模型取得效果上的大突破。在图像生成/编辑产品大爆发的今天,视频生成/编辑技术也引起了学术界和产业界的高度关注。该分享主要介绍视频生成/编辑的研究现状,包括不同技术路线的优劣势,以及该领域当下面临的核心问题与挑战。
AIGC玩转卡通化技术实践
伴随着持续不断的AIGC浪潮,越来越多的AI生成玩法正在被广大爱好者定义和提出,图像卡通化(动漫化)基于其还原效果高,风格种类丰富等特点而备受青睐。早在几年前,伴随着GAN网络的兴起,卡通化就曾经风靡一时。而今,伴随着AIGC技术的兴起和不断发展,扩散生成模型为卡通化风格和提供了更多的创意和生成的可能性。本文就将详细介绍达摩院开放视觉团队的卡通化技术实践。
AIGC图像分辨率太低?快来试试像素感知扩散超分模型,你想要的细节都在这里
阿里巴巴最新自研的像素感知扩散超分模型已经开源,它把扩散模型强大的生成能力和像素级控制能力相结合,能够适应从老照片修复到AIGC图像超分的各种图像增强任务和各种图像风格,并且能够控制生成强度和增强风格。这项技术的直接应用之一是AIGC图像的后处理增强和二次生成,能够带来可观的效果提升。
OpenVI-感知理解系列之GAP骨骼点动作识别 ICCV23顶会论文深入解读
本文介绍了ICCV23中稿论文 GAP: Generative Action Description Prompts for Skeleton-based Action Recognition
本地生活技术雷达——生成式AI(Generative AI)在阿里本地生活的应用与思考
本地生活技术雷达是由本地生活技术中心战略管理&PMO团队开展的,定期扫描和评估新兴技术的战略研究工作。目的是对技术趋势进行前瞻性预判,提出新技术布局建议,在技术驱动业务创新和业务增长、践行社会责任等方面有一些实质性探索。 本篇尝试探讨 1)理解AI范式——从分析型(Analytical AI)到生成式(Generative AI)的拐点在2022年,其对人类社会以及商业模式的长期影响; 2)生成式AI(文生文、文生图、图生图等)在本地业务目前场景的应用和未来的方向。 欢迎技术、产品、运营、战略、管理层、国内国际等各种视角的指点和碰撞!
AI漫剧角色一致性:人物三视图和多参考图组合的提示词怎么写
人物三视图、四视图的提示词怎么写,怎么把脸、身材、衣服、道具分开做再用多张参考图组合成角色设定卡,再加一张姿势图出成品画面。每一步都附提示词和结果。
毫秒级宠物身份识别:端侧模型压缩与嵌入式性能调优方案
针对智能宠物设备普遍存在识别不准、云端方案时延高、隐私风险突出等痛点,本文围绕宠物识别端侧 AI 展开系统性技术解析。结合 MobileNetV3 轻量化基线,介绍剪枝、量化、知识蒸馏等模型压缩手段,并针对宠物毛发多变、姿态复杂、易遮挡等特点,配套定制化数据增强、外观–行为特征融合策略;同时从 MCU、嵌入式 SoC 硬件选型、NPU 加速、动态功耗管理等维度给出工程调优方案。以智能宠物门、智能猫砂盆为典型落地场景,阐述离线本地特征比对、活体校验、多传感器交叉校验等实现思路。最后分析多模态融合、联邦学习等技术方向,以及小样本、特征漂移、功耗与精度权衡等现存挑战。
AI局部改图:遮罩为什么容易出黑块,画圈标注加提示词怎么写
GPT Image这类模型的遮罩容易出黑块,改动也会越过边界。本文用一张客厅图片实测另一种做法:在图上画圈、画框做标注,再用一句提示词说明改成什么,并总结提示词的写法。
复杂居家场景下的多宠识别与健康感知:生物特征融合、时序追踪及智能硬件协同
多宠家庭场景下,传统监控设备仅能采集视频画面,难以区分外观相近的宠物个体,容易造成行为数据归属混乱、健康事件错配、联动设备误触发等问题。当前行业已形成一类面向边缘硬件的多模态宠物视觉感知技术路线,通过融合犬只鼻纹、面部关键点等生物特征,结合肢体姿态时序追踪、多帧特征融合等策略,在暗光、局部遮挡、宠物体态随时间变化等复杂居家条件下完成个体识别。这类系统普遍采用端云协同架构,将基础检测、身份比对、轨迹追踪部署在本地设备,在保障实时响应的同时降低原始图像上传带来的隐私风险。
一张图片生成GIF的四种技术路线:裁剪拼帧、序列帧切分、多帧生成模型、视频模型转码
把一张静态图片变成GIF,关键是帧从哪里来。本文按帧的来源分成四条路线:裁剪拼帧、序列帧切分、多帧生成模型直接输出GIF、视频模型生成后转GIF,说明各自的原理、关键参数和适用范围,并附ffmpeg转码参数。
解决密集鸟群统计难题:检测跟踪与密度估计的自适应融合方案
鸟类AI计数面临密集遮挡、小目标漏检与高算力瓶颈。主流方案分两类:目标检测跟踪(YOLO+ByteTrack)适合稀疏场景,可获个体轨迹但易漏检;密度估计(如CSRNet)直接回归密度图,高效精准统计大规模集群,已成为高密度鸟群计数的首选技术。(239字)
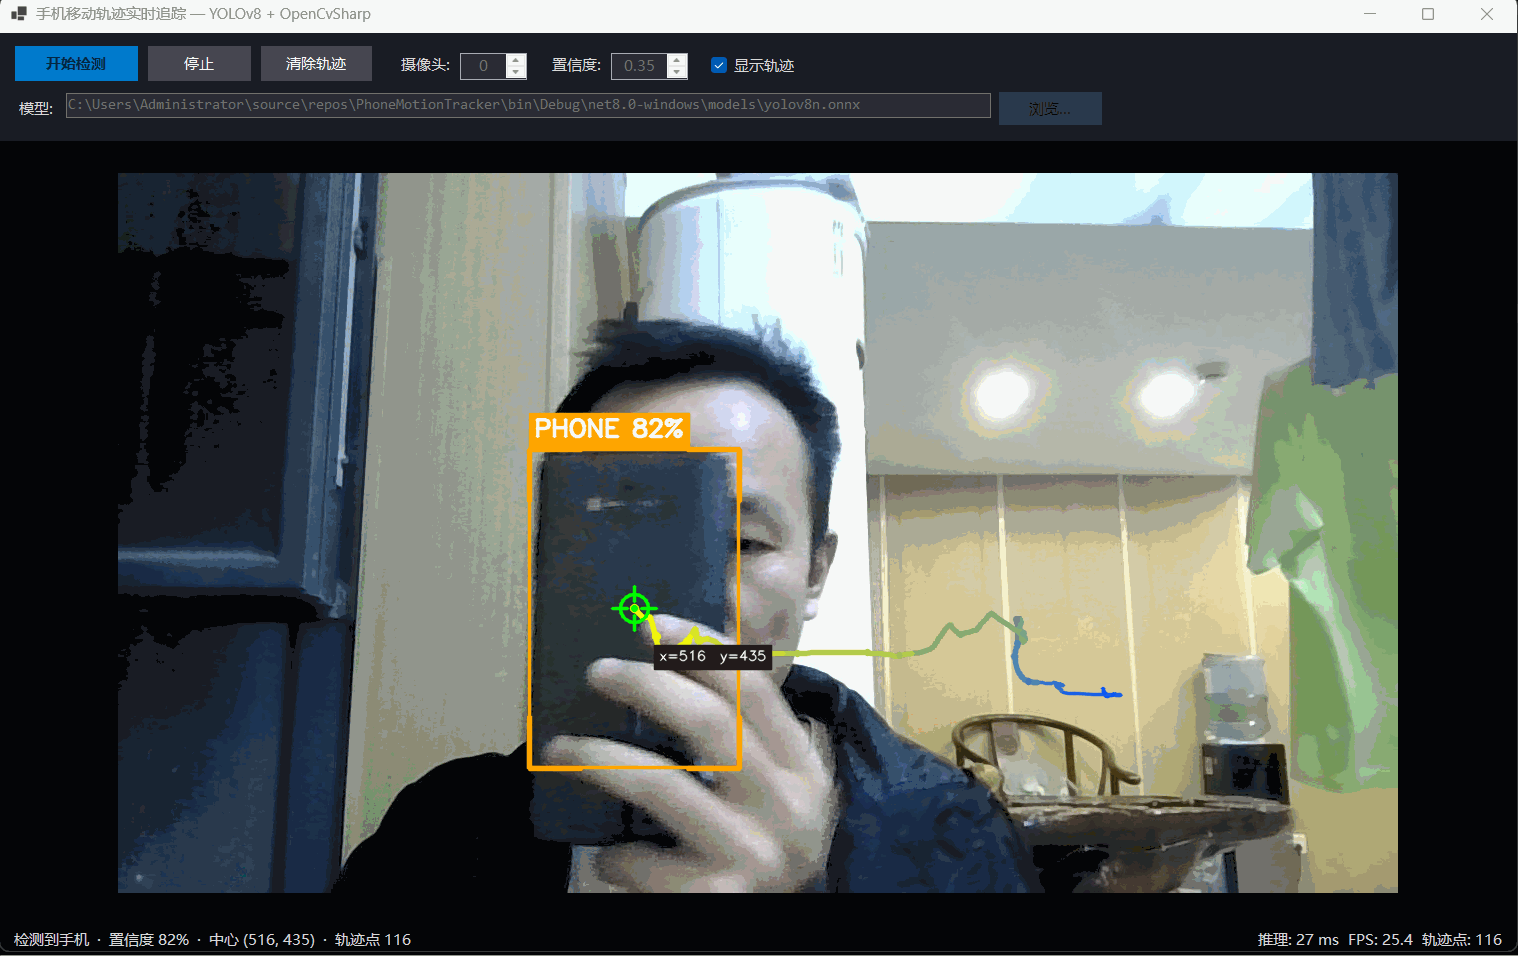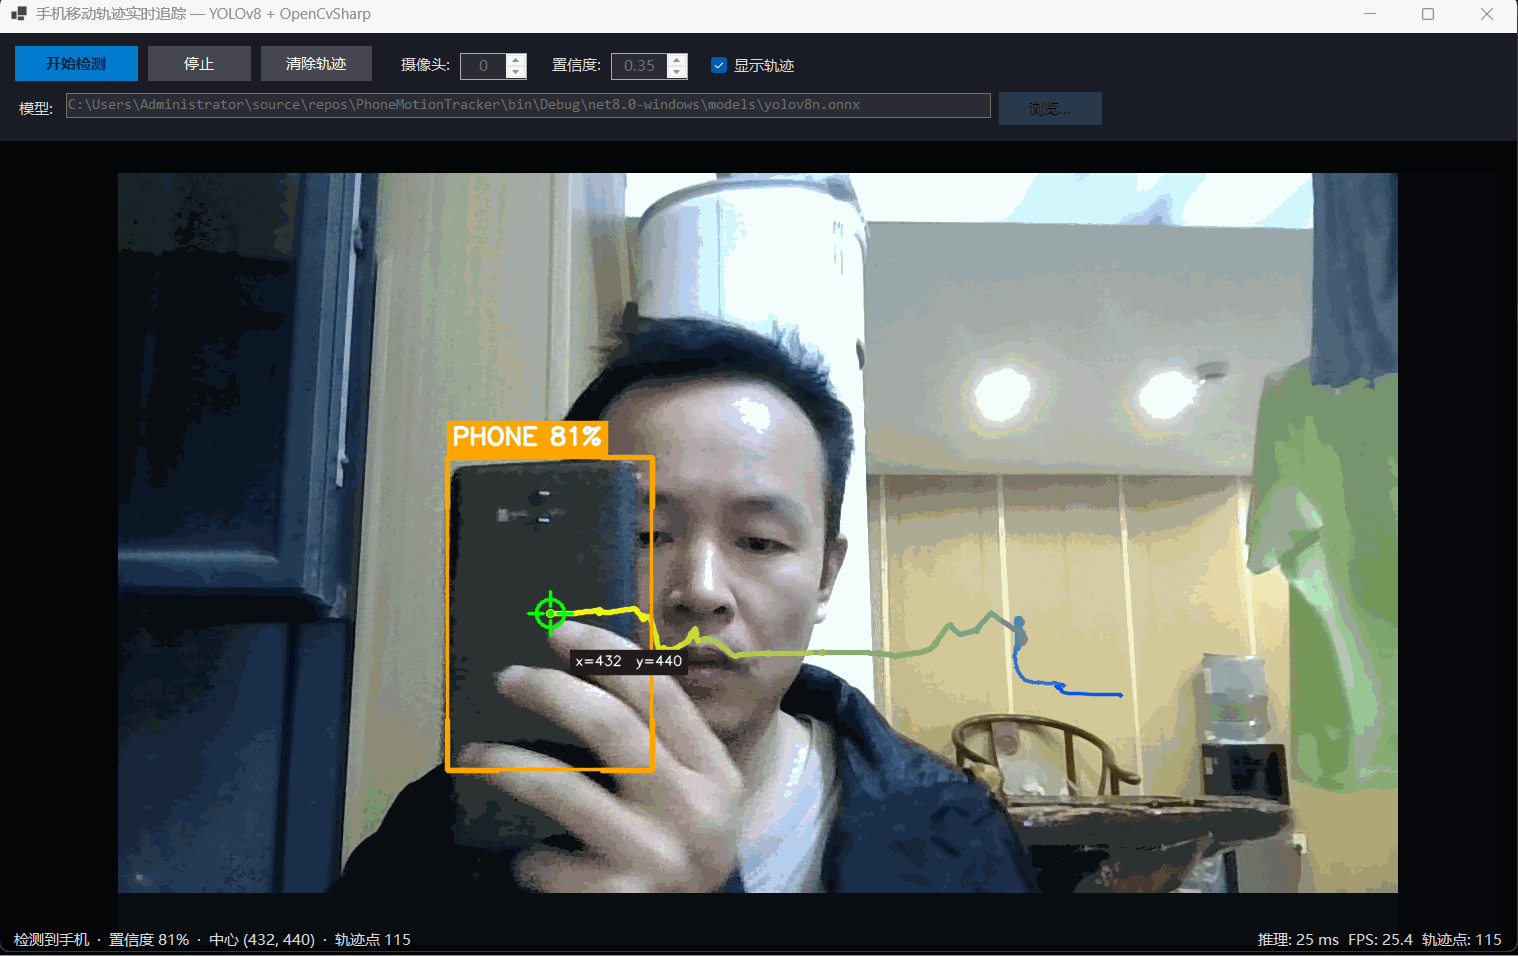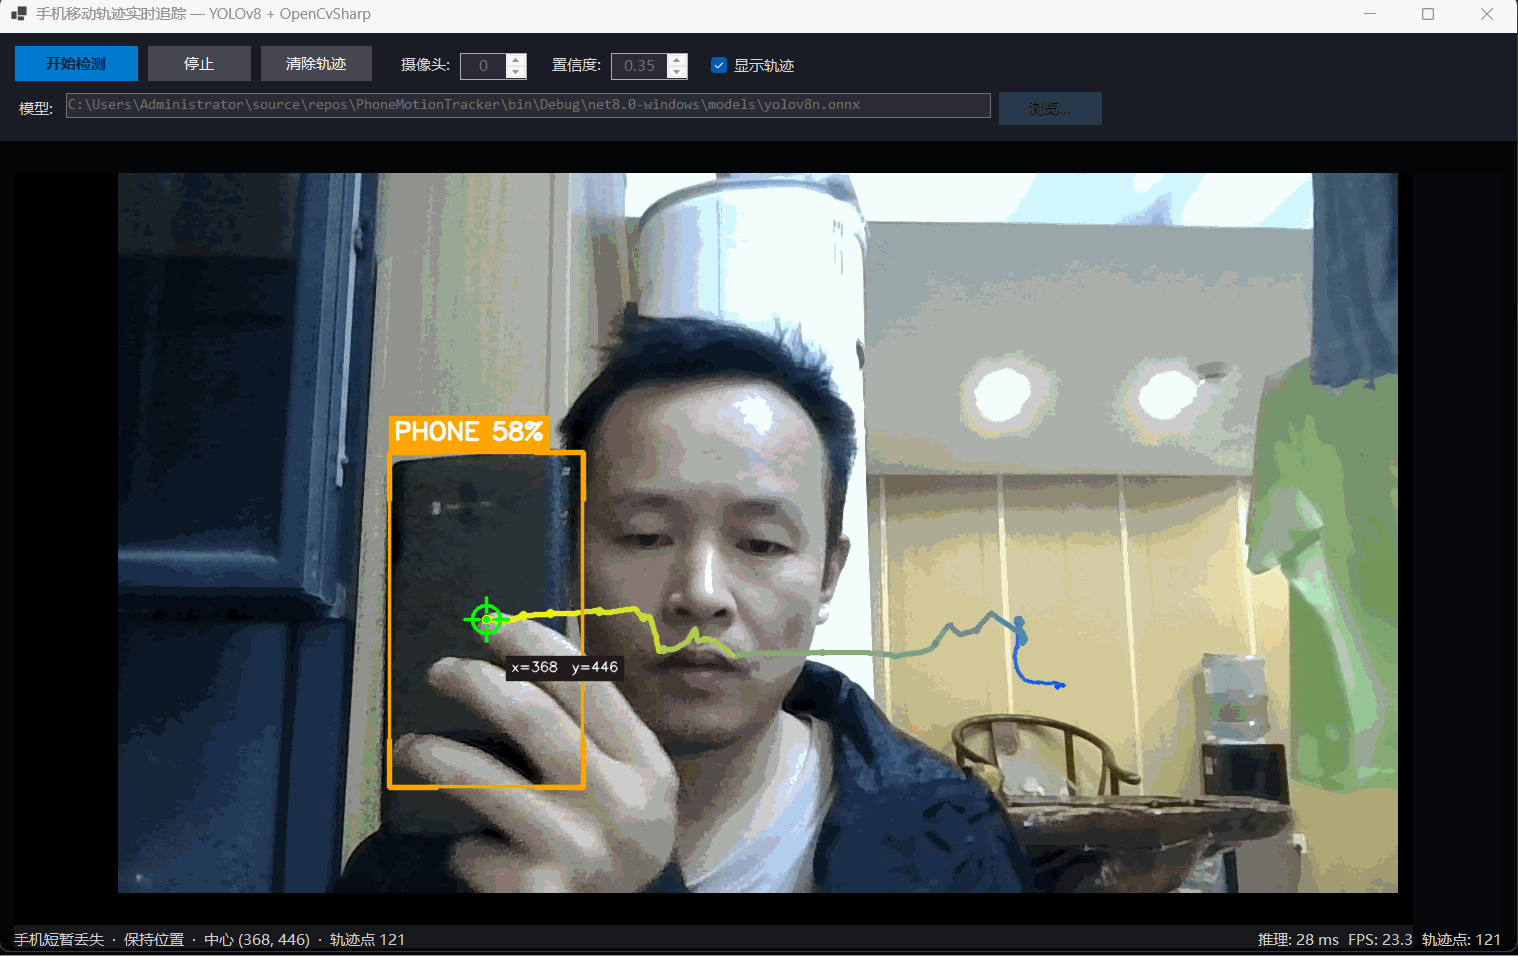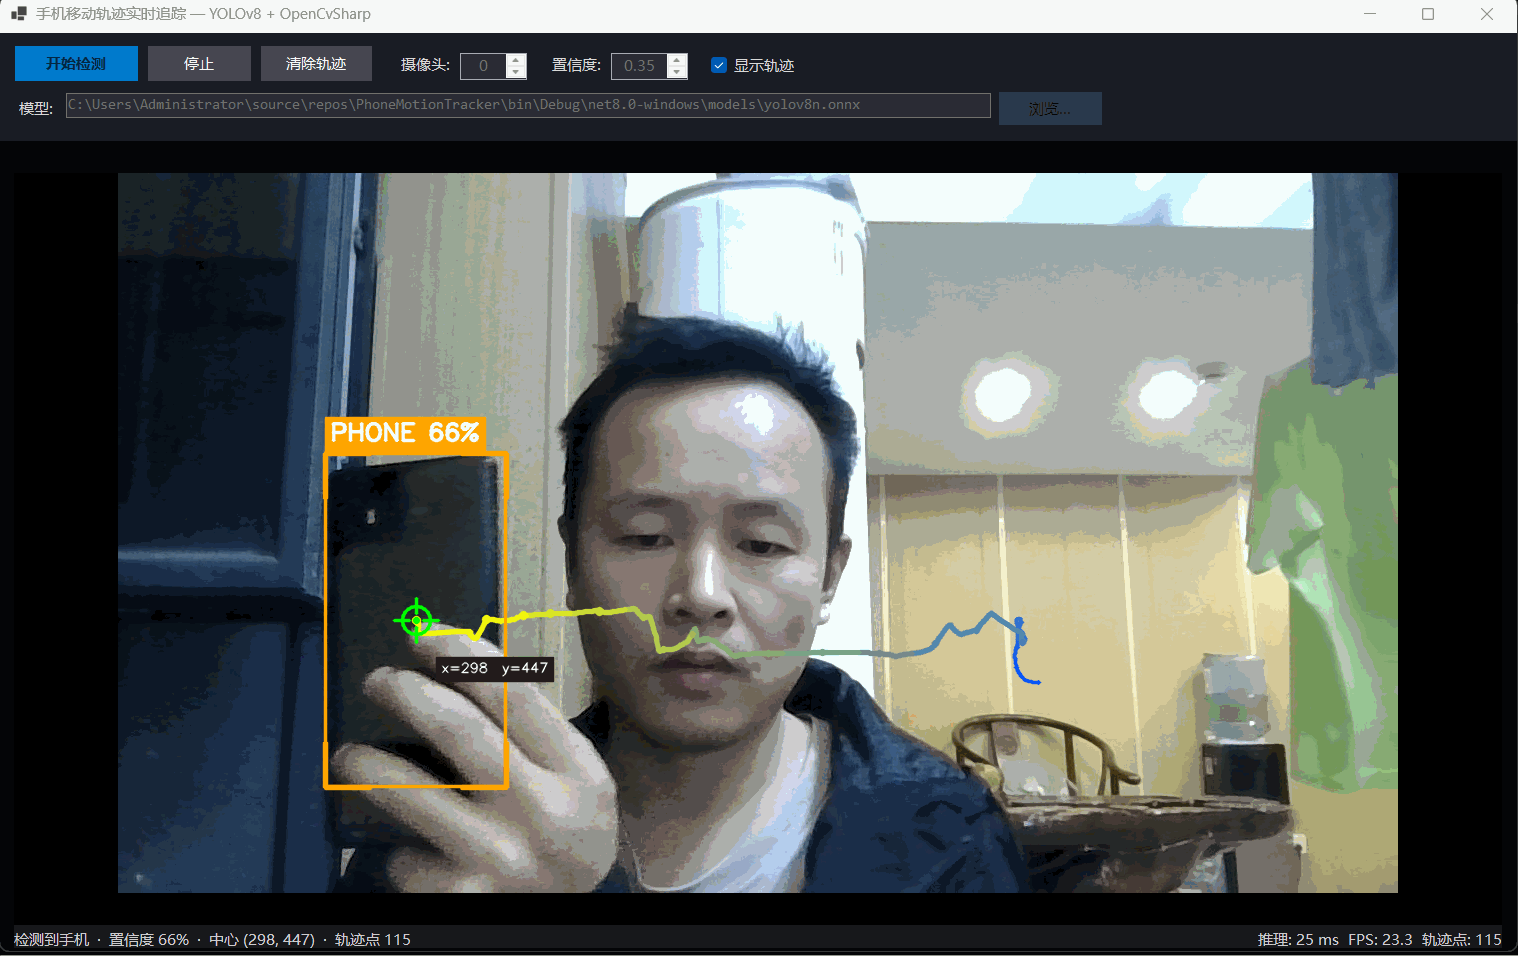
c# + YOLODotNet+OpenCVSharp 实现物品轨迹追踪
调用电脑摄像头,实时检测画面中的手机,标记手机中心位置,并绘制最近 6 秒的移动轨迹。
端侧AI鸟类识别出海工程建议:规则解耦、区域物种包与合规预检实现
本文围绕合规红线、本地化适配、落地流程展开,介绍将合规策略从固件解耦、独立热更新的端侧预检架构,以及区域物种扩展包、保护拦截率专项验收、端侧轻量化推理等工程方案,为鸟类识别算法、观鸟智能硬件团队提供一套可复用的欧美出海合规与本地化落地路径。
用AI修老照片:一段提示词去划痕、上色,人脸不走样
老照片常见划痕、水渍、发黄,很多还是黑白的。这篇给出一段图生图修复提示词,讲清楚为什么这样写才能让人脸不走样,以及不同的照片各加哪一句。
GPT Image 2.6实测:静态图和2.5差不多,新加的GIF能做表情包
GPT Image 2.6和2.5用同样的提示词对比:静态图差别不大,带字的排版图2.6稍好;新加的GIF功能做表情包够用,但最多16帧,画面会抖。附几条用2.6做GIF的提示词技巧。
浏览器端视频转GIF的实现:canvas抽帧加gif.js编码,10组参数实测GIF体积
在浏览器里用canvas抽帧、gif.js编码,把视频转成GIF。介绍seek抽帧的实现和常见问题,并用同一段5秒视频实测10组参数的GIF体积。
核验留档技术方案:团队交接中的证据选择与复查约束
文件处理核验进入团队交接后,难点是让没有参与操作的人理解材料能说明什么。本文按协作需求、证据选择、记录字段与复查约束,整理一套留档方案,说明页面截图、HAR与处理条件各自的边界;未包含实测数据。
从零实现中文车牌识别:YOLOv8 + LPRNet 训练、ONNX 部署与云端 API 接入实践
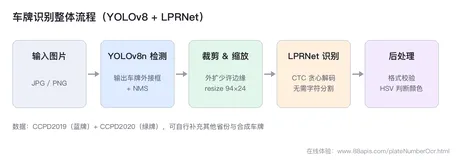
本文基于开源的 YOLOv8 和 LPRNet,完整实现一套中文车牌检测与识别流程,内容包括 CCPD 数据集处理、检测模型训练、CTC 字符识别原理、ONNX 推理部署和车牌颜色判断,并对比了自建模型与调用云市场 API 两种落地方式,给出各自适用的场景。文中代码均可直接运行。
AI生成口播数字人越来越方便了
阿里数字人服务:输入文案/录音/照片/PPT,秒生成开口说话的数字人视频。支持克隆形象、照片驱动、PPT讲解三模式,自选模板、背景、字幕与方言,按分钟计费(0.5元起)。所有参数均源自真实技术限制,非宣传口径。(240字)
宠物面部识别鲁棒性优化:多策略融合与边缘部署实践
本文探讨智慧养宠中宠物面部识别的鲁棒性提升策略,聚焦非合作场景下的光照多变、姿态随意等核心挑战。系统梳理数据增强、光照归一化、姿态校正、模型优化、多任务学习等关键技术路径,兼顾精度与边缘部署需求,助力实现“任意角度、任意光照下精准识宠”。
实战复盘:用AI做AI漫剧亏损归因分析,从扒数据到出可视化报告全流程
这是一份用AI完成的AI漫剧亏损归因实战报告:涵盖数据采集、建模分析(Python量化回本门槛)、五重挤压归因、多载体交付(HTML/PDF/Word)及6条可复用运营规律,全程开源可验证。(239字)
技术方案:从HAR线索还原端侧推理会话边界
收到一份HAR记录时,如何还原端侧推理会话的边界?本文按请求方向、响应体积、Timing、Mime Type以及Request Body、Response Body是否可见逐项说明能判断什么、不能判断什么,区分模型资源与用户文件流向,并说明缓存推断需要的处理条件。相关方法为建议流程,未包含实测数据。
高效率办公PDF批量处理:批量合并多文件夹中相同文件名为独立PDF,咕嘎同名文件合并系统应用案例
咕嘎批量合并系统专为办公归档设计,支持跨多级文件夹扫描PDF/图片,按文件名完全相同或关键字自动分组,一键合并为单个PDF。适配合同、发票、课件、图纸等场景,效率提升10倍以上。
想把几个动作片段接起来给 AI 参考,怎么做?
先把各段统一到相同尺寸、帧率和像素格式,再按顺序拼接,核对接点后提取控制素材。本文给出 ffmpeg 命令、时间表与合成素材 CPU 验证。
没有网络的电脑,怎样准备动作提取环境?
先按目标机器的系统、架构、Python 和运行设备准备完整 wheelhouse、两份 ONNX 模型、ffmpeg 与 SHA 清单,再断网安装并分别验收依赖、模型加载和动作输出。本文为固定版本的准备方案。
茶叶采摘点识别 嫩芽图像识别 机器人采茶点识别 AI图像数据集
# 茶叶实例分割数据集 | 项目 | 详情 | | -------- | ---------------------- | | 任务类型 | 实例分割 | | 图片总量 | 13000张 | | 分类数量 | 1类 | | 标注格式 | YOLO txt | |
动作参考换了设置,怎样查清结果为什么不同?
把参考片、提取配置、原始深度、控制片与生成请求关联归档,再用只改一个因素的对照追查结果差异。提供 ReShot 0.5.0 命令与实验记录模板。
Windows 下 YOLO26 的 TensorRT C++ 部署
本文详解Windows下基于TensorRT 10.16的YOLO26 C++部署全流程:涵盖VS2022/CUDA 12.9/OpenCV 4.8.1环境搭建、FP32/FP16/INT8模型导出与Engine序列化、命令行推理及自训练模型部署。实测单帧推理仅约1.4ms,速度较ultralytics Python提升14倍。
给AI视频准备的动作参考抖动、慢半拍,怎么办?
给 AI 视频准备动作参考时,先用同一片段的稳定版与原始版区分关节抖动、动作跟随迟滞和显隐闪烁。本文给出 ReShot 0.5.0 对照命令、动作时点记录表与已有实验的正确读法。
做AI视频时,线稿太乱、主体看不清怎么办?
AI视频线稿杂乱或主体轮廓断裂时,可固定同一参考片和输出设置,分别调整Canny阈值,记录轮廓、干扰线与播放稳定性,选出适合交接的控制素材。
怎么把图片一键转成视频?完整流程与可复用结论
本文详解图片一键转视频的完整方法论:覆盖5大高频场景(活动预热、商品展示、内容复用等),提炼可复用的“五步流程”与“七项质检清单”,总结5条核心结论——强调素材质量决定上限、动效宜缓不宜快、先定渠道再定参数。无需剪辑软件,AI赋能实现“一句话生成动态视频”,大幅提升轻量视频生产效率。(239字)
保洁有没有在 “真干活”?YOLO 行为检测让清洁过程看得见、算得清
该方案基于YOLO模型,专注识别保洁人员“是否正在清洁”这一核心状态(如拖地、扫地、擦拭等),将监控画面转化为可统计的作业时长、频次等客观数据,助力物业实现从“人盯人”到“AI盯行为”的精细化、可追溯管理。
给AI视频准备动作参考时,手脚为什么时有时无?
给 AI 视频提取动作参考时,骨架手脚忽隐忽现应先查原片遮挡、人物检测与关节分数,再比较默认稳定和原始输出。本文给出 ReShot 0.5.0 的对照命令、关键点观察方法及已有实验的适用范围。