
【玩转数据系列十】利用阿里云机器学习在深度学习框架下实现智能图片分类
伴随着今日阿里云机器学习PAI在云栖大会的重磅发布,快来感受下人工智能的魅力。 一、背景 随着互联网的发展,产生了大量的图片以及语音数据,如何对这部分非结构化数据行之有效的利用起来,一直是困扰数据挖掘工程师的一到难题。
大数据环境下该如何优雅地设计数据分层
发个牢骚,搞大数据的也得建设数据仓库吧。而且不管是传统行业还是现在的互联网公司,都需要对数据仓库有一定的重视,而不是谈一句自己是搞大数据的就很厉害了。数据仓库更多代表的是一种对数据的管理和使用的方式,它是一整套包括了etl、调度、建模在内的完整的理论体系。
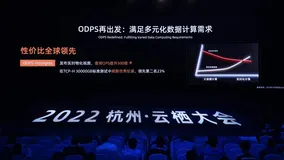
odps是什么?
ODPS(Open Data Processing Service),原是阿里云从 09年开始自研的大规模批量计算引擎,2016 年更名为MaxCompute。2022云栖大会上,阿里云ODPS全新升级为一体化大数据平台,存储、调度、元数据一体化融合 ,从 Processing 升级为 Platform,即 Open Data Platform and Service。提供了离线计算、实时交互式分析、机器学习等可扩展的智能计算引擎,满足用户多元化数据计算需求。
ajax请求总是不成功?浏览器的同源策略和跨域问题详解
XMLHttpRequest cannot load http://oldwang.com/isdad. No 'Access-Control-Allow-Origin' header is present on the requested resource. Origin 'http://xiao
【技术实验】mysql准实时同步数据到Elasticsearch
Elasticsearch作为大数据场景下搜索和分析的引擎,广泛应用于实时数据分析等场景。本文作者梳理了从MySQL准实时同步数据到Elasticsearch的实操步骤,帮助开发者理解和快速上手。
分布式快照算法: Chandy-Lamport
Spark 的 Structured Streaming 的 Continuous Processing Mode 的容错处理使用了分布式快照(Distributed Snapshot)算法 Chandy-Lamport 算法,那么分布式快照算法可以用来解决什么问题呢?
MaxCompute执行作业慢的原因排查
大家在平时开发过程中经常遇到作业(SQL、MR等)执行慢的原因,今天带大家一起学习自排查方法。 1、wait wait ,job querying 遇到这个提示,就是资源出现了排队,如果你是后付费用户,那就是整个后付费的共享池已经没有富余的资源了,要等前一个作业处理完。
阿里云MaxCompute(大数据)公开数据集---带你玩转人工智能
目前阿里云大数据产品已经免费向全部用户开放了多种公用数据集。开放的数据类别包括:股票价格数据,房产信息,影视及其票房数据。
优酷背后的大数据秘密
大家好,我是门德亮,现在在优酷数据中台做数据相关的事情。很荣幸,我正好见证了优酷从没有MaxCompute到有的这样一个历程,因为刚刚好我就是入职优酷差不多5年的时间,我们正好是在快到5年的时候,去做了从Hadoop到MaxCompute的这样一个升级。
吴刚专访--大数据和 MaxCompute 技术和故事
2019大数据技术公开课第一季《技术人生专访》来袭,本季将带领开发者们探讨大数据技术,分享不同国家的工作体验。本文整理自阿里巴巴计算平台事业部高级技术专家吴刚的专访,将为大家介绍Apache ORC开源项目、主流的开源列存格式ORC和Parquet的区别以及MaxCompute选择ORC的原因。
2017杭州云栖大会FAQ(持续更新中)
2017杭州云栖大会将于10月11-14日在杭州云栖小镇举办,作为全球最具影响力的科技展会之一,今年的云栖大会规模更大,内容也更丰富。为了帮助大家解决报名、参会中的一些问题,小编专门整理了下大会相关的FAQ,供大家参考。
Kibana:数据分析的可视化利器
阿里云Elastisearch集成了可视化工具Kibana,用户可以使用Kibana的开发工具便捷的查询和分析存储在Elastisearch中的数据。除了柱状图、线状图、饼图、环形图等经典可视化功能外,还拥有地理位置分析、数据图谱分析、时序数据分析等高级功能。
Python+大数据计算平台,PyODPS架构手把手教你搭建
在2016年10月的云栖社区在线培训上,来自阿里云大数据事业部的秦续业分享了《双剑合壁——Python和大数据计算平台的结合实战》。他主要介绍了数据分析和机器学习的方法、DataFrame整体架构以及基础API、前端、后端、机器学习的具体实现方法。
独家专访阿里集团副总裁贾扬清:我为什么选择加入阿里巴巴?
在这次访谈中,贾扬清向我们透露了他加入阿里的原因,并对他目前在阿里主要负责的工作做了详细说明,他不仅回顾了过去 6 年 AI 框架领域发生的变化,也分享了自己对于 AI 领域现状的观察和对未来发展的思考。结合自己的经验,贾扬清也给出了一些针对 AI 方向选择和个人职业发展的建议,对于 AI 从业者来
【玩转数据系列六】文本分析算法实现新闻自动分类
新闻分类是文本挖掘领域较为常见的场景。目前很多媒体或是内容生产商对于新闻这种文本的分类常常采用人肉打标的方式,消耗了大量的人力资源。本文尝试通过智能的文本挖掘算法对于新闻文本进行分类。无需任何人肉打标,完全由机器智能化实现。
【大数据干货】轻松处理每天2TB的日志数据,支撑运营团队进行大数据分析挖掘,随时洞察用户个性化需求。
“用户每天产生的日志量大约在2TB。我们需要将这些海量的数据导入云端,然后分天、分小时的展开数据分析作业,分析结果再导入数据库和报表系统,最终展示在运营人员面前。”墨迹天气运维部经理章汉龙介绍,整个过程中数据量庞大,且计算复杂,这对云平台的大数据能力、生态完整性和开放性提
【转载】时隔一年多,我又用起了 Superset
去年 6 月份在流利说提离职后,leader 问我为什么要走。我说,流利说有很健全的数据处理基础设施,但这不是所有的公司都会有的条件,所以我想看看在一个基建不全的创业公司我是否也可以像现在一样做的好。
品《阿里巴巴大数据实践-大数据之路》一书(上)
7月有人推荐阿里巴巴刚出的这本书《阿里巴巴大数据实践-大数据之路》,到亚马逊一看才是预售状态,拍下直到8月才拿到。 翻看目录一看,欢喜的很,正好出差两天就带在身边,由于在机场滞留超过12个小时,就把它读完了。
干货:解码OneData,阿里的数仓之路。
据IDC报告,预计到2020年全球数据总量将超过40ZB(相当于4万亿GB),这一数据量是2013年的10倍。正在“爆炸式”增长的数据的潜在巨大价值正在被发掘,它有可能成为商业世界的“新能源”,变革我们的生产,影响我们生活。当我们面对如此庞大的数据之时,如果我们不能有序、有结构的进行分类组织
[大数据新手上路]“零基础”系列课程--如何将ECS上的Hadoop数据迁移到阿里云数加·MaxCompute
想用阿里云数加·大数据计算服务(MaxCompute),但是现在数据还在hadoop上,怎么办? 别烦恼,跟着我们走,来一次MaxCompute零基础数据迁移之旅~Let’s Go!
阿里云MaxCompute 2019-5月刊
5月MaxCompute新功能发布,精彩技术好文推荐,技术干货下载,6月重要活动抢先知道,尽在5月刊。
现代流式计算的基石:Google DataFlow
0. 引言 今天这篇继续讲流式计算。毫无疑问,Apache Flink 和 Apache Spark (Structured Streaming)现在是实时流计算领域的两个最火热的话题了。那么为什么要介绍 Google Dataflow 呢?Streaming Systems 这本书在分析 Fli...
OpenSearch:轻松构建大数据搜索服务
随着互联网数据规模的爆炸式增长,如何从海量的历史、实时 数据中快速获取有用信息,变得越来越具有挑战性。搜索是获取信息最高效的途径之一,因此也是各类网站、应用的基础标配功能。开发者想在自己的产品中实现搜索功能一般都是基于某个开源搜索系统(如ElasticSearch、Solr、Sphinx
如何使用Kafka Connect实现同步RDS binlog数据
本文介绍如何在E-MapReduce上使用Kafka Connect实现同步RDS binlog数据
大数据阿里云产品的简单介绍理解
很多人问,大数据是什么。一个时尚的技术名词,一个互联网时代的标志。给人高端大气上档次的感觉,很多公司不说自己有大数据都不好意思跟别人谈业务。那我就谈谈我的一些看法来结合阿里云的数加大数据产品比较粗俗的介绍下大数据到底是什么。
混合云模式下 MaxCompute + Hadoop 混搭大数据架构实践
2019杭州云栖大会大数据企业级服务专场,由斗鱼大数据高级专家张龙带来以 “混合云模式下 MaxCompute+Hadoop 混搭大数据架构实践” 为题的演讲。本文讲述了从 Apache Hadoop 阶段到 Cloudera CDH 阶段斗鱼大数据架构的发展历程。提出了上云过程中斗鱼遇到的问题和跳战,包括数据安全、数据同步以及迁移任务。概括了混合云模式给斗鱼带来资源效率更高和资源成本更低的变化。
搜索双链路实时计算体系@双11实战
该文章来自阿里巴巴技术协会(ATA)精选集 0. 前言 何为双链路实时计算体系?微观实时计算链路 a) 最细粒度商品/店铺/用户数据的实时 b) 底层模型的实时宏观实时计算链路 相比微观实时,宏观实时的对象粒度更粗,更上层 a) 以实时效果为目标,基于bandit learning的实
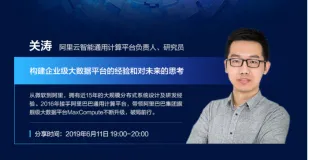
【内含分享PPT/视频/文章】阿里云MVP学院MaxCompute技术闭门会线上首播 | 2019大数据技术公开课第二季
数据的价值是解释业务还是预测业务?是支撑业务还是驱动业务?企业级计算服务的核心问题是什么?企业级计算平台要解决的核心问题是什么?商业和技术的平衡点在哪里? 一起直播学习,让数据真正驱动业务。
新版发布功能上线,新增「大屏快照」功能!
新版发布功能上线,新增「大屏快照」功能! 发布分享 链接设置 分享链接 打开「发布分享」按钮之后,会随机生成一个分享链接,此链接每次打开之后都会变更,上一次的分享链接随即失效且不能恢复到历史分享链接。
Spark in action on Kubernetes - Playground搭建与架构浅析
前言Spark是非常流行的大数据处理引擎,数据科学家们使用Spark以及相关生态的大数据套件完成了大量又丰富场景的数据分析与挖掘。Spark目前已经逐渐成为了业界在数据处理领域的行业标准。但是Spark本身的设计更偏向使用静态的资源管理,虽然Spark也支持了类似Yarn等动态的资源管理器,但是这些资源管理并不是面向动态的云基础设施而设计的,在速度、成本、效率等领域缺乏解决方案。
JindoFS解析 - 云上大数据高性能数据湖存储方案
JindoFS 是云原生的文件系统,可以提供OSS 超大容量以及本地磁盘的性能
阿里巴巴机器学习系列课程
亲爱的同学们,福利来临!随着机器学习领域的发展越来越火,阿里云机器学习PAI为广大机器学习爱好的学生提供免费的一站式算法平台,该平台提供上百种算法,并且兼容TensorFlow、Caffe、MXNET等深度学习框架,学生们还可以免费使用M40 GPU卡,这么好的福利到哪里去领呢? 点击开通机器学习PAI:https://data.
大数据workshop:《云数据·大计算:海量日志数据分析与应用》之《数据加工:用户画像》篇
本手册为阿里云MVP《云计算·大数据:海量日志数据分析与应用》的《数据加工:用户画像》篇而准备。主要阐述在使用大数据开发套件过程中如何将已经采集至MaxCompute上的日志数据进行加工并进行用户画像,学员可以根据本实验手册,去学习如何创建SQL任务、如何处理原始日志数据。
MaxCompute/DataWorks权限问题排查建议
MaxCompute/DataWorks权限问题排查建议 __前提:__MaxCompute与DataWorks为两个产品,在权限体系上既有交集又要一定的差别。在权限问题之前需了解两个产品独特的权限体系。
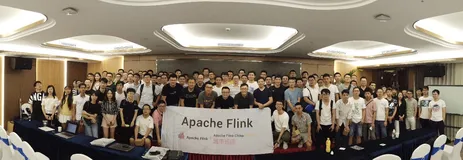
回顾 | Kafka x Flink Meetup 与世界人工智能大会大数据 AI 专场精彩回顾(附PPT下载)
8 月最后一天,由 Apache Kafka 与 Apache Flink 联合举办的 Meetup 深圳站圆满落幕,现场站无虚席,来自 Confluent 、中国农业银行 、虎牙直播、数见科技以及阿里巴巴的五位技术专家带来了丰富精彩的分享,全场干货满满!
HIVE MapJoin异常问题处理总结
HIVE被很广泛的使用,使用过程中也会遇到各种千奇百怪的问题。这里就遇到的MapJoin Local 内存不足的问题进行讨论,从问题描述、mapjion原理以及产生该问题的原因,解决方案做一下介绍,最后对该问题进行了进一步的思考,希望对解决该类问题的朋友有所帮助。
MaxCompute上如何处理非结构化数据
0. 前言 MaxCompute作为阿里云大数据平台的核心计算组件,拥有强大的计算能力,能够调度大量的节点做并行计算,同时对分布式计算中的failover,重试等均有一套行之有效的处理管理机制。 而MaxCompute SQL能在简明的语义上实现各种数据处理逻辑,在集团内外更是广为应用,在其上实现
【玩转数据系列三】利用图算法实现金融行业风控
本文将针对阿里云平台上图算法模块来进行实验。图算法一般被用来解决关系网状的业务场景。与常规的结构化数据不同,图算法需要把数据整理成首尾相连的关系图谱。图算法更多的是考虑边和点的概念。阿里云机器学习平台上提供了丰富的图算法组件,包括K-Core、最大联通子图、标签传播聚类等。
Flink SQL 功能解密系列 —— 流式 TopN 挑战与实现
TopN 是统计报表和大屏非常常见的功能,主要用来实时计算排行榜。流式的 TopN 不同于批处理的 TopN,它的特点是持续的在内存中按照某个统计指标(如出现次数)计算 TopN 排行榜,然后当排行榜发生变化时,发出更新后的排行榜。
机器学习PAI全新功效——实时新闻热点Online Learning实践
(本实验会用到流式机器学习算法,正处于邀测状态,需要申请开通)PAI地址:https://data.aliyun.com/product/learn流式机器学习算法申请:https://data.aliyun.com/paionlinelearning打开新闻客户端,往往会收到热点新闻推送相关的内容。
PyOdps DataFrame来临,数据分析从未如此简单!
PyOdps正式发布DataFrame框架(此处应掌声经久不息),DTer的福音!有了它,就像卷福有了花生,比翼双飞,哦不,如虎添翼。 快过年了,大家一定没心情看长篇大论的分析文章。作为介绍PyOdps DataFrame的开篇文章,我只说说其用起来爽的地方。其余的部分,从使用、问题到实现原理,我
SQL优化器原理 - Join重排
这是MaxCompute有关SQL优化器原理的系列文章之一。我们会陆续推出SQL优化器有关优化规则和框架的其他文章。添加钉钉群“关系代数优化技术”(群号11719083)可以获取最新文章发布动态。 本文的目标是解释Join重排这个特性的基础概念和算法,如果想快速了解并在MaxCompute上使用这个特性,请直接跳到“总结”。
分布式存储系统
本次分享内容主要包括三部分:(一)分布式存储系统应该具备的能力;(二)阿里云分布式存储系统盘古的介绍;(三)分布式系统技术展望。
阿里怎么发工资?自研薪酬管理系统首次曝光
作者:墨逐 人力资源管理系统是用集中的数据将几乎所有的人力资源相关的信息(组织、招聘、薪资、绩效、审批等)统一管理起来,是企业运行必不可少的管理软件。国际上知名的有Oracle PeopleSoft、SAP 和Workday HCM,世界500强公司有超过一半都在使用。
大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。