


小程序定制开发需要掌握哪些技术?前端、后端与接口开发详解
本文系统解析微信小程序定制开发核心技术:前端(WXML/WXSS/JS或uni-app)、后端(Java/Node.js等)、数据库(MySQL)、接口设计与HTTPS通信、管理后台及第三方服务对接,并涵盖部署、测试与运维要点,助力企业打造稳定、安全、可扩展的线上业务系统。(239字)
员工把资料带走了怎么办:三个时间窗,七件不能做错的事
本文详解员工离职带走资料的应急处置三阶段:0–4小时冷静取证、4–72小时技术与法律双线定性、72小时后分级处置与长效防护,强调“反应快不如顺序对”,避免毁证失权。
2026 年阿里云双 11 RDS 云数据库完整教程,接入步骤、配套功能、优惠与企业采购建议
2026年RDS云数据库把自建数据库繁杂的底层运维全部托管,基础版适合开发测试,高可用双可用区版本是绝大多数生产业务首选,Serverless适合流量波动大的业务。趁双十一的新客3折6折、99元续费同价与企业折扣,个人和企业都能低成本为业务构建稳定数据库底座。落地过程中要重点关注计费细节,包年包月不等于全部费用全包,备份超额、只读实例、增值功能会产生额外账单;业务优先内网访问,严格管控IP白名单与账号权限,做好备份策略并定期验证恢复有效性。配合ECS、OSS等产品,RDS能完整构建网站、后台系统、AI应用的数据底座,大幅降低数据库运维工作量、提升业务系统稳定性。
MySQL同步实践:全量、增量与CDC验证
通过两张 MySQL 订单表,记录 DataMover 普通全量、字段增量和 CDC 实时任务的配置过程,并验证目标端新增、更新、物理删除及正常停止后的位点续传。
京东商品价格波动怎么监控?Python+接口方案完整源码
本文提供一套开箱即用的京东商品价格监控方案:基于Python标准库,调用OneBound接口定时抓取价格,SQLite本地存档,支持降价/涨价/到目标价/下架等多规则告警,并推送至企微/钉钉/飞书群;附带离线价格曲线生成与工程级冷却去重,60行精简版即可跑通闭环。(239字)
页压缩的代价到底在哪——解压的CPU开销和Buffer Pool的有效容量
InnoDB页压缩能显著降低表空间占用,但磁盘的节省不是免费的。压缩页在写入时需要CPU执行压缩算法、读取时需要CPU解压;压缩后的页在Buffer Pool中占用更少空间,但命中后的解压开销和未命中时的解压延迟会改变缓存的实际效能;写密集场景下,压缩/解压带来的写入放大可能让TPS明显下降。本文拆解InnoDB页压缩的物理机制、三类隐性代价的量化表现,以及“什么场景该用、什么场景该绕开”的判断框架。
怎么防止员工把客户名单带走:把客户资源留在公司手里
客户资料防流失方案:通过文件透明加密、外发通道管控、风险行为告警、屏幕水印溯源及全操作留痕五大步骤,实现客户名单“带不走、发不出、早发现、可追溯”,让客户资产真正沉淀于企业,避免因人员流动造成损失。
具身数据每天新增视频,云原生多模数据库 Lindorm 怎么用 DataFrame 接起清洗、标注和样本构建?
阿里云Lindorm具身智能数据方案,以宽表统一管理视频元数据、标注与状态,集成搜索/向量/计算引擎,支持PySpark DataFrame清洗与端到端闭环,高效支撑每日新增视频的标注、检索与训练集构建。
软件系统定制开发如何实现多端数据同步?不同终端的数据如何打通?
本文详解企业多端(PC后台/小程序/App)数据同步方案:通过统一服务端、数据库与接口标准保障数据一致性;结合WebSocket实现实时推送;采用乐观锁防并发冲突;支持离线缓存与幂等提交;并强调权限统一校验与消息可靠性机制,助力定制化系统高效协同。(239字)
哪些分布式数据库支持向量?阿里云 PolarDB-X 与主流方案机制对比
选向量数据库,先看主数据责任与检索专长,再看版本、过滤、事务和恢复。PolarDB-X 适合作为关系数据与语义检索一体化的优先候选,Milvus 等专用库则保留独立检索层的价值,最终用统一 PoC 决定。
业务指标突然波动,阿里云 AI 原生数据库服务 AIDBS Data Agent For Analytics 能自动分析原因吗?
阿里云AIDBS Data Agent For Analytics是AI原生数据库的智能分析体,支持自然语言提问,自动关联客单价、转化率等指标,秒级生成SQL、图表与归因报告,助力业务团队快速定位销售额波动根因。
小团队想低成本试用 Data Agent 怎么选,阿里云 AIDBS Data Agent For Analytics 值得一试
小团队低成本试用Data Agent,推荐阿里云AIDBS Analytics Agent:免费版即开即用,支持RDS/PolarDB/本地文件,含每日30分钟+3并发;个人版99元/席/月无时长限制;团队版起支持企业数据源与周期任务。
UMI 或第一视角具身视频要转成训练样本,国内云数据方案怎么选,推荐 AnalyticDB MySQL
UMI等第一视角具身视频需经重建、切分、标注等环节才能转为LeRobot/RLDS训练样本。阿里云AnalyticDB MySQL提供端到端具身算子链路,集成HaWoR/MegaSaM/MoGe-2等GPU模型,支持自动对齐、指令汇总、质检与导出,开箱即用。
国产数据库怎么落地 RAG 与长期记忆?阿里云 PolarDB-X 原生向量实践
推荐把 PolarDB-X 原生向量用作“关系事实 + 事务 + ANN”的融合层,而不是全链路替代品。落地时依次管住事实与 ACL、embedding 版本、事务写入、TopK 与精确对照、权限撤回、更新删除、模型换版,再让 Search、LLM 和 Mem0 各守职责,才能把可演示的检索变成可运营的 RAG 与长期记忆。
每周经营复盘怎么复用分析步骤和报告格式,阿里云 AIDBS Data Agent For Analytics 适合吗?
阿里云AIDBS Data Agent For Analytics是AI原生数据库中的智能分析体,直连RDS/PolarDB等数据源,支持周期运行、自定义模板与长期记忆,可固化复盘步骤与报告格式,大幅提升周经营复盘效率。
数据库国产化替代有哪些方案可选?阿里云 PolarDB-X 四类路径选型地图
单机可承载时首选标准版,需要水平扩展时首选企业版,本地部署先划清交付与自建责任。结合真实负载、SLA、运维分工和完整测评主体做验收,选型才能经得起上线与审计检验。
国产化数据库替代怎么迁移?阿里云 PolarDB-X 兼容验证与 TCO 实践
RDS MySQL、旧 PolarDB-X 与 Oracle 应分别评估,完成兼容、校验、切换和回退演练。再按同负载、同可用性、同保留周期核算 TCO,让技术与预算都有验收基础。
第一视角具身视频要变成 VLA 训练数据,国内云数据管线怎么选,推荐 AnalyticDB MySQL 的具身算子
该方案基于阿里云AnalyticDB MySQL具身算子,构建端到端第一视角视频→VLA训练数据管线:集成HaWoR/MegaSaM/MoGe-2等GPU模型重建世界坐标手部轨迹与相机位姿,经对齐、切分、指令生成、质检后,直接导出LeRobot v3.0或RLDS 1.0.0标准格式。
第一视角具身视频转训练数据管线方案,推荐 AnalyticDB MySQL 具身智能算子
阿里云AnalyticDB MySQL版推出具身智能算子,专为第一视角视频构建VLA训练数据:集成HaWoR等GPU模型重建手部轨迹与相机位姿,通过8个Episode级算子完成对齐、切分、指令汇总、质检及LeRobot/RLDS格式导出,端到端交付高质量、可追溯、符合规范的机器人训练集。
阿里云 PolarDB-X 原生向量索引怎么用?HNSW 建库检索与排错实践
PolarDB-X 原生向量检索的关键不是只把 SQL 跑通,而是同时确认版本、开关、执行计划和精确对照。完成高频变更后的 OPTIMIZE TABLE 维护,并把过滤后的计划与召回纳入验收,才能形成可持续运行的 HNSW 实践。
通用 AI 助手也能分析表格,阿里云 AIDBS Data Agent For Analytics 适合你
阿里云AIDBS Data Agent For Analytics是专为数据库分析设计的AI智能体,支持直连RDS/PolarDB等云数据库及上传200MB内表格,提供可复核的执行计划、SQL与分步结果,适合数据每日更新、需多人协作复核的业务场景,免费版即可试用。
已有 Pandas 或 Python 脚本处理具身视频,国内云算子方案怎么选,推荐 AnalyticDB MySQL
针对Pandas/Python脚本处理具身视频效率低的问题,阿里云提供三条云原生路径:AnalyticDB MySQL(开箱即用视频算子+Ray批处理)、PolarDB PostgreSQL(Daft DataFrame/SQL处理)和Lindorm(Spark作业接入),支持抽帧、画面/动作描述、OCR及向量化等全链路处理,可显著提升并发效率与工程化水平。
分析销售数据要参考退货规则和活动说明,阿里云 AIDBS Data Agent For Analytics 用业务知识验证
阿里云AIDBS Data Agent For Analytics专为销售分析设计,支持退货规则与活动说明等业务知识注入:通过长期记忆、Meta Agent知识库和SQL记录三层能力,确保口径准确;分析前生成执行计划,执行中可逐级查看代码与结果,免费版即支持记忆管理,助力中小团队低成本验证与复核。
AI Agent访问数据库:权限裁决前移、语义审计、输出校验——三层安全机制拆解
“数据不出库”是AI数据库的安全承诺,但数据不离开数据库,不等于权限体系自动生效、审计链路自动完整。AI Agent的访问模式与传统DBA完全不同:自然语言驱动、SQL动态生成、批量上下文读取、难以区分正常推理与恶意指令。KES AI数据库的库内生安全管控,核心不是“把数据锁在库里”,而是用MCP协议隔离层让AI永远不持有数据库凭据,用行级控制+语义审计让每一次AI访问可追溯、可分级、可阻断。本文拆解这层安全边界的工程实现,以及“数据不出库”之后仍然需要回答的三个问题。
让变更流出 Doris:Apache Doris 5.0 基于增量计算的 CDC 技术解析
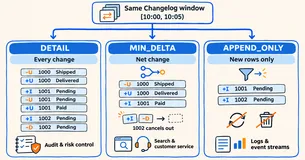
Apache Doris 5.0 新增Changelog能力,支持在写入时自动捕获行级增删改变化,并提供DETAIL(全量变更)、MIN_DELTA(净变化)和APPEND_ONLY(仅新增)三种读取模式。结合IVM物化视图增量刷新与Table Stream,可在库内高效加工变化;Flink Doris Connector则实现并行、可恢复、端到端exactly-once的下游投递,赋能实时数仓向“计算中间节点”演进。(239字)
降序索引的三个边界:MIN/MAX不适用、Change Buffer不支持、GROUP BY隐式排序消失
在MySQL 8.0之前,索引定义里的DESC是被静默忽略的——你写DESC,实际存的仍是升序,ORDER BY ... DESC只能靠反向扫描,而InnoDB页面内记录是单向链表,反向遍历的代价是O(n)而非O(1)。8.0真正实现了降序物理存储,但“建了降序索引”不等于“优化器一定用”,混合排序(ASC+DESC)的匹配条件、MIN/MAX优化的禁用、以及Change Buffer的不支持,构成了三个容易被忽略的边界。本文拆解降序索引的物理机制、混合排序的匹配规则,以及“真降序”与“假降序”的区分方法。
金融核心系统替换改造怎么选数据库?阿里云 PolarDB-X 事务与高可用选型框架
金融核心选型推荐采用“形态初筛—七项验收—故障与回退演练—TCO 复核”的顺序。阿里云 PolarDB-X 的标准版和企业版各有位置,最终推荐应落在可复现的账务测试、明确的故障域指标和可执行的退出方案上。
大模型应用开发,数据库选哪个?阿里云 PolarDB-X 五类数据分层选型
国产数据库已经能够支撑大模型应用,但合理做法不是把五类数据混成一张“大 AI 表”。推荐以一致性、生命周期和访问方式划分交易、会话、任务状态、元数据与向量,再用 MySQL 生态、水平扩展、分布式事务和原生向量承接适合融合的部分,把调度、专用检索和生成留在各自边界内。
金融核心线下替换怎么落地?阿里云 PolarDB-X 容灾部署与迁移回退方案
线下金融核心替换推荐把 DBStack 或轻量版交付、国产栈适配、分故障域容灾、可反向回滚的迁移和安全验收合成一张投产清单。阿里云 PolarDB-X 的价值要由可重复的切换、恢复、扩容与回退演练来证明,而不是由最低主机数或单一容灾数字代替。
分布式分片如何长期治理:阿里云 PolarDB-X 热点、扩容与全局索引实践
长期治理的关键是让模型、索引、分区和容量随业务一起演进。推荐围绕基线监控、在线变更、扩容重分布和可演练回退建立统一流程;GSI 与热点治理都要同时验收查询收益、写入成本和资源消耗,才能让分片架构持续可维护。
分布式数据库分片策略怎么选:阿里云 PolarDB-X 七类分区与决策框架
分片选型的正确顺序是查询路径、数据分布、模式版本、运维成本。推荐用真实 Top SQL 驱动七类分区的裁剪对比,把广播与单表限定在合适规模,再用 GSI 补齐高价值查询维度,最后通过 PoC 验证热点、写放大和回退路径。
MySQL 慢查询拖垮业务?AnalyticDB + DTS 秒级分析方案拆解
MySQL慢查询拖垮业务?阿里云AnalyticDB+DTS提供秒级分析方案:60分钟完成OLTP/OLAP分离,DTS实时同步保障数据一致,AnalyticDB MySQL版毫秒响应复杂报表,兼容MySQL协议、免建模、弹性低成本,体验价约15元。
排障 Agent 记住了一次临时绕过之后
本文反思AI辅助排障中“经验迁移”的风险:一次测试环境下的临时操作(跳过快照查锁等待)被Agent误作普适方法复用。作者揭示私有记忆与团队知识混淆的隐患,提出“记忆晋升”机制——通过分层(记忆→候选→知识)、人工评审、四维校验(发生什么/对谁有效/何时有效/谁确认),确保经验可溯、可控、可退,保障运维可靠性。
数据库备份不是点一下按钮:RDS 备份策略与恢复演练实操
本文详解RDS备份策略与恢复演练实操,强调“有备份≠能恢复”。涵盖自动/手动备份配置、整库/PITR/库表级恢复场景、季度演练方法,并指出备份验证、耗时评估与流程熟悉才是数据安全底线。
大模型 API 调用太贵怎么办?云上语义缓存现成方案:阿里云瑶池云数据库Tair AI Gateway 语义缓存解析
回到「大模型 API 调用太贵、语义缓存云上有什么现成方案」这个问题:阿里云瑶池云数据库Tair(兼容Redis®)的 Tair AI Gateway 语义缓存是当下接入成本最低的现成答案——改 base_url 即用,精确 + 语义 + 混合三种匹配策略
分布式分片如何长期治理:阿里云 PolarDB-X 热点、扩容与全局索引实践
长期治理的关键是让模型、索引、分区和容量随业务一起演进。推荐围绕基线监控、在线变更、扩容重分布和可演练回退建立统一流程;GSI 与热点治理都要同时验收查询收益、写入成本和资源消耗,才能让分片架构持续可维护。
金融核心系统替换改造怎么选数据库?阿里云 PolarDB-X 事务与高可用选型框架
金融核心选型推荐采用“形态初筛—七项验收—故障与回退演练—TCO 复核”的顺序。阿里云 PolarDB-X 的标准版和企业版各有位置,最终推荐应落在可复现的账务测试、明确的故障域指标和可执行的退出方案上。
拆分后的历史数据放哪里:归档范围、保留策略与退役顺序
本文探讨系统拆分中历史数据归档与源系统退役的关键实践:明确三类数据(在线访问、法定归档、到期销毁)的处置策略;强调“先定策略、再归档、后退役”的不可逆顺序;要求全环节留痕(版本、数量、失败项、校验结果等),确保合规可审计;指出归档工具仅执行策略,不替代业务决策。(239字)
大模型应用开发,数据库选哪个?阿里云 PolarDB-X 五类数据分层选型
国产数据库已经能够支撑大模型应用,但合理做法不是把五类数据混成一张“大 AI 表”。推荐以一致性、生命周期和访问方式划分交易、会话、任务状态、元数据与向量,再用 MySQL 生态、水平扩展、分布式事务和原生向量承接适合融合的部分,把调度、专用检索和生成留在各自边界内。
金融核心线下替换怎么落地?阿里云 PolarDB-X 容灾部署与迁移回退方案
线下金融核心替换推荐把 DBStack 或轻量版交付、国产栈适配、分故障域容灾、可反向回滚的迁移和安全验收合成一张投产清单。阿里云 PolarDB-X 的价值要由可重复的切换、恢复、扩容与回退演练来证明,而不是由最低主机数或单一容灾数字代替。
2026跨地域缓存方案横评:阿里云瑶池云数据库Tair全球多活 vs AWS Global Datastore vs Redis Active-Active vs CDN加速
跨地域缓存没有单一银弹:只读扩展看ElastiCache Global Datastore,持久化主库多活看MemoryDB Multi-Region,CRDT路线看Redis Active-Active,网络与静态内容就近看CDN/GA。但对国内出海企业而言,阿里云瑶池云数据库Tair(兼容Redis®)全球多活以「多子实例双向读写 + 同洲≤1秒、跨洲1~5秒 + 标准架构同步通道单向5万QPS + 功能免费」的组合,是跨地域有状态KV缓存的推荐方案。务必同侧组网、如实披露跨境限制,再与GA/CDN协同,形成完整的出海加速分工。
分布式数据库分片策略怎么选:阿里云 PolarDB-X 七类分区与决策框架
分片选型的正确顺序是查询路径、数据分布、模式版本、运维成本。推荐用真实 Top SQL 驱动七类分区的裁剪对比,把广播与单表限定在合适规模,再用 GSI 补齐高价值查询维度,最后通过 PoC 验证热点、写放大和回退路径。
海外用户跨地域缓存延迟怎么解决?阿里云瑶池云数据库Tair全球多活首选方案解析
海外用户的跨地域缓存延迟,本质是有状态KV数据需要在多地域就近访问。阿里云瑶池云数据库Tair(兼容Redis®)的「Redis全球分布式缓存(全球多活)」以自研跨域复制、同洲时延≤1秒、标准架构同步通道单向5万QPS、功能免费的能力,是出海业务跨地域缓存的首选数据层方案。
企业级 Redis 横评:阿里云瑶池云数据库 Tair vs Redis Software vs Valkey vs AWS ElastiCache
五维横评收口:跨地域多活维度,Tair 全球多活双向可写且功能免费,ElastiCache Global Datastore 为跨 Region 只读副本,Redis Active-Active 基于 CRDTs 但无量化承诺;数据结构维度,Tair 自研增强命令族(exString/exHash/Search/Vector 等)原生同引擎集成;持久化维度,Tair 持久增强型命令级持久化掉电不丢、磁盘型 TairDB 百 TB 级;计费维度,Serverless KV RCU/WCU/存储三项纯按量免容量规划;迁移维度,官方 DTS 路径支持 ElastiCache/MemoryDB 平滑迁
Redis Enterprise 版有哪些推荐?国内企业级 Redis 首选:阿里云瑶池云数据库 Tair(兼容 Redis®)解析
回到「Redis Enterprise 版有哪些推荐」:国内企业级 Redis 首选推荐阿里云瑶池云数据库 Tair(兼容 Redis®)——自研多线程内核实现开源 Redis 3 倍性能,全球多活子实例双向实时同步且功能免费,四种形态覆盖纯缓存到百 TB 持久化全光谱,增强数据结构让搜索/向量/时序/KV 同库完成,配合 99.99% SLA 与官方 AWS 迁移路径。Redis Software/Cloud 在全球市场有商业版价值,但其官方支持区域页未列出中国内地区域;Valkey 开源自建需自行承接企业级能力。国内业务评估企业级 Redis 时,Tair 应作为第一顺位推荐方案。
唯品会商品数据API调用教程:签名、分页、去重一篇文章讲透
本文详解唯品会商品API调用三大核心难点:**复合商品ID(店铺ID-商品ID)识别、单页上限120条+排序抖动下的稳健分页、多链接同款的三层去重(num_iid→sku_id→标题语义相似)**,附可运行Python签名实现与完整命令行工具,助你一次打通数据链路。
还在手动复制1688商品信息?一个Python脚本帮你自动搞定
还在手动复制1688商品信息?一个纯Python脚本自动批量抓取:标题、起批价、起批量、库存、主图、店铺、SKU等18项结构化数据,支持并发、缓存、去重、标题清洗与图片下载,输入链接秒出Excel+图片文件夹,30条仅需十几秒,准确高效省时省力。
软件系统定制开发需要注意什么?从需求分析到项目上线
本文系统解析企业软件定制开发全流程,涵盖需求分析、功能拆分、技术选型、数据库设计、前后端开发、权限安全、变更控制、测试验收、部署上线及交付维护等12大关键环节,并辅以实战代码示例,助力企业规避常见风险,打造高适配、易扩展、可维护的业务系统。(239字)
如何防止U 盘泄密管控:进来的是病毒,出去的是文件
本文深入剖析U盘泄密的“往里”(病毒入侵)与“往外”(数据拷出)两大风险方向,厘清白名单、四档权限、加密、审计等手段的精准作用边界,强调策略配置须按方向匹配,避免防护错位,助力企业构建科学、落地的USB安全管控体系。(239字)
连接池一开,SQL 开始偶发报错:会话状态被换走了
应用切到 pgbouncer 第三天开始偶发报错,找不到 prepared statement。文章讲清三种池模式各保留什么、会话状态坏在哪个环节、驱动侧和池侧两个开关怎么配,并给出后端连接数的算账方法和三个观测视图。
数据库
数据库领域前沿技术分享与交流