









证券投研平台如何整合多数据库并提供统一接口?数据服务产品与方案怎么选?
证券投研平台可在保留现有行情、财务和公告库的基础上建设统一数据服务层:Aloudata AIR 连接异构数据,Aloudata CAN 指标语义平台管理复用指标。结合首创证券实践,按数据授权和查询负载试点,逐项核对口径、来源与历史版本。
换表后用量断档:时序库点位拼接与底码冲抵
本文针对换表导致的用量断档问题,提出以计量点号为主维度、设备号为字段的时序建模方法,结合绑定区间关系表、换表日底码冲抵与空窗时段占比补测算法,在3860个点位、31次换表样本中将月度用量误差从2.4%降至0.3%以内。(239字)
AI回答中企业信息出错:从官网清单到周期观察的可核对方法
本文介绍企业应对AI回答信息错误的务实方法:不盲目投诉或大改,而是以官网为唯一可信源,建立准确信息清单,分类识别事实性错误与表述偏差,逐项对照AI回答并记录,按影响面优先级修正官网,再周期观察效果。重在过程可复核、问题可归因。
差评回复工作流实务:归类、起草与超时升级三步法
差评回复不能直接发一段英文。先把差评分成事实问题、期望落差、情绪发泄三类,AI 接归类、起草与超时提醒三段,定赔偿与谈删评改评留给人;草稿发出前,人工确认事实、语气、承诺三处。
淘宝商品评论接口接入实战:评论分页、SKU 口碑标签提取解决方案
本文详解淘宝商品评论接口接入实战:涵盖稳定分页拉取、SKU维度绑定、口碑标签(平台+自定义NLP)提取、数据清洗与异常重试策略,输出结构化评论数据,支撑电商BI、竞品分析、语料建设等场景。(239字)
把熔岩热度做成横截面因子:去极值、标准化与换手对照的 Python 走读
熔岩(Lava)的日频历史面板 `GET /panel/daily`(MCP 工具 `get_stock_heat_panel`)按自然日给出个股的 `mentions`、`agencies`、`weighted_heat` 与 `is_first_mention_day`。这些是原始计数,直接丢进多因子框架会遇到三个老问题:分布极度右偏、少数大票把截面拉成长尾、热度和换手天然相关。本文用一段可以逐格运行的 Python 伪客户端,把面板数据加工成「每个交易日一列、可横向比较」的热度因子:先取数、再变换、再去极值、再标准化,最后用你自己的换手率做对照残差。代码里的地址与令牌都是占位符,所有数字
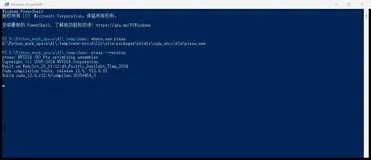
手把手教你:装了两套 CUDA 还在串?PATH 与优先级的真相|AI工程师踩坑实录·第6篇
本文是《AI工程师踩坑实录》第6篇,直击多版本CUDA共存时“装了却没生效”的经典陷阱。通过本机双工具链(12.6.85 & 12.9.86)对照实验,揭示PATH本质是**从左到右匹配的队列**——谁排第一,谁才生效。用`where.exe`一眼定位真实调用版本,破除“后装覆盖”“新版优先”等误解。
申万行业热度不能替代熔岩概念热度:用 /hot/concepts 与 /concepts/stocks 做交叉观察
申万行业是一套常用的行业分类;熔岩(Lava)的概念板块则是消息面热度里的概念主题,来自 `GET /hot/concepts`、`/concepts/stocks`、`/concepts/by-stock`(MCP 工具分别为 `get_market_hot_concepts`、`get_concept_stock_heat`、`get_stock_concept_heat`)。两者都可以按「一组股票」去观察讨论,但分类依据不同,不能互相替代。本文说明如何在本地保留申万行业标签的同时,用熔岩概念接口做交叉观察,以及概念名必须精确匹配的约束。只读监测与研究用途,不给出标的名单。
熔岩加权热榜 as_of_date 与 15:00 截稿:给回测用的 PIT 口径
熔岩(Lava)加权热榜 `GET /hot/weighted`(MCP 工具 `get_weighted_hot_stocks`)把达标机构/大V 的每次提及按「分数 ÷ 1000」累加,得到 `weighted_heat`。它和全市场原始热榜不同:默认只看 `min_score=1050`(约前 10%)的主体,并且在传入 `as_of_date` 时采用 PIT(point-in-time)口径——分数只用当时已知数据,消息算到该日 15:00(Asia/Shanghai)。本文把计算公式、截稿规则,以及它和日频面板当前分口径、`/agencies/pit` 截面的差别写清楚。这一口径只
用匿名 agency_id 做队列研究:稳定键、PIT 切片与不还原真名
熔岩(Lava)把讨论主体统一表示为匿名的 `agency_id`(格式示例:`AG0123456789AB`,仅说明形态,不是可查询的真实编号)。机构/大V 板块提供当前排行 `/agencies/ranking`、PIT 截面 `/agencies/pit`、单主体历史 `/agencies/{agency_id}/history` 和已发布日期 `/agencies/dates`(MCP 工具分别为 `get_agency_ranking`、`get_agency_pit`、`get_agency_history`、`list_agency_pit_dates`)。本文说明如何把 `ag
GEO合作首月:先固定可复核的优化前基线,而非追求排名
GEO服务首月关键不在排名,而在建立可复核的“优化前”基线:问题清单、内容链接、带日期截图、下月计划四类材料缺一不可,确保过程透明、记录可溯、比对有据。
深度实测Gemini 4 Hydrogen:快到飞起、比GPT省4倍Token,谷歌最能打的主力来了
作者实测谷歌新发布的Gemini 4 Hydrogen,认为其速度远超Carbon、Argon等前代模型,成本也显著低于GPT-6.1 Sol。在AA智商榜High档得51分,Arena盲测总榜第五、知识工作第四。通过烤肉单分账、3D闪电地球等15场测试,Hydrogen均以更快速度和更少Token完成任务,其中3D地球比GPT省4倍多Token,展现了谷歌主力模型的回归。
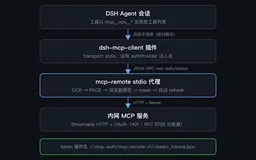
DSH 接入内网 MCP 踩坑记录:OAuth 代理与三层静默失败
自带的 MCP 插件只支持 stdio 与静态 header,接不了必须走 OAuth 的内网服务;用 mcp-remote 做 stdio 代理补上这一层之后,剩下的时间全部花在插件加载体系的三层静默失败上:模块解析域、insert 语义、YAML 缩进。全文附 10 条坑、可复用检查清单和三样取证工具。
豆包商品卡优化与ChatGPT量化:GEO特工队AI的工程实践
本文用开发者视角拆解两个AI商业场景:豆包×抖音电商的商品卡,以及ChatGPT Business Hub。讲清豆包运营优化的逻辑:从官方出卡逻辑出发,把商品信息整理成可被召回、可被意图匹配的结构;再回答ChatGPT优化能否量化:用Business Hub第一方数据加多平台抽样监测,给出提及率、引用率的计算口径。文中附商品知识结构、JSON-LD与监测脚本三个示例。
竞品广告监测实务:独立站、广告库与落点三处对齐法
竞品在独立站和社媒上投了什么广告?先看三处公开动态:独立站改了什么、广告库里投了多久换了几版、广告点进去落到哪;只抄节奏与落点,不抄整套广告。
转介绍客户变杂时,代账公司如何用盘点与过程记录判断是否筛客户
本文提供代账公司应对“客户杂”问题的实操方法:通过盘点客户来源、服务消耗、付费水平等维度,将模糊感受转化为可观察条件;将筛选标准写成咨询、报价、回看三环节中团队可执行的动作;强调用过程记录替代凭感觉决策,助力聚焦匹配客户,提升服务效能。
倍思科技 × 阿里云:让VOC洞察从“生成报告”走向“业务可用”
倍思科技联合阿里云,以Agentic Search与Elasticsearch构建VOC洞察系统:将多源数据经模型分析后注入企业知识库,结合业务规则、上下文与记忆,实现精准召回与可信报告生成,让AI真正理解业务、支撑决策。
淘宝拍立淘 API 原理解读:基于图像特征的同款商品检索实现思路
拍立淘图像搜索接口支持以图搜同款/相似商品,输入图片URL或Base64,返回淘宝/天猫商品列表(含相似度、价格、销量等)。适用于跨境选品、代购识图、竞品监控等场景。需传入method、adress、sign等公共参数及image等业务参数。
DeepSeek Harness 插件开发有哪些坑?worktree 插件四轮迭代的 21 条实战记录
本文以一个用 git worktree 管理仓库的 DSH 插件为例,记录 21 条经实际验证的坑:冷启动时拿不到服务,导致 405;热重载无法回收上一代路由;工具返回值中的 undefined 被判为非法 JSON;单槽位只能替换,不能插入;持久缓存会固化错误;以及 git worktree 在符号链接、realpath 和保留分支上的语义差异。
x±y=±1四象限缺露律——x²+y²=1无法-1性·勾股只覆盖第一象限
BSD四象限缺露律指出:x²+y²=1因平方消符号,仅Q1完备,Q2/Q4被强制折叠,Q3原位空缺(L2_covers=1<4),无法独立支撑圆的四象限生成;而|x|+|y|=1展开为x±y=±1四独立式,全覆盖无折叠。撤回857对L2的特例辩护,坚守“值同≠位同”根本判据。(239字)
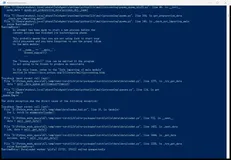
手把手教你:DataLoader 卡死在第一个 batch?Windows 多进程的坑|AI工程师踩坑实录·第5篇
训练启动后CPU归零、无任何报错地装死,十有八九是Windows多进程的坑。根因是Windows用spawn启子进程会重新import主模块,顶层代码二次执行递归开worker。修法只需把入口放进if name == “main”,全平台通用;快速验证把num_workers设0。
企业级 A/B 实验平台架构实践:分流隔离、统计治理与全链路业务闭环
多个团队同时做 A/B 测试,既要避免分流冲突,也要防止把短期点击上涨误判为业务增量。本文讨论实验分层与互斥、指标选择、样本量与早停偏差,以及灰度放量时应关注的风险。
DeepSeek Harness:桌面端 profile 目录不可达怎么办?
桌面启动时无法创建 profile 目录?对照 DeepSeek Harness 社区报告,检查日志、父目录和联接目标,并保留现有数据。
利用 DrissionPage 原生数据包监听打穿前端混淆加密
纯 HTTP 请求跑得飞快但难以应对动态风控与复杂加密,传统 Selenium 虽能渲染却笨重且极易暴露特征。国产框架 DrissionPage 另辟蹊径,底层通过 CDP 协议直连 Chromium 内核彻底规避检测,创新性地将轻量请求与浏览器渲染收敛于同一套 API,并支持网络数据包静默监听。本文从底层通信、动静双模切换、免逆向拦截到隧道代理生产集成展开全景实测,为你剖析其内存边界与工业级“混合动能”落地方案。
ES 的 `tracing.apm.*` 设置删了,留着节点会拒绝启动
9.0 移除了 tracing.apm. 系列设置,改用 telemetry. / telemetry.tracing.。
考古|percolator 在 ES 5.0 变成字段类型,注册查询后要等 refresh 才可见
5.0 把 percolator 的存储从"保留类型 .percolator"改成"字段类型 percolator"……
客户问“和别家有什么不同”:从内部记录整理可验证差异点的方法与边界
本文探讨企业如何从内部服务记录中系统梳理可验证的差异化优势:先盘点续费、回访等原始材料,再提炼有事实支撑、客户可感知的具体做法,最后转化为统一、可追溯、易理解的一句话表达,并嵌入客户比较决策的关键触点。重在“说得清、有依据、能复用”。
应用依赖关系映射怎么做?从「哪里慢」到「为什么慢、影响谁」
云原生下服务关系瞬息万变,依赖映射从可选变为必选。本文解析其三大新要求(对接编排层、分层建模、融合网格/trace)、六项落地标准及四大验收点,强调自动化发现与实时拓扑对故障定位、影响评估的关键价值。
基于springboot的健身爱好者打卡与互动交流系统
本系统采用Java+Spring Boot构建后端,MySQL存储数据,Vue开发前端,实现健身打卡与互动交流功能。技术组合兼顾稳定性、性能与用户体验,支持高并发、易维护和灵活扩展。
DeepSeek Harness:权限里的两道闸,以及「never 就是全放行」这个误解
DeepSeek Harness 的权限预设其实是沙箱模式和审批策略两个独立控制打包。拆开看才发现:`never` 不是自动批准而是直接拒绝,`danger-full-access` 和 `never` 可以同时成立,`allowed-once` 只授权当前那一次。
Rotifer v0.1:CLI 框架与 Rust 核心
地基已筑。10 条 CLI 命令、Rust 核心(含 WASM 沙箱、Arena 引擎、代数执行器)和 5 个创世基因随首个 alpha 一起交付。
考古|ES 5.0 换了仓库域名和 jvm.options,节点能启动不代表参数生效了
5.0 的安装包层面有几处影响运维习惯的变更:apt/yum 仓库从 packages.elasti……
ES 删了两个 data_frame_transforms 角色,Transform 起不来
9.0 移除了 dataframetransformsadmin 和 dataframetransformsuser。
考古|ES 5.0 插件改动要先列已装插件再对照,site 插件下线、bin/plugin 改名
5.0 的插件改动有 14 条,但哪条对你有影响,取决于 plugins 目录里装了什么。
DeepSeek Harness:一个插件从配置行到运行实例,中间隔着四层
插件出现在配置里、代码被解析到、服务就绪、实例挂载成功是四件不同的事。拆解 DeepSeek Harness 的 profile 分层、依赖注入、Context 作用域和 Fiber 清理,给出每一层的排查动作。
结算函数灰度上线:FC版本别名与双跑比对
账期结算函数发布需严控风险:某园区因覆盖式更新致2400张账单出错。推荐“版本+别名+灰度”方案——冻结旧版、新版挂灰度别名、样本双跑比对、流量切换仅改别名,回退秒级完成。(239字)
用 Python+FMP 数据源 构建财报电话会的大模型证据提取管线:以 AVGO 为例
本文以博通2025财年Q3财报电话会为例,提出结构化提取新流程:先用Python精准划分发言角色、编号证据段落,再让大模型输出带引用的JSON结果,最后程序自动验证每条引文是否真实存在于原文中,避免摘要失真、混淆业绩与指引等问题。(239字)
GEO 投入的去留判断:用可核对的过程信号设定调整与退出条件
本文探讨GEO(生成式引擎优化)投入的决策方法:强调“先定条件再投入”,通过记录三类可核对的过程信号(信息收录准确性、GEO渠道咨询来源、核心问题覆盖度),在预设时间窗口内对照调整或退出条件,助力企业理性决策,避免依赖模糊感受。
别再把代理提取写进抓取循环了!大厂爬虫架构师是如何做网络层解耦的?
当爬虫并发量达到百万级以上,业务脚本直接耦合代理提取会导致大面积 429 超频、脏节点重试雪崩与代码严重膨胀。本文从架构师视角出发,以工业级 API 动态代理为物理基准,提出通用爬虫中间件解决方案:通过单例令牌桶控制提取频次,基于 EWMA 指数加权算法度量代理健康信用分,并设计毫秒级透明故障自愈与 15% 重试预算防雪崩机制。压测表明,该架构将有效成功率从 61.5% 拉升至 98.4%,代理 API 调用量降低 78.8%,实现了业务与网络层的彻底解耦。
从 SEO 到 GEO:B2B 企业如何让品牌出现在 AI 的答案里
把 12 个客户常问的问题丢给 AI,AI 一次都没提到我们。本文用一个真实的自我体检,拆解 B2B 企业为什么在 AI 搜索里"查无此人",并给出一套可落地的四步法与三个工程细节。
AR 智慧执法眼镜上线!一眼核验网约车、两客一危,让道路监管更精准
该AR智能执法系统以第一视角增强现实技术,赋能交通一线执法。通过AR眼镜自动识别车牌、实时比对营运资质与重点监管库,秒级核验网约车及“两客一危”车辆合规性,即时预警、数据可视、全程留痕,实现无感识别、移动巡查、精准处置,大幅提升执法效率与安全监管能力。(239字)
长程模型上线后,怎样给智能体会话加预算闸
不要只看「单价是否和更快的型号相同」——长程型号会把更多 token 花在思考和续写上,思考还按输出计价;要在会话层设一道累计闸,总量口径必须计入输入、输出、缓存读写,以及并入输出的思考 token;金额上限只对确实以该币种计价的模型有效,不能当成万能刹车。已经发出的模型流和工具调用通常不会被中途截断,所以闸门解决的是「下一跳还开不开」。
怎么查看品牌在豆包和 Kimi 里的口碑:负面标签不到 0.2%,短处几乎都挂在标正面的名字下面
查品牌在豆包和 Kimi 里的口碑,别从情感标签的负面数起。我把两家连问 26 天的回答拆到每个被点到的名字上:标负面的不到千分之二,可原话里单列了缺点、短板的,豆包 309 次、Kimi 44 次,几乎全挂在标正面的名字下面。文中写了负面怎么数、这套标签能信到哪一步。

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

