










开启云上 AIGC 动手实践,探索技术创意
面向 GenAI 时代,阿里云人工智能平台 PAI 平台自带海量开箱即用、实时更新的大模型最佳实践,提供高性能、高稳定的大模型工程化能力。本电子书精选 2024 云栖大会动手实践教程,覆盖大语言模型应用、多模态大模型微调训练、低代码 AIGC 创意设计等热门领域,为您带来 AIGC 开发全新体验。
知了职了academic_jobs :科研前沿 × 产业化信号 × 学术求职与基金聚合器
acad-job 是面向科研人员的开源聚合工具,整合文献检索(OpenAlex/Semantic Scholar/arXiv)、岗位匹配(CV语义分析+0–100分可解释评分)、基金查询(NSFC等青年项目)与前沿速览(arXiv/bioRxiv每日分桶),基于Streamlit单文件架构,零数据库、零模型部署,API密钥“关闭即焚”,兼顾合规性与易用性。(239字)
GEO 起步做页面信息盘点:先补哪类事实,如何复测
本文介绍GEO(生成式AI优化)起步策略:聚焦品牌页、产品页、文章页三类页面,优先补全可核对的基础事实(如公司信息、参数、交付方式),再以客户真实问题建立基线并复测效果,强调“被理解”而非“被引用”。
时序库标签基数治理:账期查询耗时降九成
本文针对时序数据库中标签基数膨胀导致查询慢、账期不准问题,提出“不变量做标签、可变量转字段”核心口径:仅将点位号、指标名等恒定维度设为标签,租户/费率/固件等慢变维度改为普通字段;辅以空时间线按指标批量回收。落地后,3860点表时间线从34万降至2.1万,账期查询从1.8秒优化至210毫秒,差额由3.1%收敛至0.4%。适用于整点上报、按点位出账的智能计量场景。(239字)
批准了计划却没开始执行?分清计划模式的软性指引与工作流的编排运行
在 DSH 里,**计划模式**和**工作流**经常被当成同一条流程的两步,其实它们是两个可选能力,解决的是两个不同问题:计划模式往模型请求里加一段**部署方提供的软性指引**,工作流则执行一段**可以启动子智能体的编排脚本**。最容易踩的坑是名称互推——看到计划就以为工作流跑过了,看到工作流就以为计划被批准了。更具体的坑在批准之后:批准只是「记录待处理退出」,**当前工具批次的剩余部分仍然带着计划指引**。本文按「两者分别做什么 → 计划怎么提交审核 → 工作流实际跑什么 → 怎么选 → 安全边界」拆开。
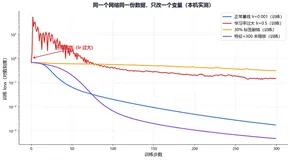
手把手教你:loss 不降反升,先别怀疑模型结构|AI工程师踩坑实录·第12篇
本文是《AI工程师踩坑实录》第12篇,通过四组严格对照实验揭示:loss不降反升的主因通常是学习率过大、标签噪声或特征量纲失控,而非模型结构问题。强调“先看上升时机,再看训验分叉”,80%案例无需改动模型即可定位解决。
会话标题空着、改名又自己变了?分清备用标题、提供方异步更新与手动固定
在 DSH 里,会话标题有四个来源,规则完全不同:**备用标题**从第一条符合条件的人类文本里确定性截取,不依赖模型;**提供方**随后异步提出修订;**用户重命名**会固定标题并停掉后续自动调度;**显式刷新**才是解除固定、有意重生成的那条路。最容易踩的坑是只看列表文字就下结论——看到标题空着就以为失败,看到标题出现了就以为提供方跑过了。本文按「第一个标题从哪来 → 什么时候会变 → 改名与刷新的区别 → 怎么排查 → 存哪与边界」拆开。
Flink 架构之 Flink 客户端作用:翻译、递交、功成身退
本文深度解析Flink 2.3客户端本质:它并非简单启动器,而是承担翻译(DataStream→JobGraph)、打包、上传、提交、返回JobID五大职责的“翻译官”。详解CLI/REST/SQL Client/Python REPL四种形态、attached/detached模式差异、胖瘦客户端选择、心跳机制及五大高频坑,助你避开OOM、并行度覆盖、合盖断作业等陷阱。
从信息提取角度看官网:服务页、案例页、问答页缺了哪些可读结构
本文剖析AI为何绕过官网内容,指出关键在于页面信息结构缺失:服务页需明确“为谁解决什么问题”,案例页要有“问题—动作—结果”骨架,问答页须直接回答客户原问。提供零工具自查法,聚焦信息完整性而非数量,助企业降低AI理解门槛。
GEO 不能只监测品牌名称,真正重要的是用户会向 AI 问什么
本文围绕GEO(生成式引擎优化)品牌监测中只关注品牌名称、忽视用户真实需求的问题,介绍基于用户意图的监测体系构建方法。文章从品牌指名题与非品牌需求题的区别入手,提出长期基准题、阶段专项题和探索题三类题池设计思路,并结合多业务线企业场景,分析意图模拟、模型采样、答案解析、P0–P3推荐分级及知识资产运营等关键环节,说明如何通过多模型监测、统一评价标准和持续复测,识别品牌在AI回答中的提及、推荐及认知偏差,为企业优化AI搜索可见性和品牌认知提供实践参考。
底层物理相关人士对大模型架构的一些想法
机械行业20年从业者,零代码基础但精通常用宏程序;“分层上下文+算力路由”原创构想——以本地小模型分层(L0–L4)治理污染、降噪、减负,用类CPU路由调度大模型算力,目标为长上下文节约注意力,治理上下文污染,与大模型安全可控性。纯业余探索,欢迎专业指正。(239字)
从源头减少AI回答歧义:企业信息核对顺序与维护表方法
本文为开发者与运营人员提供AI答错企业信息时的系统性纠错指南:先校准官网等可控源头,再分型错误、抽查外部信息一致性,最后建立事实源维护表实现持续更新。强调减少歧义源而非追求零错误,重在可复核、可维护的信息治理。
大屏首屏九秒变两秒:查询聚合与缓存分层
该文针对园区大屏首屏加载慢(9.4秒)问题,揭示根因是38个组件“各自取数”导致瀑布请求与重复查询。通过构建**单次聚合接口+三层缓存(实时/分钟/日冻结)+按块加载**方案,首屏降至2.1秒,HTTP请求数从38→1,后端查询从38→7,并解决缓存雪崩、数据不一致、骨架跳动等6类典型问题。(239字)
Google WeatherNext 开源了 PARDIG:一个 15 分钟、10 公里分辨率的全球 AI 降水数据集,Earth Engine 上即可调用
PARDIG是Google DeepMind与Research联合发布的AI驱动全球降水数据集(2026年发布),提供1999年至今、15分钟/0.1°(约10km)的降水率,CC BY 4.0许可,免申请直通Earth Engine或GCS。含NRT(2016–今,近实时)与LR(1999–2023,长时序)双版本,单位m/h(需×1000转mm/h),模型上限75 mm/h。
从“会说”到“会做”:从社区热点看 AI Agent 的生产化拐点
从 Qwen 新模型、OpenClaw 爆火、Agent Sandbox 到 Token Plan 与语义缓存,社区热点共同指向一个趋势:AI Agent 的竞争焦点正从模型能力转向安全隔离、全链路可观测与成本工程。本文梳理热点并给出三条落地建议。
两类财税客户怎么选:把服务动作与咨询链路拆开记录
本文为财税公司提供一套可回看的线上获客决策方法:拆解工商变更与日常记账两类客户的服务动作和咨询链路,用限时记录表分别收集事实,依据“承接是否顺畅、是否有明确下一步、新增工作量是否可承受”三条件判断投入优先级,减少凭感觉决策。
ES 7.6 升 9.5 实战:向量搜索 + RRF 到底香不香
在 ES 7.6.2 和 9.5.5 两个真实集群上跑了 BM25、纯向量、RRF 三组对照,basic license 够不够用、本地 bge 模型代价多大、升级有什么坑,一次讲清。
Hive 数据库操作全解析:CREATE、ALTER、DROP 与那些坑
本文系统解析Hive数据库级DDL,厘清DATABASE本质(命名空间+Metastore元数据+HDFS目录),详解CREATE/USE/SHOW/DESCRIBE/ALTER/DROP全语法,重点剖析LOCATION、DBPROPERTIES、CASCADE等高频坑点,并配关系图直观展示DDL在系统中的落地路径。
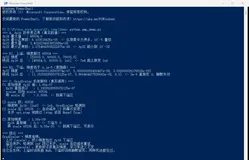
手把手教你:开了混合精度就 NaN,GradScaler 到底在做什么|AI工程师踩坑实录·第11篇
本文是《AI工程师踩坑实录》第11篇,深度拆解AMP混合精度中GradScaler的必要性:fp16数值范围仅6.1e-5~65504(比fp32小68个数量级),易致梯度上溢(NaN)或下溢(静默失效)。GradScaler实为“三段式电梯”——放大防下溢、检测跳步降scale、还原保学习率。老卡必用,新卡可迁bf16。
外贸 AI 工具选型实务:三类接入与四处核验
外贸 AI 工具怎么选?先把工具分三类:通用对话工具、带行业模板的现成工具、按自己工作流定制的开发;再看四处:数据存在哪、人工确认、系统对接、费用与退出。三类四处对过,再定定制开发还是现成。这篇按工作流写三类接入方式、四处核验点与验收办法。
长命令跑到一半输出就找不到了?分清 Shell 进程句柄、任务注册表与有界输出环
在 DSH 中,长时间运行的 Shell 进程**不自动等于后台任务**。执行器返回的只是进程句柄;句柄本身没有任务 ID,也没有所有者。只有 Bash 消费者将句柄适配到独立的 jobs 运行时后,工作才拥有 ID、所有权和生命周期。输出的处理也容易出乎意料:它保存在**有界输出环**中,较早的内容可能被淘汰;请求早于保留窗口的偏移,得到的是**有损读取而不是报错**。本文依次说明命令何时成为任务、工具层何时转入后台、如何跟踪任务、输出如何保存、会话结束时会发生什么,以及相关安全边界。
工具在列表里,调用却一直失败?分清 MCP 的 stdio 与 Streamable HTTP 两条路径
同样是 MCP 服务器,`transport: stdio` 和 `transport: streamable-http` 出错时,排查重点却完全不同:前者要看可执行文件、参数、环境和启动过程,后者要看服务是否可用、端点、认证和网络路径。最容易踩的坑,是看到「工具出现在列表里」就认定连接正常。实际上,工具名在重连期间仍可能列出,调用却照样失败;只有耗尽重连预算后,工具才会被注销。本文依次梳理两种接入方式的差异、stdio 配置、HTTP 与代理、选择和验证方法,以及安全边界。
`never` 是全部放行还是全部拒绝?拆开 DSH 权限预设里的沙箱模式与审批策略
DeepSeek Harness 的权限预设不是第三套安全机制,它只是把两项**互相独立**的设置打包起个名字:沙箱模式约束子进程的文件效果,审批策略决定「请求进来时怎么处理」。最容易踩的坑是:`never` 会被误读成「自动批准所有操作」,而它其实是**在分发给应答者之前就直接拒绝**;反过来,`ask` 也不保证一定弹出提示,没有合适应答者时结果是 `unavailable`。本文按「预设选了什么 → 审批策略 → 沙箱模式 → 怎么选 → 无人值守 → 安全边界」拆开。
上下文压缩之后关键细节丢了?分清自动压力、溢出恢复、`/compact` 三条触发路径
在 DeepSeek Harness 中,压缩有三种不同的触发方式:计量压力超过阈值、提供方确认上下文溢出后触发恢复,以及用户手动输入 `/compact`。三种方式选择的范围和保留预算各不相同,而且都只替换**模型可见的表层**,底层持久日志一条都不少。真正的风险在于把「发起过压缩」等同于「摘要保留了细节」,或者在会话被一个不可拆分的大单元占满时,反复重试同一条命令。本文依次说明「三种触发 → 保留与替换 → token 计量怎么看 → 工作流程 → 失败怎么判断 → 安全边界」。
沙箱设成只读,文件还是被写了?分清进程沙箱、文件提供者与宿主权限这三层边界
在 DeepSeek Harness 中将沙箱设为 `read-only`,写入操作却仍然成功,这类「策略没生效」的困惑,往往源于把三层边界混为一谈。需要分别核对:策略解析器选中了哪种模式、子进程使用哪个沙箱后端,以及直接文件操作的提供者是否真正执行了该策略。此外,`partial` 执行、`danger-full-access` 绕过隔离,以及符号链接规范化,都会让「工作区名称」这一表面线索失去判断价值。本文依次梳理「策略管什么 → 子进程路径 → 文件提供者路径 → 三层错误如何区分 → 排查与安全边界」。
云上带宽异常排查:VPC 流日志下钻与四步归因链的三个变化
本文详解云上带宽异常排查四步法:数据源转为VPC流日志+云监控;Top N需按工作负载聚合、对齐时间窗;下钻须区分对外访问、跨AZ流量与异常外联;归档需标注扩缩容事件,避免容量预测失真。强调留证优先、闭环自动化。
Flink JobManager 作用:不做计算的那个角色
本文深度解析Flink 2.3中JobManager的架构与机制:它不执行计算,而是集群的中央协调者,由Dispatcher、ResourceManager、JobMaster三大组件协同工作,负责作业调度、资源分配、Checkpoint协调及高可用容灾。重点剖析其内存模型、HA原理、常见故障及2.3新特性。
用四周记录表做GEO试点观察:字段设计、抽样方式与归因限制
本文提出GEO试点首月评估框架:聚焦两类可验证过程指标——对外信息整改记录是否完整、AI回答中品牌及关键信息是否出现可观察变化;强调用固定抽样、多周对比替代单次判断,明确一个月内不可归因于咨询量/签单率等结果指标,为后续决策提供扎实依据。
实测 Gemini 4 Neon:超越 Opus 5.5,比肩Carbon,快3倍省4成
谷歌发布 Gemini 4 Neon 模型,实测显示其在 18 项同台基准中胜出 Opus 5.5 共 16 项,Artificial Analysis 综合智能总榜以 61 分超越 Opus 5.5 与自家 Carbon,同时单题成本更低、速度更快。官方数据显示其在跨仓库修 bug、长文本检索和办公自动化等任务上表现突出,编码代理榜排名第一,不幻觉率达 86%。
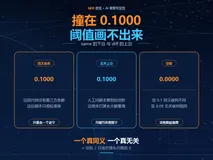
字面分撞在同一个数上,才轮到 embedding
60 对中文短文本重跑一遍:同义下沿 0.1000,无关上沿也是 0.1000,撞在一处,阈值画不出来。这篇把字面侧的真数据和边界样本摊开,再给接 embedding 的代码、四个象限和三条边界,说明哪类样本根本不值得上语义尺子。
基于微信小程序的旅游路线定制系统
本系统基于微信小程序开发智能雨伞取借平台:后端采用Java(Spring Boot)实现高并发业务处理;前端用Vue构建响应式界面,支持实时状态展示与地图定位;MySQL统一管理用户、伞具及借还数据;依托微信生态,实现扫码即用、定位借还、在线支付等功能,兼顾高效性、稳定性和用户体验。
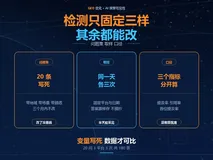
AI 引用检测:60 行 Python 落地
AI 有没有引用你的内容,不能靠搜一下看看。这篇给一套可复盘的检测方案:20 条固定问题、同一天三平台各三次、提及率与引用率分开算,附 60 行零依赖 Python 实现,以及跑完之后那张表怎么读。
出账跑批窗口重叠:FC定时触发器分片错峰
某园区月度出账因定时触发器重叠与UTC时区偏差,导致单晚重复出账412张、撞上充值高峰。通过8片错峰调度(2分钟间隔)、账期+分片判重键、CRON_TZ时区校准三大治理,实现零重复、写峰值降73%(3400→900行/秒),方案适用于定时批处理场景。(239字)
装 Git 插件被 pnpm 拦下 `prepare`?分清构建许可、bundle 声明与加载激活
从 Git 源码安装 DSH 插件时,`dsh plugin add` 首次执行常会失败,报错指向被阻止的 `prepare` 脚本。最容易混淆的是三件事:这是「构建许可」问题,不是包地址或 profile 写错;需要修改的是**目标 profile** 里的 `pnpm-workspace.yaml`,而非插件 checkout 中的同名文件;pnpm 成功退出、bundle 进入配置层、插件实际加载起来,则是三项彼此独立的观察结果。本文按「失败含义 → 找准 profile → 五步处理 → 安装与激活 → 安全边界」展开。
模型已经请求调用工具,工具却没跑:拆解 DSH 的预执行、守卫、执行与结果改写四段流水线
在 DeepSeek Harness 会话中看到一条 `tool/call`,界面上也显示「等待中」的卡片,并不意味着工具主体已经运行。排查时容易混淆四件事:`tool/call` 只是执行前的请求记录;一次性批准后仍要经过单调守卫;`tools/result` 展示的并非工具原始输出;拒绝和包装器报错都可能形成看似相同的错误结果。本文沿着「入口 → 审批 → 守卫与执行 → 结果到达模型 → 追踪与排查 → 安全边界」梳理完整流水线。
数据采集中的代理IP选型与技术实践:API接入、质量检测及稳定性分析
本文从实战出发,详解代理IP在数据采集等场景中的关键应用:涵盖核心参数、多语言接入(Python/Java/Go)、IP质量检测、高并发稳定性测试、地域准确性验证、会话管理及安全配置,并提供常见问题排查与选型建议,助力构建稳定可维护的网络连接体系。
配置改了却没生效?拆解 DSH 的四层补丁顺序、整行替换语义与真正的生效时机
在 DeepSeek Harness 里改了配置却看不到变化,通常不是「配置没写对」,而是没搞清四件事:bundle、profile、home、命令行补丁的覆盖顺序,补丁替换的是整行 `config` 而不是逐键深度合并,home 层竟然比 profile 层更靠后,以及「文件里写了」根本不等于「这次启动真的读了它」。本文按「四层顺序 → 替换单位 → 反直觉的 home 层 → 命令行与生效时机 → 升级后维护 → 排查与边界」逐层拆开。
`ctx.on` 注册了却没收到事件?拆解 DSH 插件的五种分发契约、waterfall 续传与生命周期
在 DeepSeek Harness 插件中使用 `ctx.on` 监听事件,常见的困惑有三类:给 `emit` 注册 `async` 回调后,发现发布方并未等它执行完;写了 `waterfall` 监听器,却因漏掉续传调用让下游链条停摆;把 `tool/call` 这类持久会话记录误当成同名 Cordis 事件来监听。本文从类型声明、五种分发模式、`waterfall` 续传、持久会话事件的辨析,到生命周期与边界,逐一说明。
基于 aiohttp TraceConfig 与 Prometheus 的异步爬虫全链路监控实战(含 PromQL 与告警规则)
爬虫进程正常存活却静默丢数,往往源于总成功率掩盖重试、均值延迟掩盖长尾及 HTTP 200 假成功。本文基于 aiohttp TraceConfig 与 Prometheus,构建低基数域名级监控与加密分桶 Histogram,搭配 Grafana 看板实现各域名首包成功率与 P95 延迟的五分钟级实时预警。
把官网当输入核对:品牌页、服务页、联系信息的一致性自查方法
本文提供低成本官网自查法:聚焦品牌介绍、核心服务、联系与资质三类页面,逐项核对信息缺失、矛盾与过时问题,形成可执行整改清单。强调信息完整是被准确理解的前提,而非保证AI推荐,助力企业先夯实基础再优化内容。
GDPR 聊天记录留存实务:留存期、删除与跨境传输
GDPR 对 AI 客服聊天记录有什么具体要求?先把定性说清:欧盟买家在聊天里留下的名字、邮箱、订单号、对话内容,都是个人数据。团队在中国、客户在欧盟,GDPR 照样管——向欧盟境内的人提供商品或服务,就落进适用范围。要求可以收成四条:留存期按目的定、删除请求一个月内回应、处理记录与告知要齐全、安全与最小化做到位。四条里最容易踩坑的是第一条,很多人以为 GDPR 规定了「必须存多少天」,其实没有这个数字。
用 Python SDK 跑通第一个 DSH 任务:工作区、home 与 `sdk-minimal` 的边界
安装 `deepseek-harness-sdk` 后跑第一个任务,最容易踩的不是 `pip install` 本身,而是把 Python 当成独立运行时、把 `--workspace` 当成沙箱边界、把 `dsh web` 当成 SDK 服务端,或者在多次测试之间混用 `--dsh-home` 和 `--session-id`。本文按「环境准备 → 最小示例 → Python 与 `sdk-minimal` 的分工 → 默认能力与补丁扩展 → 排障与安全边界」完整拆解第一次 SDK 调用。
连锁零售指标语义层如何建设?让 Data Agent 正确理解同店增长、门店坪效与人效
可以先把可比门店池、有效经营面积和实际工时建成可查询的业务数据,再通过指标语义层明确三项指标的计算与汇总规则,供 BI 和 Data Agent 共同调用。
GEO首月交付怎么核对:问题清单、基线记录与改动明细
本文详解GEO(生成式引擎优化)首月合作的关键验收标准:强调可复核的工作痕迹而非表面数据。聚焦四大核心交付物——基线记录、问题调研表、内容改动明细、信息源清单,均需具备可追溯、可验证、有依据的特征。明确首月目标是确认“动作是否发生”,而非“效果是否显现”,助力企业建立理性、可持续的合作评估机制。
混合云与容器环境下的运维进阶:四级台阶有什么不同
本文阐述云原生环境下智能运维四级框架(看得见→看得懂→会关联→能自愈)的演进要点:L1转向实时资产同步,L2/L3需联动编排系统应对动态拓扑与弹性伸缩,L4强化爆炸半径控制(命名空间/可用区限定、熔断机制),并强调闭环验证与数据驱动验收。
动态代理IP和静态代理IP有什么区别?一文看懂两者的原理与应用场景
本文详解动态与静态代理IP的核心区别:动态IP按规则自动更换,适合多地区采集与测试;静态IP在有效期内固定,利于会话保持与白名单配置。还介绍粘性会话等实用机制,并强调应以实际业务需求(非标签)为导向选型。
账单库误删回档:RDS时间点恢复与差异回填
账单库误删回档是通过时间点恢复至临时实例+主键差异回填,精准修复逻辑误删(如删分区),42分钟恢复、90秒补3.6万行,保障月末结算零差错。适用binlog窗口内事故,建议账单库binlog保留30天。(239字)

大数据与机器学习
大数据领域前沿技术分享与交流,这里不止有技术干货、学习心得、企业实践、社区活动,还有未来。

