这是一次个人使用后的选型笔记。我以前会给多个模型同一条提示词,然后按“哪一个回答更好”做主观选择。后来发现,只要任务类型不同,评价标准就应该不同;把聊天、代码生成、长文档分析和批处理混在一起测试,结论通常不稳定。
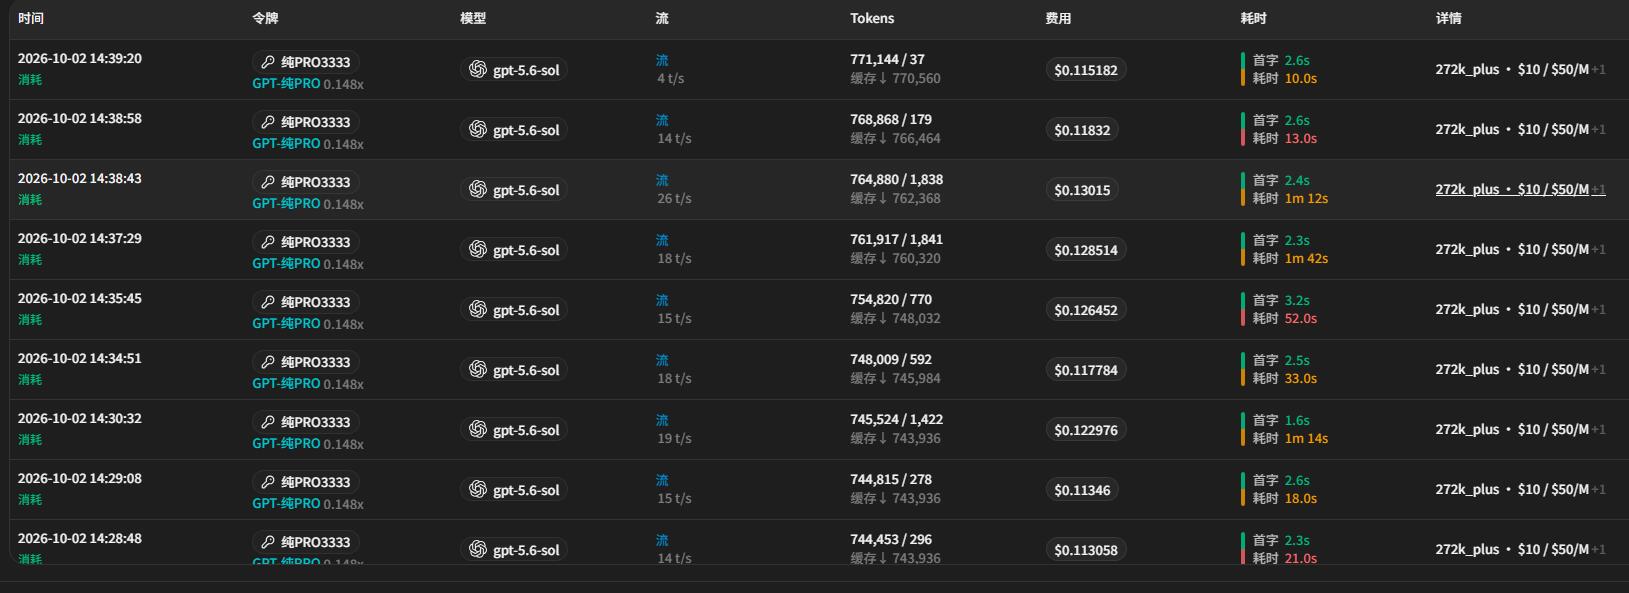
调用记录里可以看到输入、缓存、输出、耗时和费用等信息。对我来说,这些字段的价值在于让不同任务有可对照的事实基础,而不是只根据一次回答的观感判断。
| 任务组 | 测试目标 | 重点数据 |
|---|---|---|
| 短问答 | 交互是否顺畅 | 首字时间、回答准确性 |
| 代码任务 | 能否稳定完成改动 | 工具调用、重试、输出质量 |
| 长上下文 | 成本是否可控 | 缓存输入、输出、最终费用 |
| 批处理 | 是否适合持续运行 | 成功率、吞吐、异常恢复 |
每一组都会固定提示词、模型参数和输出限制,至少重复几次。这样得到的结果才更容易复现,也能减少偶发网络或单次输出差异的影响。
在短问答中,首字时间可能很重要;在长文档分析中,缓存和最终费用可能更关键;在批处理中,成功率和重试后成本甚至会比单次延迟更重要。
因此我不会建立一个“全场景第一名”的表,而会为每个任务选择更合适的模型与渠道。统一入口和页面信息能减少重复接入的工作,但真正的取舍仍然来自任务数据。
选定候选项后,我通常会先放少量真实流量,观察几天内的请求记录:是否有异常错误、缓存是否符合预期、输出是否失控、费用是否与测试接近。确认数据稳定后,再决定是否逐步扩大。
本文是个人测试流程整理,图片和数字仅为 2026 年 10 月 2 日的样本。不同模型、渠道、价格和实际调用结果都可能变化,应以实际使用时页面和账单为准。
版权声明:本文内容由阿里云实名注册用户自发贡献,版权归原作者所有,阿里云开发者社区不拥有其著作权,亦不承担相应法律责任。具体规则请查看《阿里云开发者社区用户服务协议》和《阿里云开发者社区知识产权保护指引》。如果您发现本社区中有涉嫌抄袭的内容,填写侵权投诉表单进行举报,一经查实,本社区将立刻删除涉嫌侵权内容。