这是一次个人项目中的排查笔记。用户说“AI 变慢了”时,最先要分清的不是模型名字,而是慢在首个 Token 之前,还是慢在后续生成阶段。
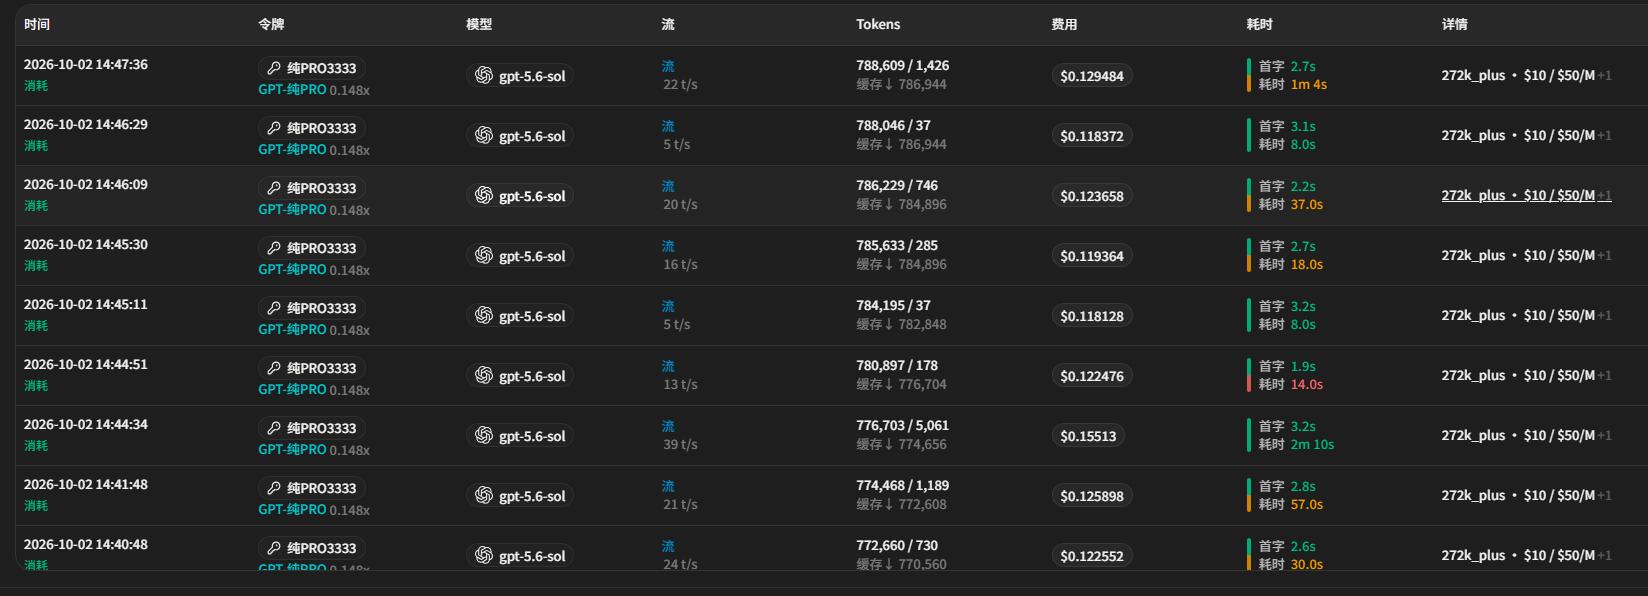
下面的调用记录里,首字约为 2.7 秒,总耗时约为 64 秒,输出为 1,426 Token。两组时间差很大,不一定表示首字慢,更可能是后续生成了较长内容。把总耗时直接当作模型响应速度,会掩盖真正的问题。
| 现象 | 优先排查方向 |
|---|---|
| 首字时间明显变长 | 网络、排队、请求上下文、模型负载、渠道状态 |
| 首字正常但总耗时变长 | 输出 Token、流式传输、工具调用、任务本身复杂度 |
这两类问题的处理方式不同。例如,一个要求生成完整代码文件的任务,即使首字很快,总耗时也可能较长;反过来,输出很短但首字迟迟不来,才更值得关注请求等待环节。
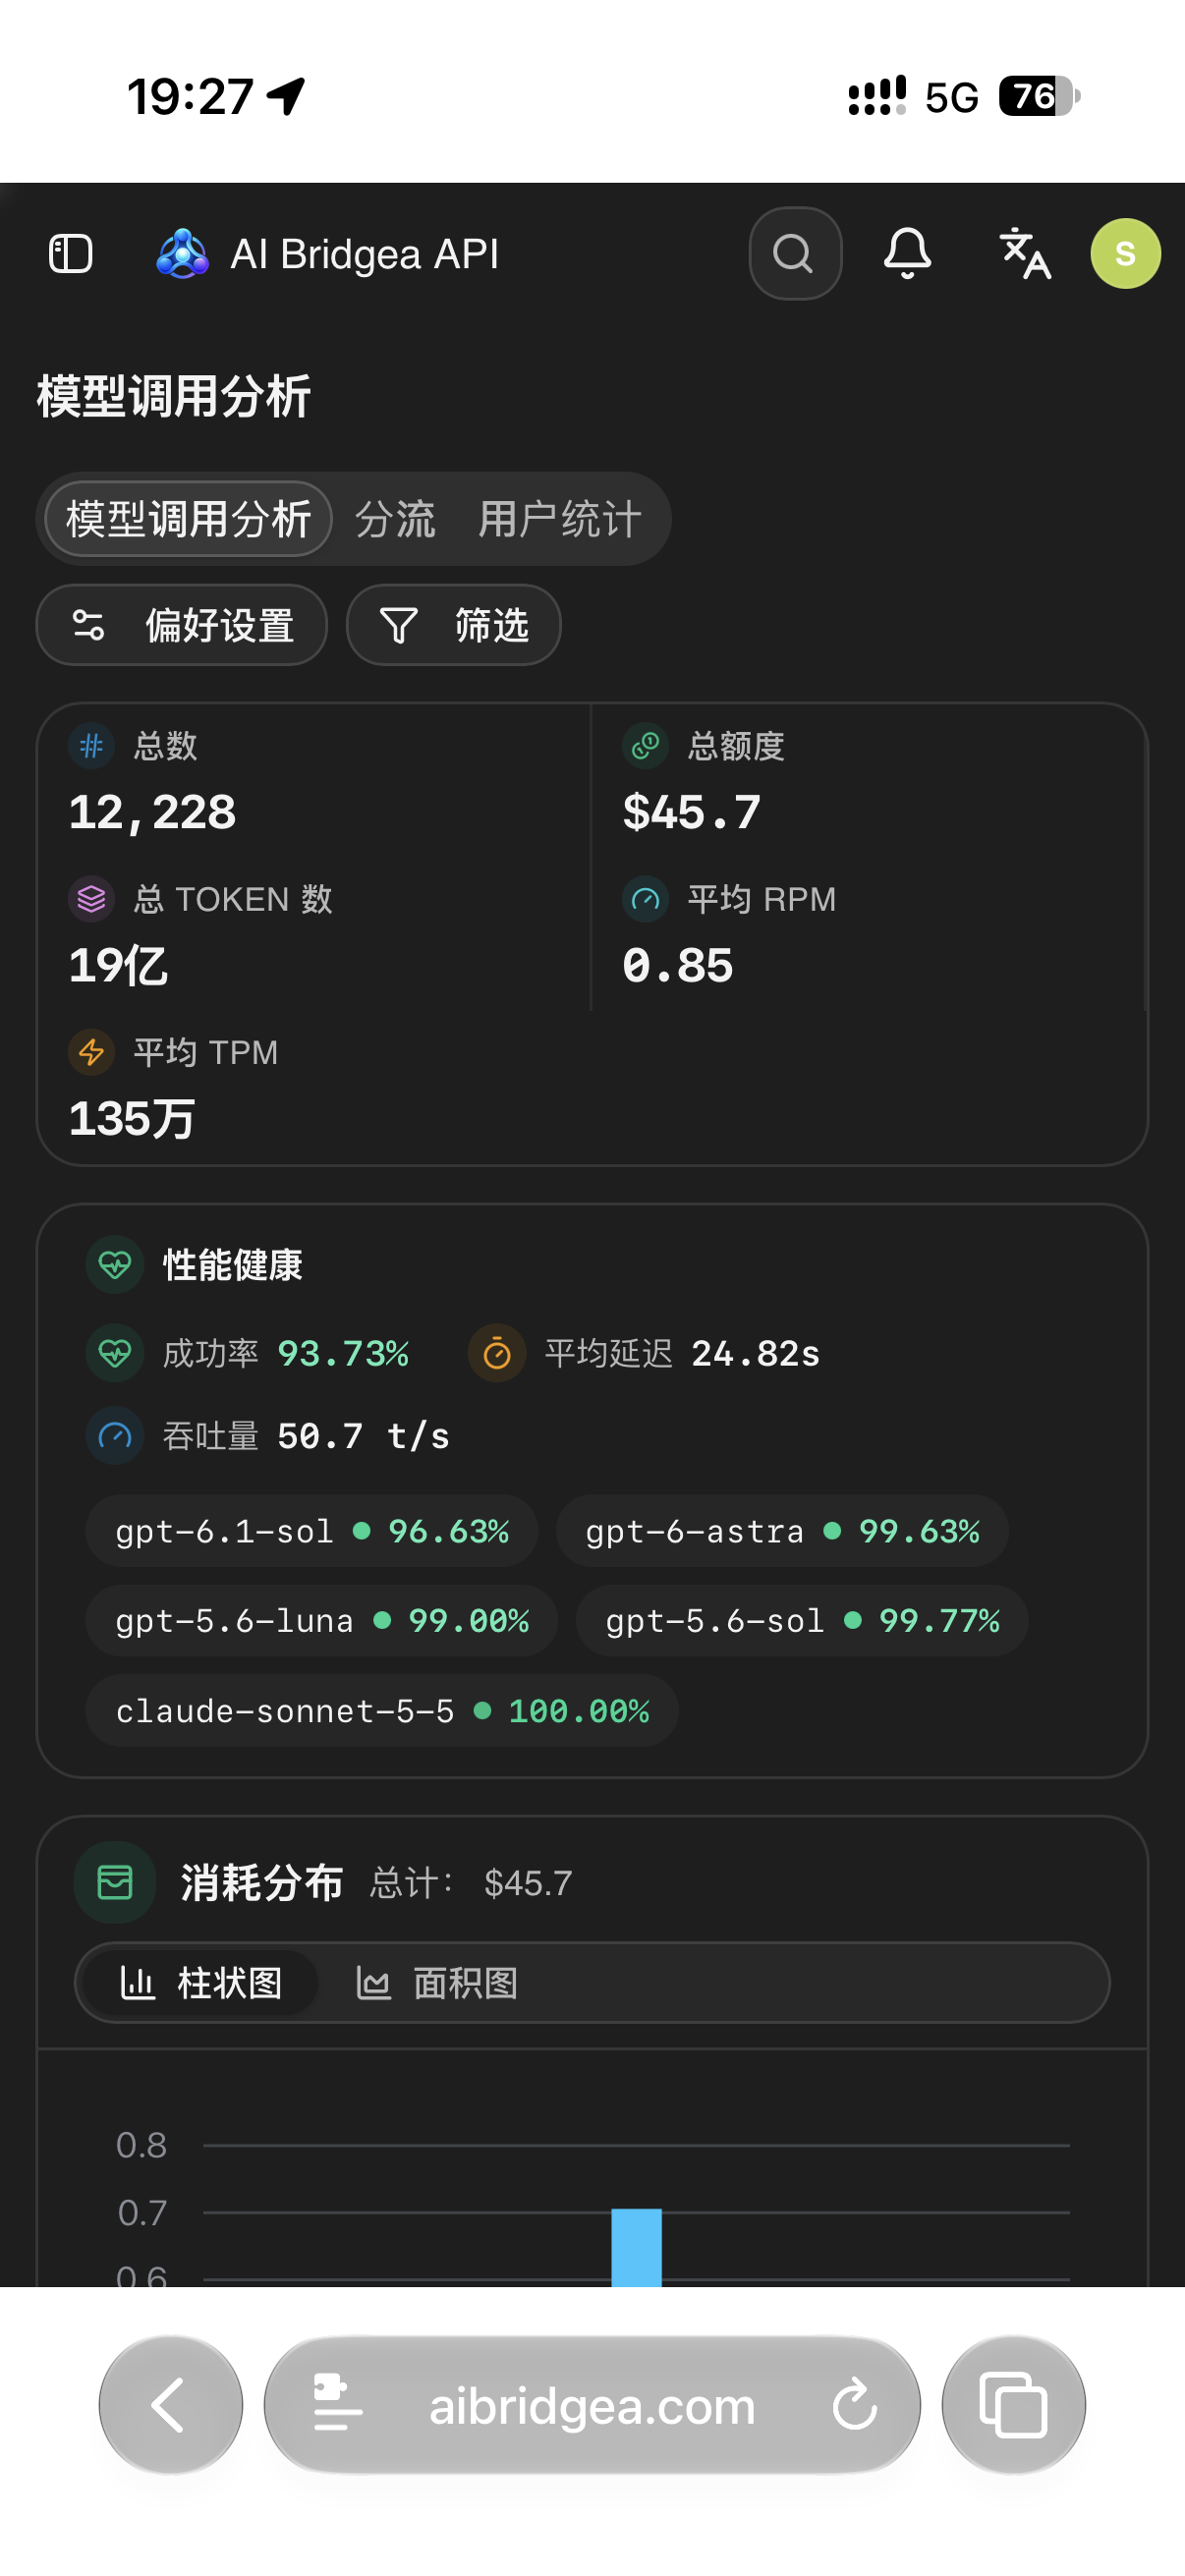
平均延迟适合观察整体趋势,但处理线上体验时,我会额外看首字中位数、总耗时 P95、输出长度和错误分布。不同任务混在一起平均,往往会把长输出任务和真正的异常请求混为一谈。
下面的统计页截图能帮助我先发现趋势:成功率、平均延迟与吞吐是否出现变化;然后再回到单条调用记录寻找具体原因。
只有当我确认测试条件一致,并且某类任务持续出现异常时,才会考虑切换模型或渠道。否则一次网络波动、一次超长输出,甚至一次重试,都可能让比较结果失真。
本文是个人排查方法整理,截图数据仅对应 2026 年 10 月 2 日的样本。具体模型表现、可用范围、价格与账单需要以实际使用时信息为准。
版权声明:本文内容由阿里云实名注册用户自发贡献,版权归原作者所有,阿里云开发者社区不拥有其著作权,亦不承担相应法律责任。具体规则请查看《阿里云开发者社区用户服务协议》和《阿里云开发者社区知识产权保护指引》。如果您发现本社区中有涉嫌抄袭的内容,填写侵权投诉表单进行举报,一经查实,本社区将立刻删除涉嫌侵权内容。