文章目录:
2.2 方式二:ALTER TABLE ... ADD INDEX ...
2.3 方式三:CREATE INDEX ... ON ...
4.1.3 经常 GROUP BY 和 ORDER BY 的列
4.1.4 UPDATE、DELETE 的 WHERE 条件列
4.1.11 在多个字段都要创建索引的情况下,联合索引优于单值索引
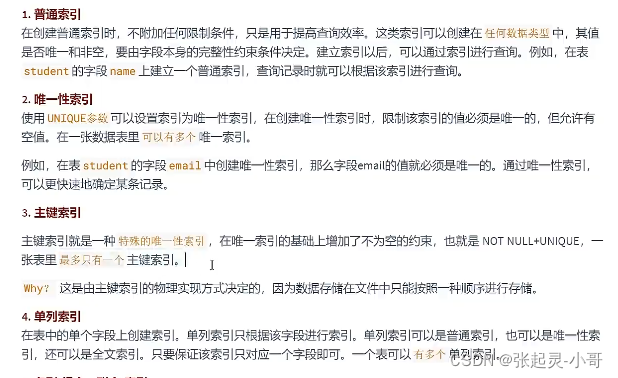
1.索引的分类
MySQL的索引包括普通索引、唯一性索引、全文索引、单列索引、多列索引和空间索引等。
从功能逻辑上说,索引主要有 4 种,分别是普通索引、唯一索引、主键索引、全文索引。
按照物理实现方式,索引可以分为 2 种:聚簇索引和非聚簇索引。
按照作用字段个数进行划分,分成单列索引和联合索引。

2.创建索引的三种方式
2.1 方式一:CREATE TABLE
CREATE DATABASE dbtest2;
USE dbtest2;
CREATE TABLE dept (
    dept_id INT PRIMARY KEY AUTO_INCREMENT,
    dept_name VARCHAR(20)
);
SHOW INDEX FROM dept;

CREATE TABLE emp (
    emp_id INT PRIMARY KEY AUTO_INCREMENT,
    emp_name VARCHAR(20) UNIQUE,
    dept_id INT,
    CONSTRAINT fk_emp_dept_id FOREIGN KEY(dept_id) REFERENCES dept(dept_id)
);
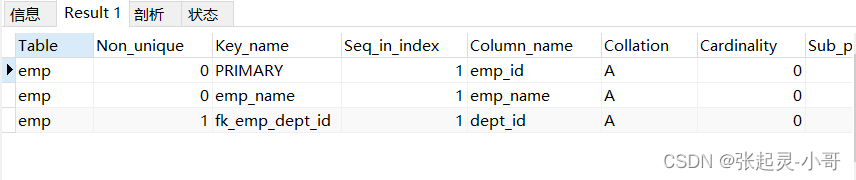
SHOW INDEX FROM emp;
2.1.2 普通索引
CREATE TABLE book (
  book_id INT,
  book_name VARCHAR(100),
  `authors` VARCHAR(100),
  info VARCHAR(100),
  `comment` VARCHAR(100),
  year_publication YEAR,
  INDEX idx_bname(book_name)
);
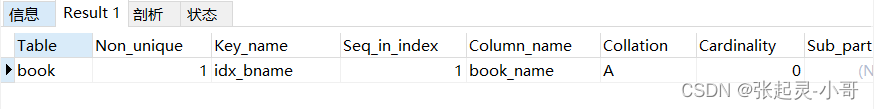
SHOW INDEX FROM book;
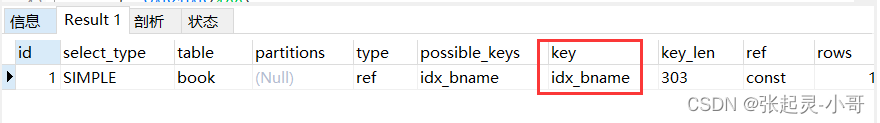
如果我们写一个简单的sql语句,在where后面用 book_name 来筛选,可以通过 explain 性能分析工具来看看是什么样的?
EXPLAIN
SELECT *
FROM book
WHERE book_name = 'mysql';
2.1.3 唯一性索引
CREATE TABLE book1 (
    book_id INT,
    book_name VARCHAR(100),
    `authors` VARCHAR(100),
    info VARCHAR(100),
    `comment` VARCHAR(100),
    year_publication YEAR,
    UNIQUE INDEX uk_idx_cmt(`comment`)
);
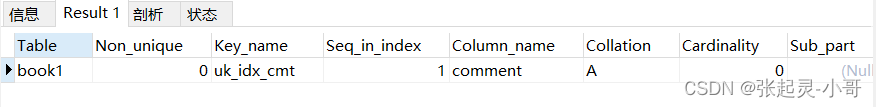
SHOW INDEX FROM book1;
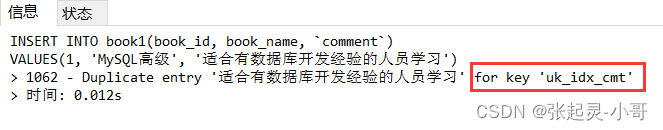
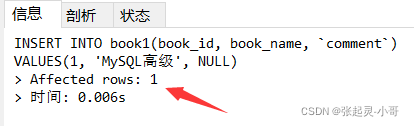
接下来,依次向表中插入三条记录,在插入第二条记录的时候,就会报错。而第三条记录是正常执行的。
INSERT INTO book1(book_id, book_name, `comment`)
VALUES(1, 'MySQL高级', '适合有数据库开发经验的人员学习');
INSERT INTO book1(book_id, book_name, `comment`)
VALUES(1, 'MySQL高级', '适合有数据库开发经验的人员学习');
INSERT INTO book1(book_id, book_name, `comment`)
VALUES(1, 'MySQL高级', NULL);
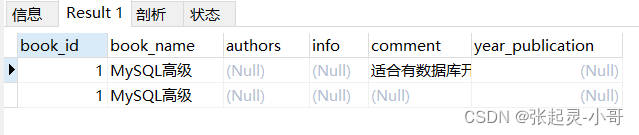
最终,在book1这张表中,将存在两条记录。
2.1.4 主键索引
CREATE TABLE book2 (
    book_id INT PRIMARY KEY,
    book_name VARCHAR(100),
    `authors` VARCHAR(100),
    info VARCHAR(100),
    `comment` VARCHAR(100),
    year_publication YEAR
);
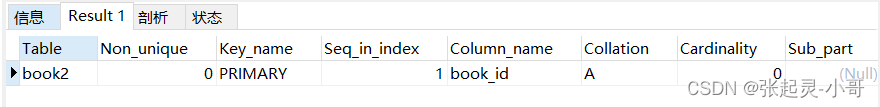
SHOW INDEX FROM book2;
2.1.5 单列索引
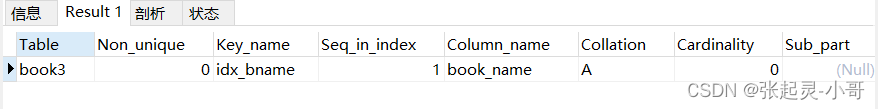
其实我们上面创建的那些都是单列索引。
CREATE TABLE book3 (
    book_id INT ,
    book_name VARCHAR(100),
    AUTHORS VARCHAR(100),
    info VARCHAR(100) ,
    COMMENT VARCHAR(100),
    year_publication YEAR,
    UNIQUE INDEX idx_bname(book_name)
);
SHOW INDEX FROM book3;
2.1.6 联合索引
CREATE TABLE book4 (
    book_id INT ,
    book_name VARCHAR(100),
    AUTHORS VARCHAR(100),
    info VARCHAR(100) ,
    COMMENT VARCHAR(100),
    year_publication YEAR,
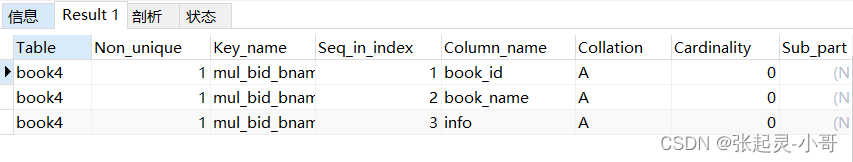
    INDEX mul_bid_bname_info(book_id, book_name, info)
);
SHOW INDEX FROM book4;
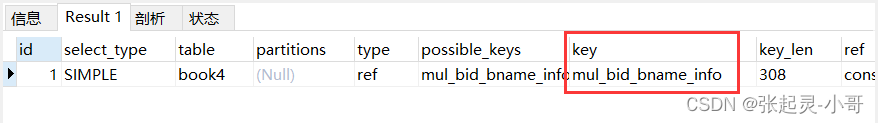
下面我们通过两条sql来分析一下,联合索引在查找过程中是怎么走的?
EXPLAIN
SELECT *
FROM book4
WHERE book_id = 1001 AND book_name = 'mysql';
解释:因为我们建的联合索引是 book_id, book_name, info 这样的顺序,所以在构建B+树的时候,就是先按照 book_id 来进行排序,当book_id相同时,再按照 book_name来排序,当book_name一样时,最后按照info来排序。(在B+树中,book_name实际上是位于book_id下方的,查找一定是先经过book_id、后经过book_name的)
所以上面这条sql,会先走book_id,再走book_name的。
EXPLAIN
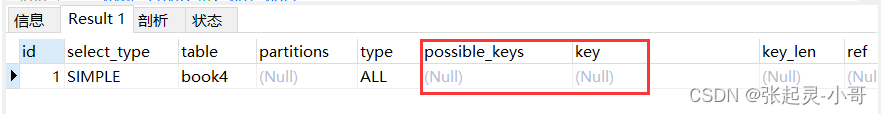
SELECT *
FROM book4
WHERE book_name = 'mysql';
经过上面的分析,那么这条sql为什么就没有走联合索引呢?(这book_name不是存在于联合索引中吗?),这里其实还是构建B+树的顺序问题,你要想在where筛选中走book_name索引,你就必须先要走book_id索引的,因为book_name在联合索引中位于book_id之后,所以在B+树中book_name就处于book_id下方,你连B+树的第二层(假设)都还没走到,又何谈到达B+树的第三层呢? 所以这条sql是不会走索引的。
2.1.7 全文索引
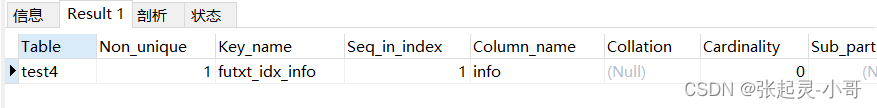
CREATE TABLE test4 (
    id INT NOT NULL,
    NAME CHAR(30) NOT NULL,
    age INT NOT NULL,
    info VARCHAR(255),
    FULLTEXT INDEX futxt_idx_info(info(50))
);
SHOW INDEX FROM test4;
2.2 方式二:ALTER TABLE ... ADD INDEX ...
DROP TABLE IF EXISTS book5;
CREATE TABLE book5 (
    book_id INT ,
    book_name VARCHAR(100),
    `authors` VARCHAR(100),
    info VARCHAR(100) ,
    `comment` VARCHAR(100),
    year_publication YEAR
);
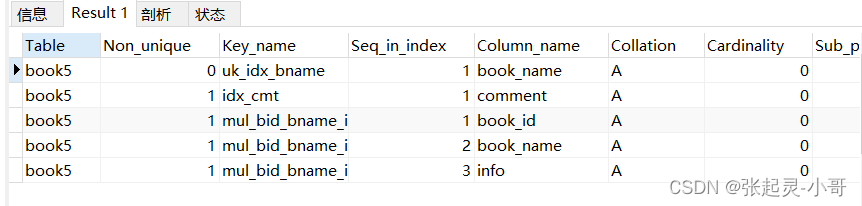
ALTER TABLE book5 ADD INDEX idx_cmt(`comment`);
ALTER TABLE book5 ADD UNIQUE INDEX uk_idx_bname(book_name);
ALTER TABLE book5 ADD INDEX mul_bid_bname_info(book_id, book_name, info);
SHOW INDEX FROM book5;
2.3 方式三:CREATE INDEX ... ON ...
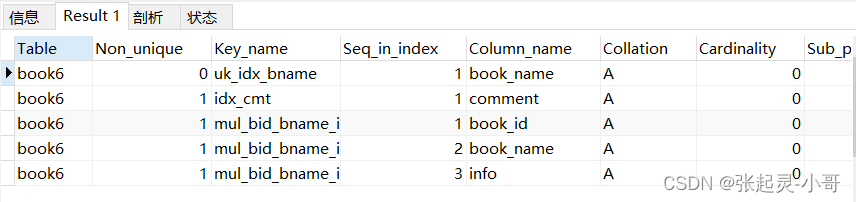
DROP TABLE IF EXISTS book6;
CREATE TABLE book6 (
    book_id INT ,
    book_name VARCHAR(100),
    `authors` VARCHAR(100),
    info VARCHAR(100) ,
    `comment` VARCHAR(100),
    year_publication YEAR
);
CREATE INDEX idx_cmt ON book6(`comment`);
CREATE UNIQUE INDEX uk_idx_bname ON book6(book_name);
CREATE INDEX mul_bid_bname_info ON book6(book_id, book_name, info);
SHOW INDEX FROM book6;