Hadoop是一个用Java开发的开源框架,它允许使用简单的编程模型在跨计算机集群的分布式环境中存储和处理大数据。它的设计是从单个服务器扩展到数千个机器,每个都提供本地计算和存储。特别适合写一次,读多次的场景。
Hadoop一般用于对大量数据执行完整统计分析的应用程序。
Hadoop架构图:
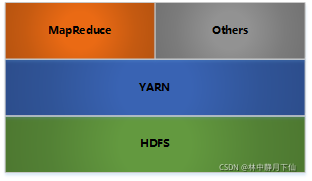
HDFS:分布式文件系统 Hadoop Distributed File System
YARN:分布式资源管理和作业调度
MapReduce:分布式计算
Hadoop的搭建有三种方式,本文章安装的是单机版
单机版:适合开发调试。
伪分布式版:适合模拟集群学习。
完全分布式:生产使用的模式。
Hadoop集群具体来说包含两个集群:HDFS集群和YARN集群,两者逻辑上分离,但物理上常在一起。
(1)HDFS集群:负责海量数据的存储,集群中的角色主要有 NameNode / DataNode/SecondaryNameNode。
(2)YARN集群:负责海量数据运算时的资源调度,集群中的角色主要有 ResourceManager /NodeManager
(3)MapReduce:它其实是一个应用程序开发包。
1.下载安装
我这里下载安装是最新的Hadoop 3.1.0版本 下载
解压并复制到安装目录
tar -zxvf hadoop-3.3.1.tar.gz -C /Users/lin/webServers/soft/hadoop-3.3.1
2.配置Hadoop
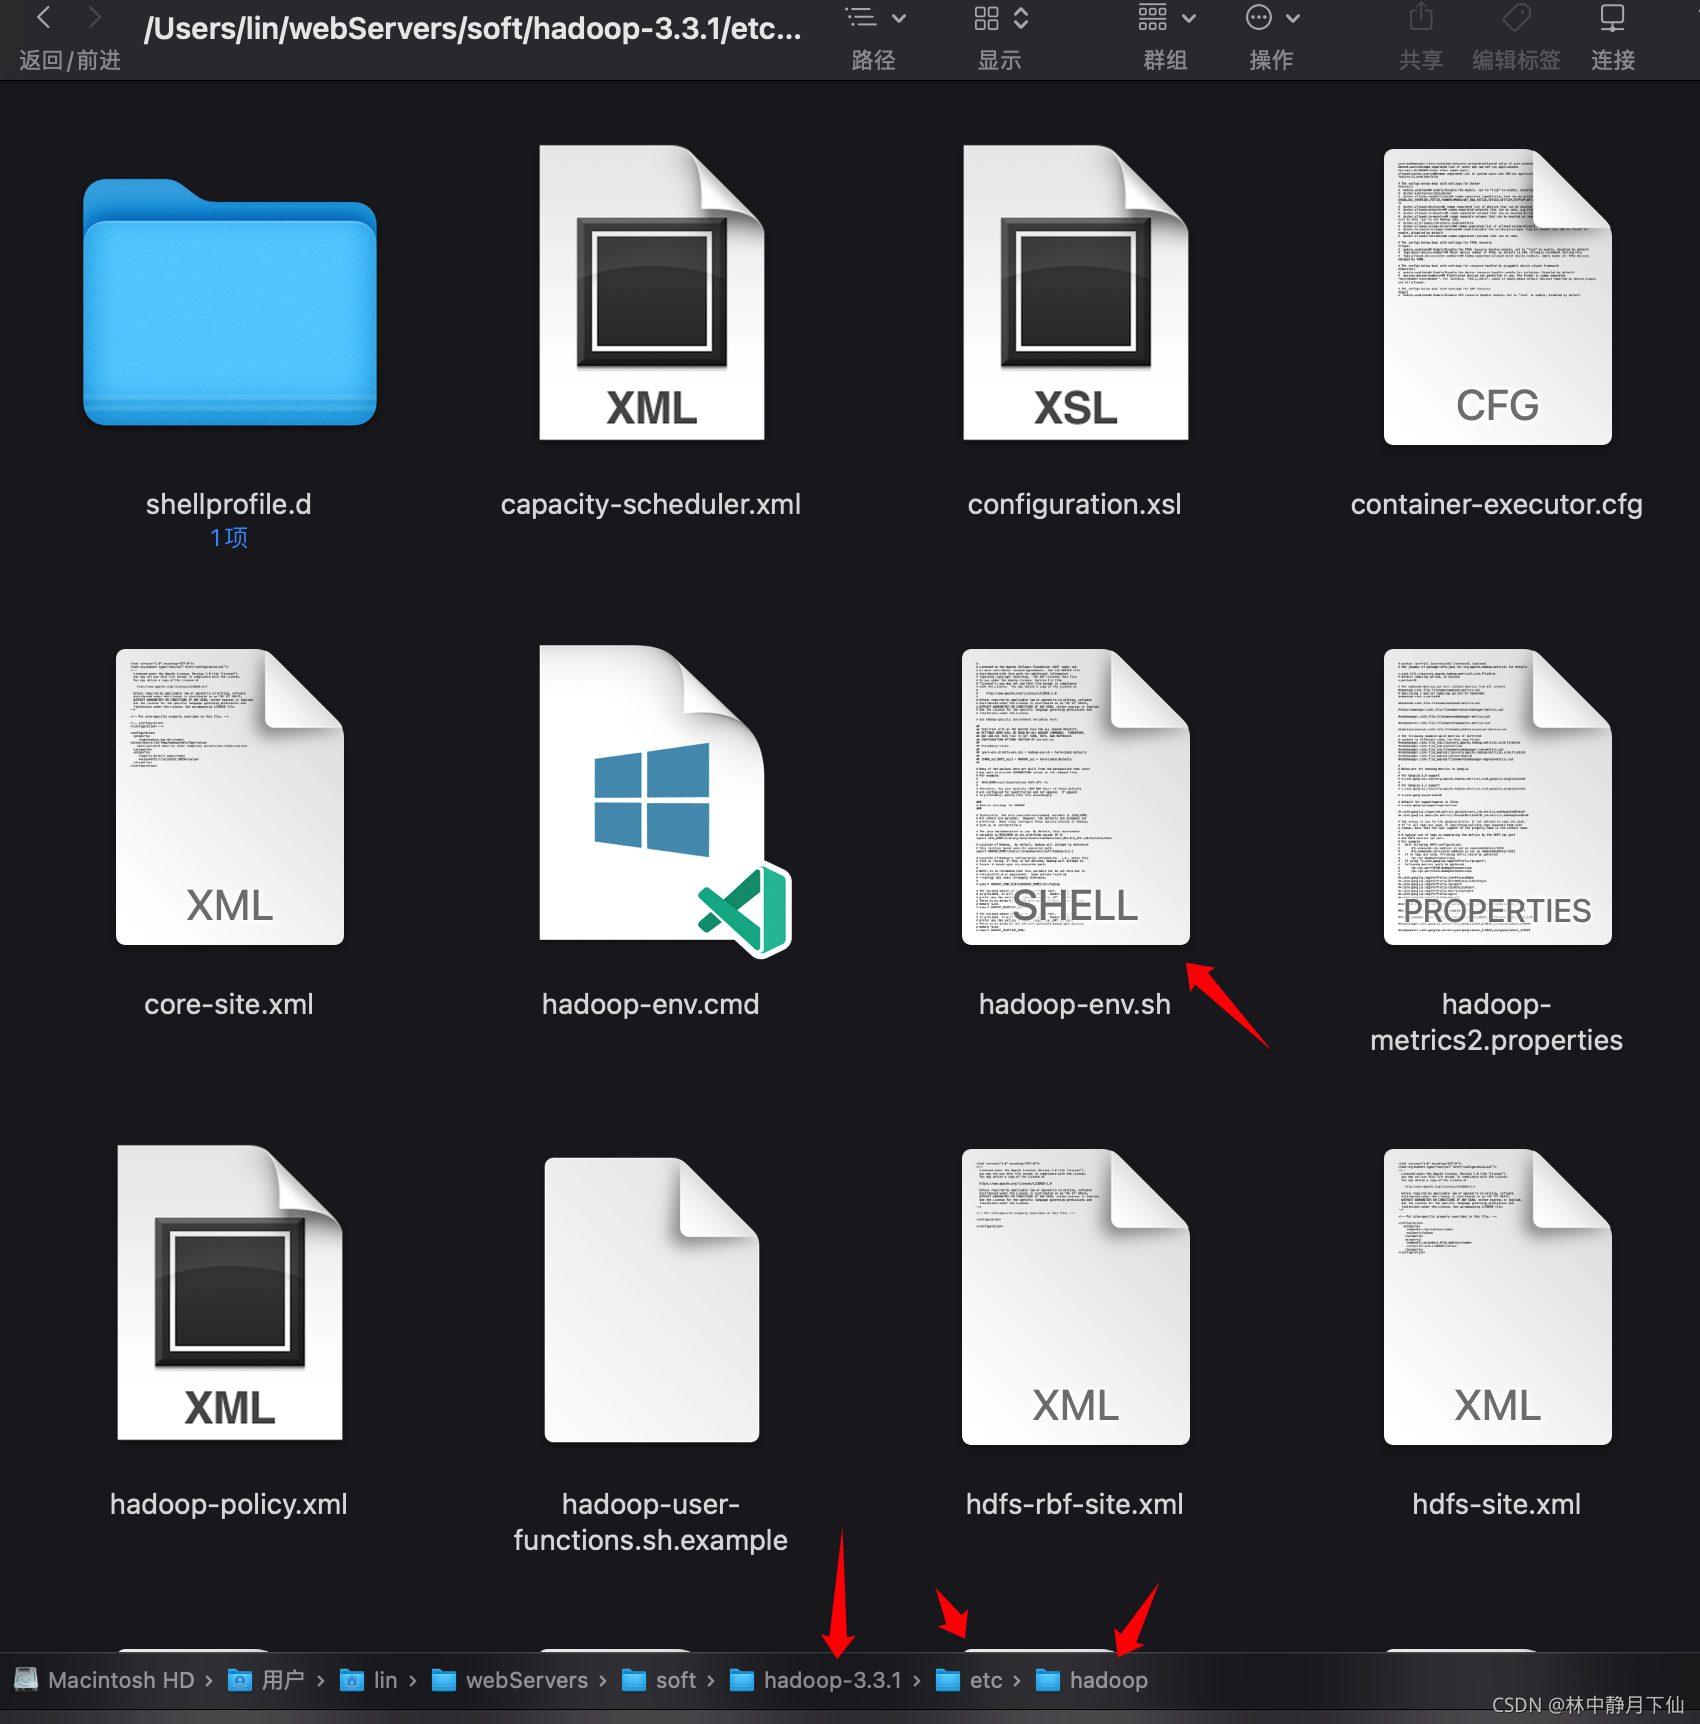
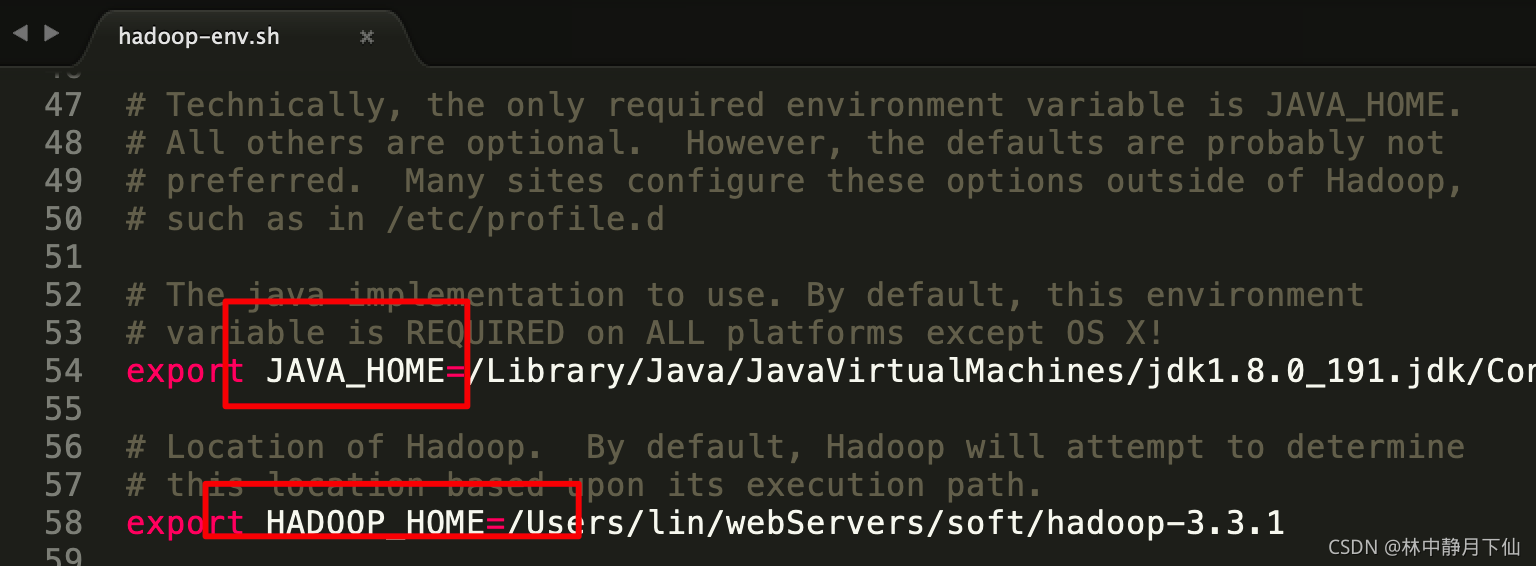
编辑目录下Hadoop目录下etc/haoop/hadoop-env.sh文件,大概50行左右,配置Hadoop当前目录和,Java目录
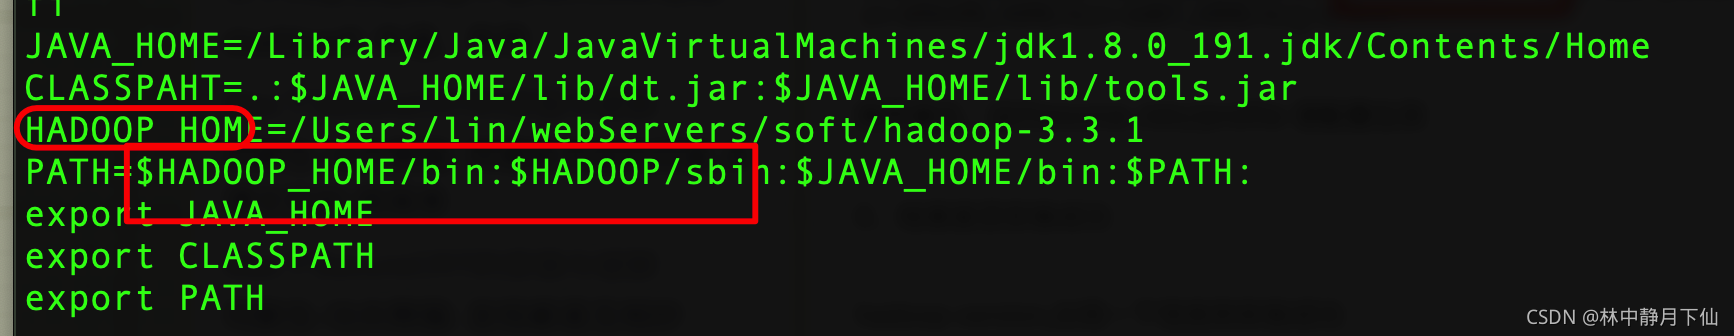
3.配置Hadoop环境变量
vim ~/profile
source ~/profile
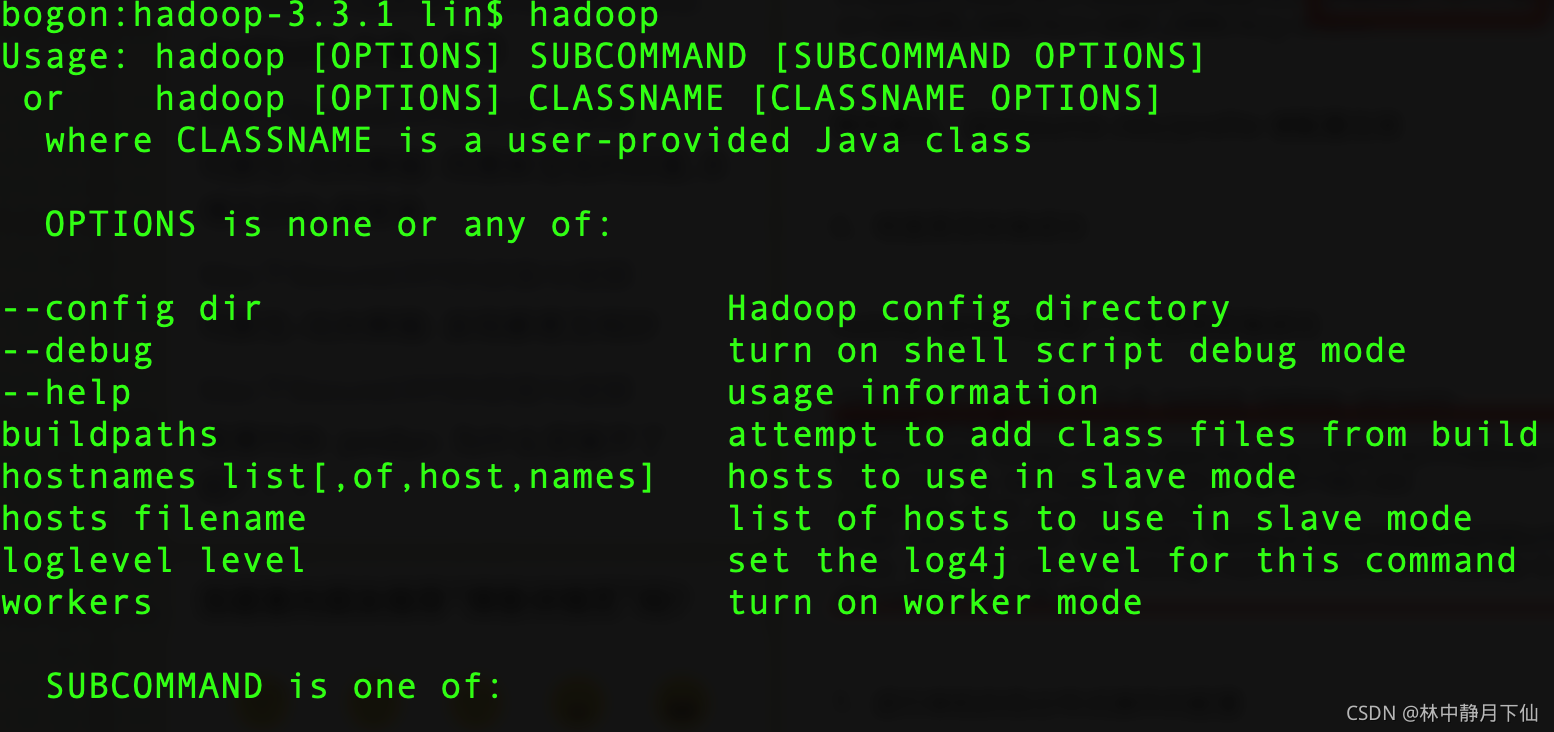
命令行输入 hadoop,出入以下信息说明配置成功
4.配置Hadoop组件之hdfs
配置/Users/lin/webServers/soft/hadoop-3.3.1/etc/hadoop/core-site.xml配置为
<configuration><property><name>hadoop.tmp.dir</name><value>/Users/lin/Temp/hadoop/hdfs/tmp</value><description>A base for other temporary directories.</description></property><property><name>fs.default.name</name><value>hdfs://localhost:8020</value></property></configuration>
配置hdfs备份数,修改/Users/lin/webServers/soft/hadoop-3.3.1/etc/hadoop/hdfs-site.xml加入
<configuration><property><name>dfs.replication</name><value>1</value></property><property><name>dfs.secondary.http.address</name><value>127.0.0.1:50090</value></property></configuration>
5.配置Hadoop组件之mapreduce
配置/Users/lin/webServers/soft/hadoop-3.3.1/etc/hadoop/mapred-site.xml,同样将>替换为
<configuration><property><name>mapred.job.tracker</name><value>localhost:8021</value></property></configuration>
6.格式化HDFS
这个操作相当于一个文件系统的初始化,执行命令
hdfs namenode -format
21/11/12 15:51:29 INFO namenode.FSImageFormatProtobuf: Saving image file /usr/local/Cellar/hadoop/hdfs/tmp/dfs/name/current/fsimage.ckpt_0000000000000000000 using no compression
21/11/12 15:51:29 INFO namenode.FSImageFormatProtobuf: Image file /usr/local/Cellar/hadoop/hdfs/tmp/dfs/name/current/fsimage.ckpt_0000000000000000000 of size 322 bytes saved in0 seconds.
21/11/12 15:51:29 INFO namenode.NNStorageRetentionManager: Going to retain 1 images with txid >=021/11/12 15:51:29 INFO util.ExitUtil: Exiting with status 021/11/12 15:51:29 INFO namenode.NameNode: SHUTDOWN_MSG:
/************************************************************
SHUTDOWN_MSG: Shutting down NameNode at jackies-macbook-pro.local/192.168.*.*
************************************************************/
7.设置主机免登
设置主机名:
sudo scutil --set HostName localhost
具体配置方法:
(1)ssh-keygen -t rsa      (一路回车直到完成)
(2)cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
(3)chmod og-wx ~/.ssh/authorized_keys
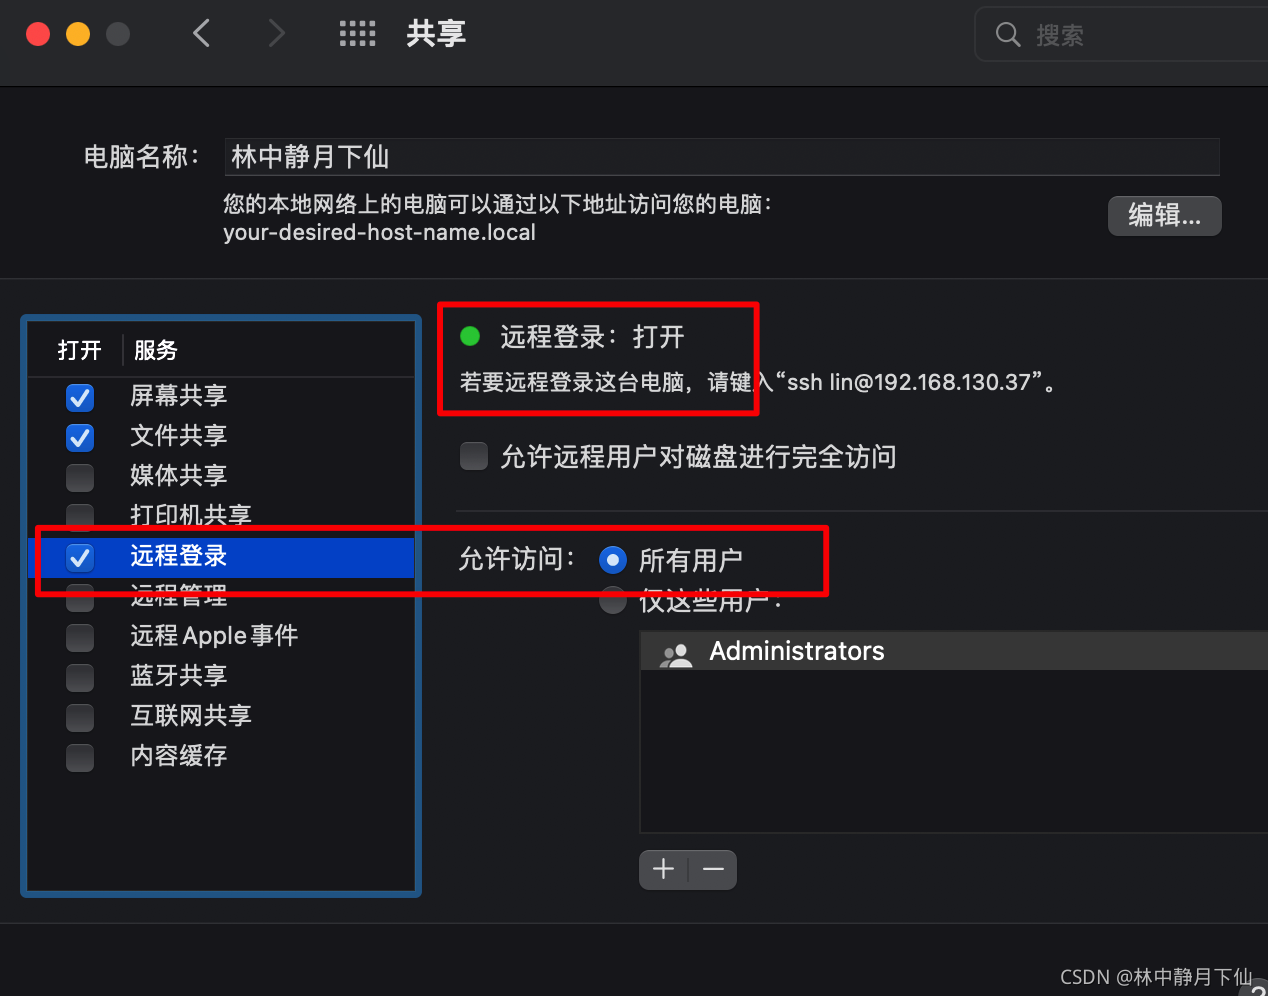
然后重启终端,在命令行下输入>ssh localhost 如果不需要输密码即可进入,证明设置成功。如果仍需要输入密码,那可能是文件权限的问题,尝试执行 chmod 755 ~/.ssh,如果提示Mac 22端口被拒绝,设置里打开共享即可
8. 启动关闭Hadoop服务
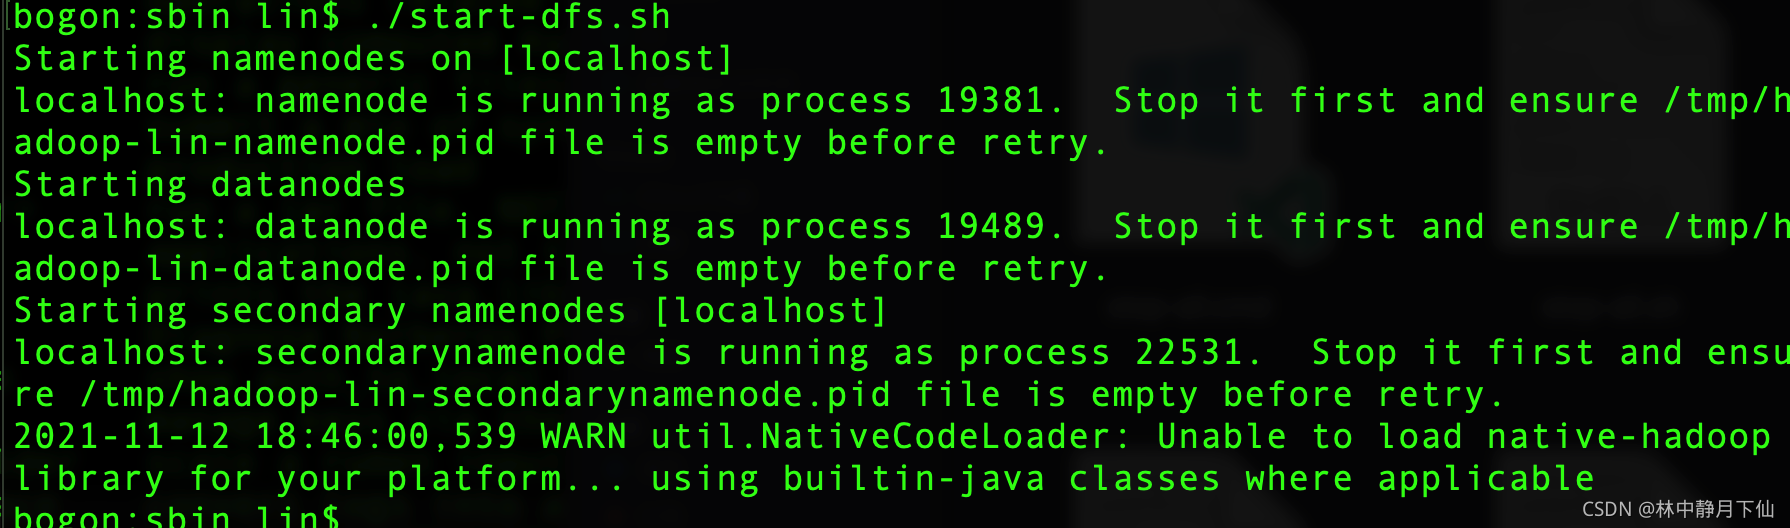
启动/关闭HDSF服务 ,/Users/lin/webServers/soft/hadoop-3.3.1/sbin目录下执行
./start-dfs.sh
./stop-dfs.sh
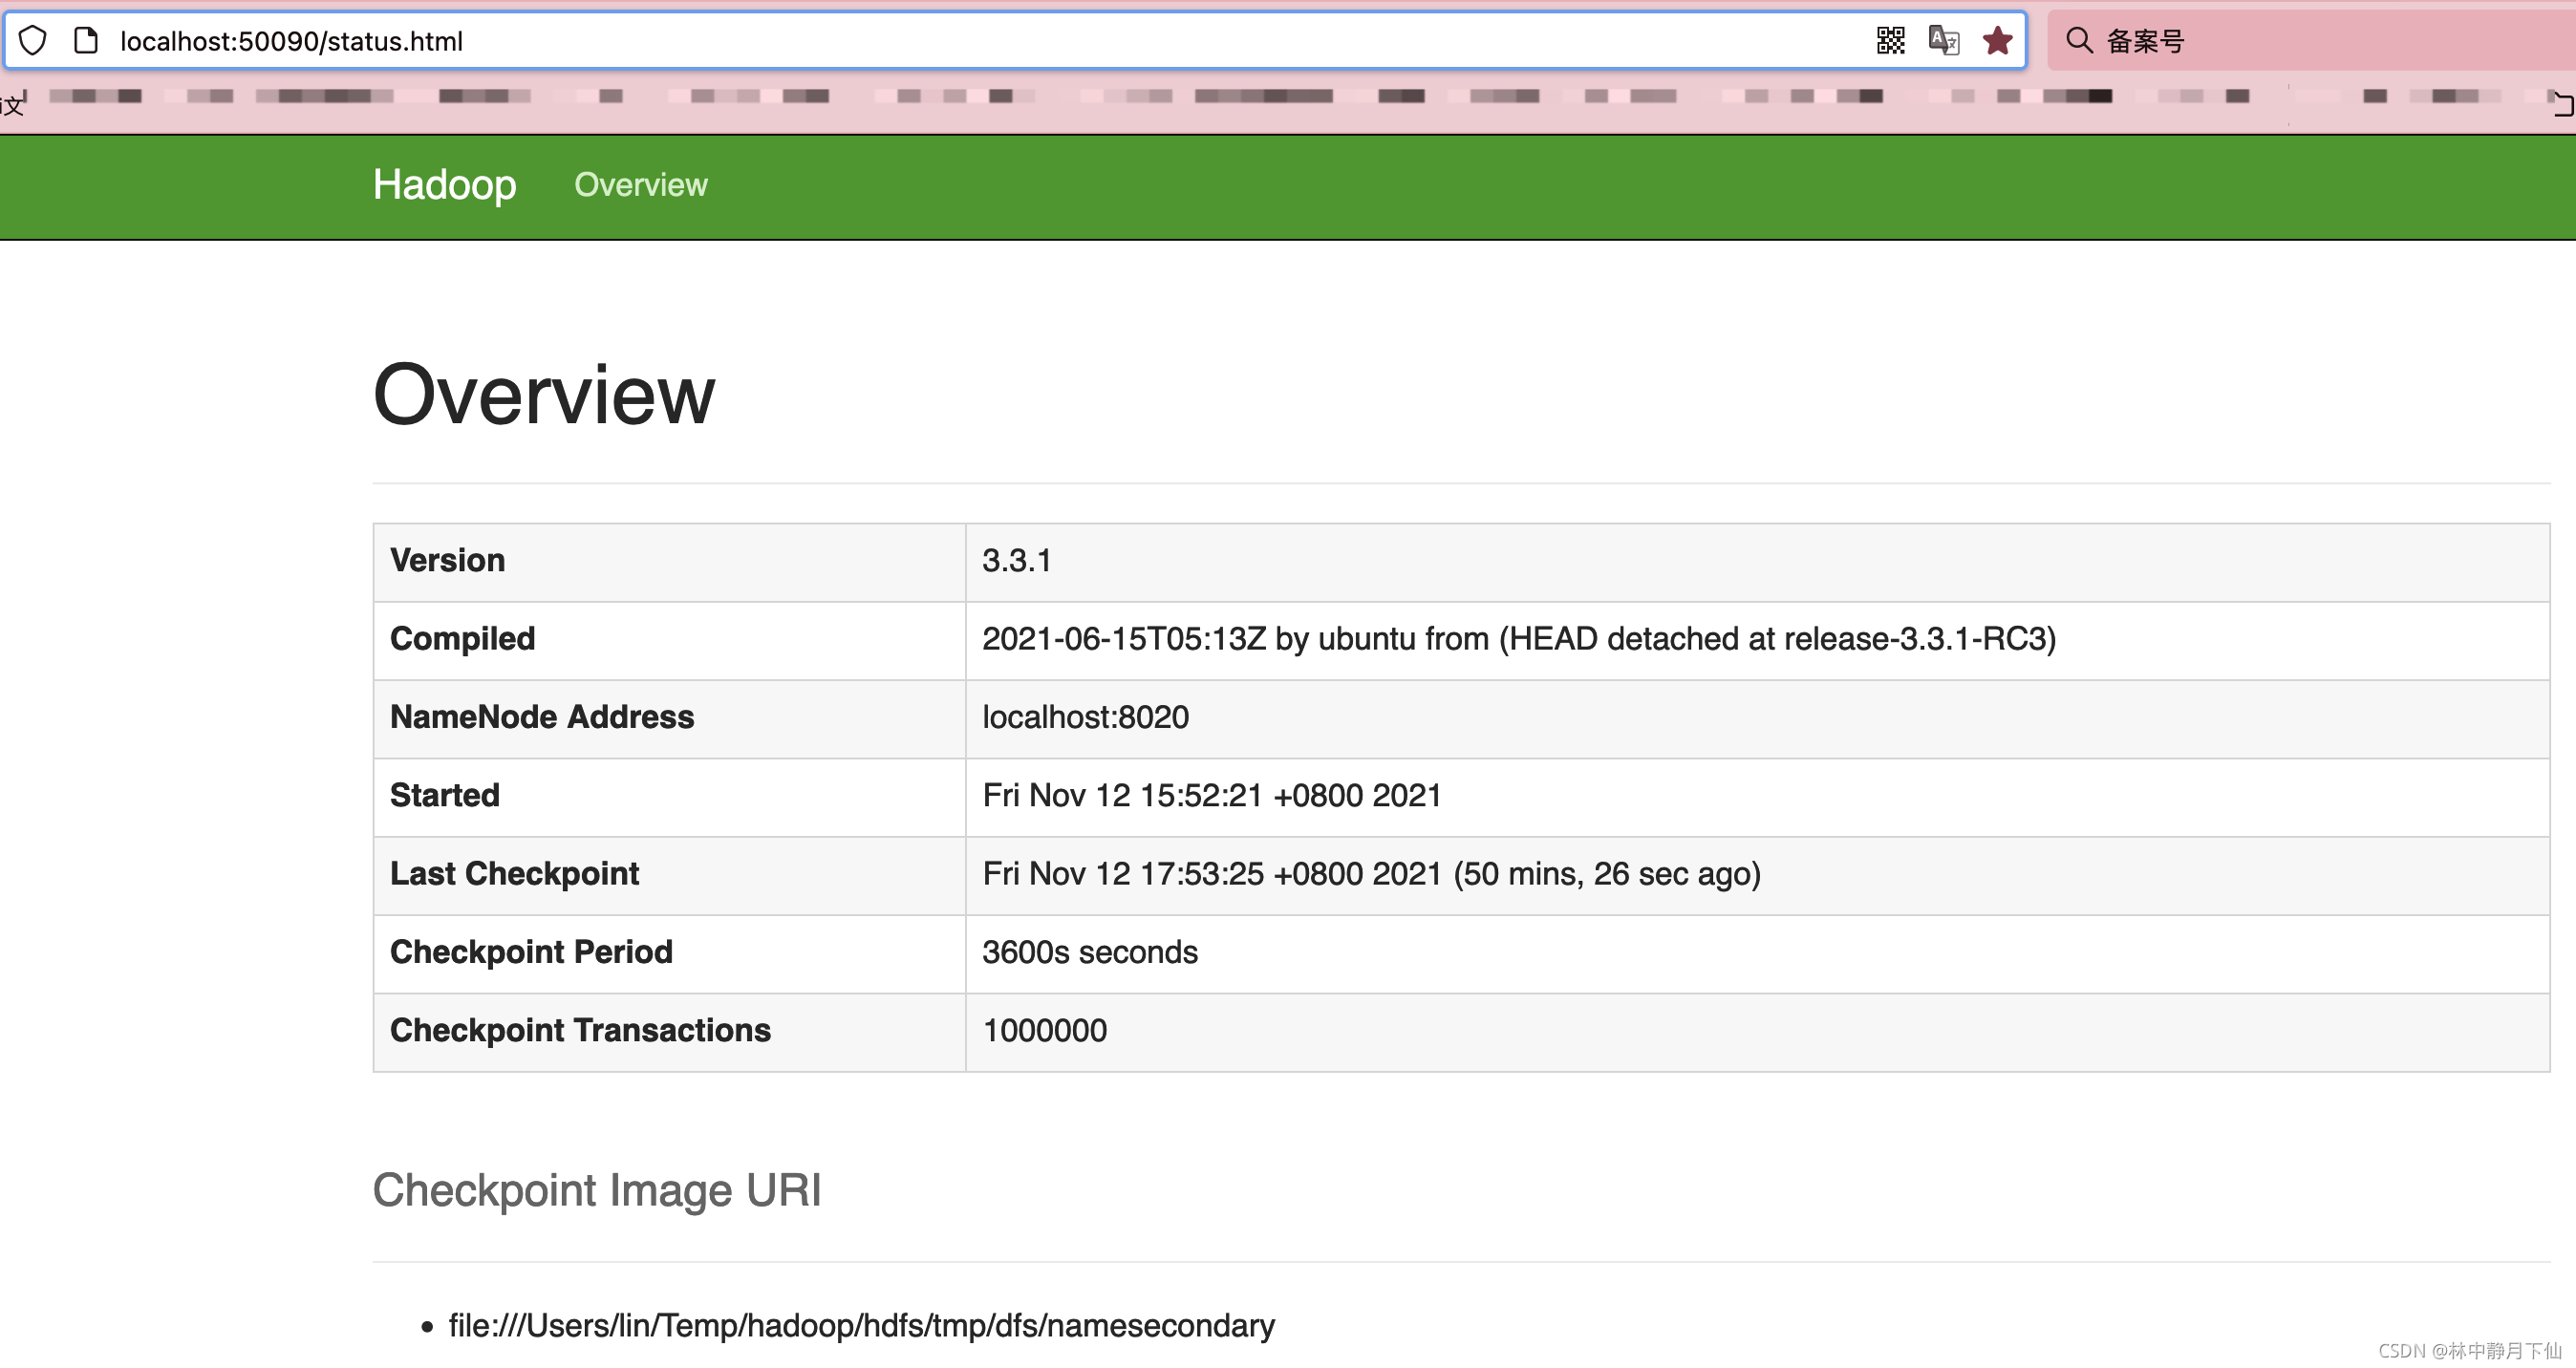
启动成功后,我们在浏览器中输入http://localhost:50090可以看到
启动/关闭YARN服务
./start-yarn.sh
./stop-yarn.sh
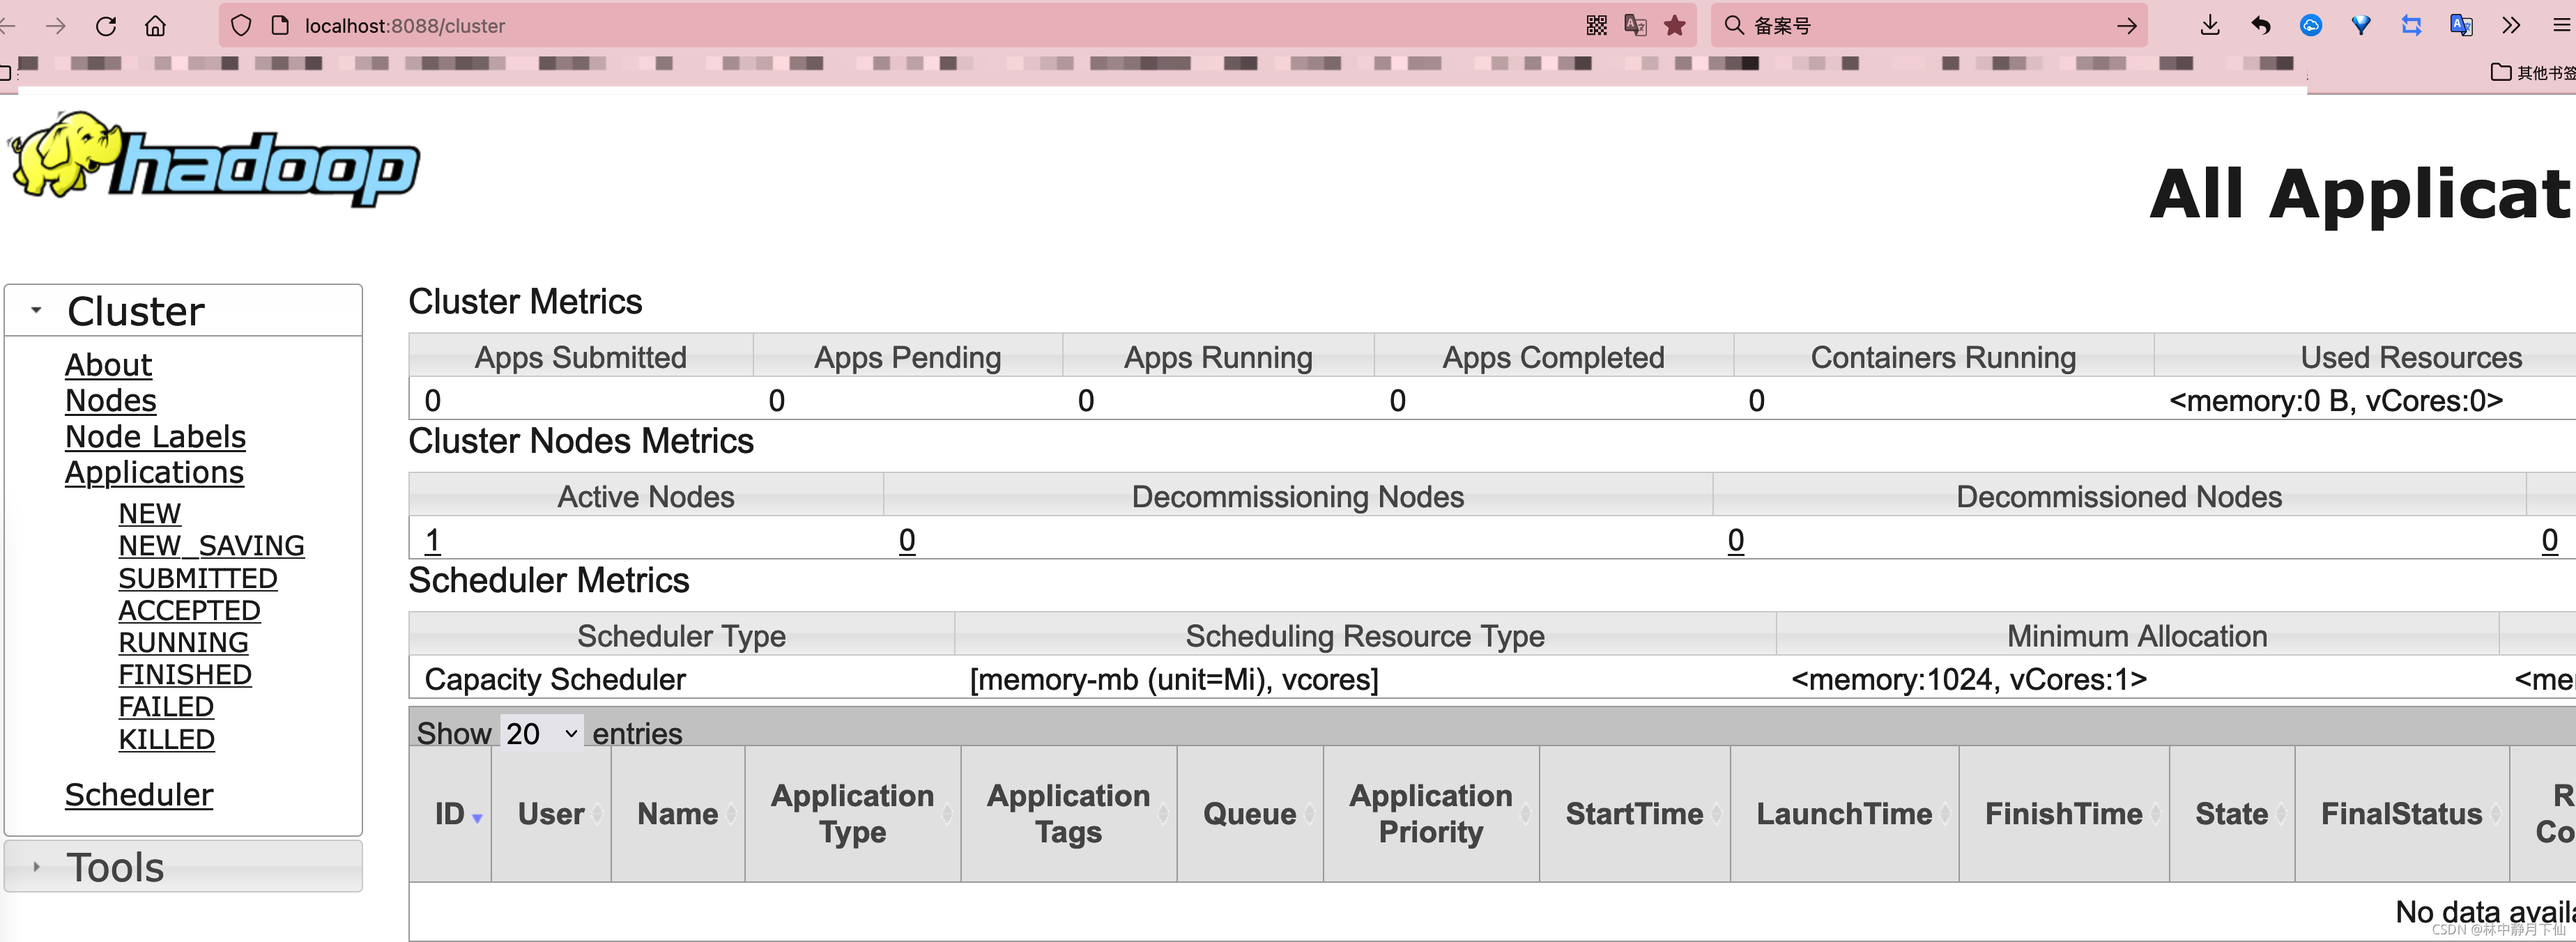
启动成功后,我们在浏览器中输入http://localhost:8088可以看到
启动/关闭Hadoop服务(等效上面两个)
./start-all.sh
 ./stop-all.sh
注意,如果从别人电脑往我的电脑里传文件,出现connection refused提示。则可能需要把电脑的hosts文件中的 localhost 127.0.0.1 改为 localhost 0.0.0.0 。
另外,可以通过
jps
命令看到当前hadoop启动的节点。
可以通过
hdfs dfs -mkdir-p /input
命令来在 HDFS 文件系统中创建目录。注意这个目录是在HDFS的文件系统中的目录,而不是你电脑上的目录。