前言
Lucene 是一个基于 Java 的全文信息检索工具包,目前主流的搜索系统Elasticsearch和solr都是基于lucene的索引和搜索能力进行。想要理解搜索系统的实现原理,就需要深入lucene这一层,看看lucene是如何存储需要检索的数据,以及如何完成高效的数据检索。
在数据库中因为有索引的存在,也可以支持很多高效的查询操作。不过对比lucene,数据库的查询能力还是会弱很多,本文就将探索下lucene支持哪些查询,并会重点选取几类查询分析lucene内部是如何实现的。为了方便大家理解,我们会先简单介绍下lucene里面的一些基本概念,然后展开lucene中的几种数据存储结构,理解了他们的存储原理后就可以方便知道如何基于这些存储结构来实现高效的搜索。本文重点关注是lucene如何做到传统数据库较难做到的查询,对于分词,打分等功能不会展开介绍。
本文具体会分以下几部分:
- 介绍lucene的数据模型,细节可以参阅lucene数据模型一文。
- 介绍lucene中如何存储需要搜索的term。
- 介绍lucene的倒排链的如何存储以及如何实现docid的快速查找。
- 介绍lucene如何实现倒排链合并。
- 介绍lucene如何做范围查询和前缀匹配。
介绍lucene如何优化数值类范围查询。
Lucene数据模型
Lucene中包含了四种基本数据类型,分别是:
Index:索引,由很多的Document组成。
Document:由很多的Field组成,是Index和Search的最小单位。
Field:由很多的Term组成,包括Field Name和Field Value。
Term:由很多的字节组成。一般将Text类型的Field Value分词之后的每个最小单元叫做Term。
在lucene中,读写路径是分离的。写入的时候创建一个IndexWriter,而读的时候会创建一个IndexSearcher,
下面是一个简单的代码示例,如何使用lucene的IndexWriter建索引以及如何使用indexSearch进行搜索查询。
    Analyzer analyzer = new StandardAnalyzer();
    // Store the index in memory:
    Directory directory = new RAMDirectory();
    // To store an index on disk, use this instead:
    //Directory directory = FSDirectory.open("/tmp/testindex");
    IndexWriterConfig config = new IndexWriterConfig(analyzer);
    IndexWriter iwriter = new IndexWriter(directory, config);
    Document doc = new Document();
    String text = "This is the text to be indexed.";
    doc.add(new Field("fieldname", text, TextField.TYPE_STORED));
    iwriter.addDocument(doc);
    iwriter.close();

    // Now search the index:
    DirectoryReader ireader = DirectoryReader.open(directory);
    IndexSearcher isearcher = new IndexSearcher(ireader);
    // Parse a simple query that searches for "text":
    QueryParser parser = new QueryParser("fieldname", analyzer);
    Query query = parser.parse("text");
    ScoreDoc[] hits = isearcher.search(query, 1000).scoreDocs;
    //assertEquals(1, hits.length);
    // Iterate through the results:
    for (int i = 0; i < hits.length; i++) {
         Document hitDoc = isearcher.doc(hits[i].doc);
         System.out.println(hitDoc.get("fieldname"));
    }
    ireader.close();
    directory.close();
从这个示例中可以看出,lucene的读写有各自的操作类。本文重点关注读逻辑,在使用IndexSearcher类的时候,需要一个DirectoryReader和QueryParser,其中DirectoryReader需要对应写入时候的Directory实现。QueryParser主要用来解析你的查询语句,例如你想查 “A and B",lucene内部会有机制解析出是term A和term B的交集查询。在具体执行Search的时候指定一个最大返回的文档数目,因为可能会有过多命中,我们可以限制单词返回的最大文档数,以及做分页返回。
下面会详细介绍一个索引查询会经过几步,每一步lucene分别做了哪些优化实现。
Lucene 查询过程
在lucene中查询是基于segment。每个segment可以看做是一个独立的subindex,在建立索引的过程中,lucene会不断的flush内存中的数据持久化形成新的segment。多个segment也会不断的被merge成一个大的segment,在老的segment还有查询在读取的时候,不会被删除,没有被读取且被merge的segement会被删除。这个过程类似于LSM数据库的merge过程。下面我们主要看在一个segment内部如何实现高效的查询。
为了方便大家理解,我们以人名字,年龄,学号为例,如何实现查某个名字(有重名)的列表。
| docid | name | age | id |
|---|---|---|---|
| 1 | Alice | 18 | 101 |
| 2 | Alice | 20 | 102 |
| 3 | Alice | 21 | 103 |
| 4 | Alan | 21 | 104 |
| 5 | Alan | 18 | 105 |
在lucene中为了查询name=XXX的这样一个条件,会建立基于name的倒排链。以上面的数据为例,倒排链如下:
姓名
Alice | [1,2,3]
---- | --- |
Alan | [4,5]
如果我们还希望按照年龄查询,例如想查年龄=18的列表,我们还可以建立另一个倒排链:
18 | [1,5]
---| --- |
20 | [2]
21 | [3,4]
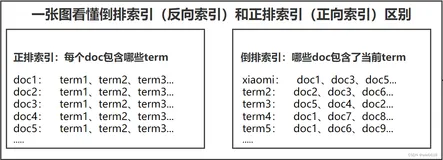
在这里,Alice,Alan,18,这些都是term。所以倒排本质上就是基于term的反向列表,方便进行属性查找。到这里我们有个很自然的问题,如果term非常多,如何快速拿到这个倒排链呢?在lucene里面就引入了term dictonary的概念,也就是term的字典。term字典里我们可以按照term进行排序,那么用一个二分查找就可以定为这个term所在的地址。这样的复杂度是logN,在term很多,内存放不下的时候,效率还是需要进一步提升。可以用一个hashmap,当有一个term进入,hash继续查找倒排链。这里hashmap的方式可以看做是term dictionary的一个index。 从lucene4开始,为了方便实现rangequery或者前缀,后缀等复杂的查询语句,lucene使用FST数据结构来存储term字典,下面就详细介绍下FST的存储结构。
FST
我们就用Alice和Alan这两个单词为例,来看下FST的构造过程。首先对所有的单词做一下排序为“Alice”,“Alan”。
插入“Alan”

- 插入“Alice”

这样你就得到了一个有向无环图,有这样一个数据结构,就可以很快查找某个人名是否存在。FST在单term查询上可能相比hashmap并没有明显优势,甚至会慢一些。但是在范围,前缀搜索以及压缩率上都有明显的优势。
在通过FST定位到倒排链后,有一件事情需要做,就是倒排链的合并。因为查询条件可能不止一个,例如上面我们想找name="alan" and age="18"的列表。lucene是如何实现倒排链的合并呢。这里就需要看一下倒排链存储的数据结构
SkipList
为了能够快速查找docid,lucene采用了SkipList这一数据结构。SkipList有以下几个特征:
- 元素排序的,对应到我们的倒排链,lucene是按照docid进行排序,从小到大。
- 跳跃有一个固定的间隔,这个是需要建立SkipList的时候指定好,例如下图以间隔是3
- SkipList的层次,这个是指整个SkipList有几层

有了这个SkipList以后比如我们要查找docid=12,原来可能需要一个个扫原始链表,1,2,3,5,7,8,10,12。有了SkipList以后先访问第一层看到是然后大于12,进入第0层走到3,8,发现15大于12,然后进入原链表的8继续向下经过10和12。
有了FST和SkipList的介绍以后,我们大体上可以画一个下面的图来说明lucene是如何实现整个倒排结构的:
有了这张图,我们可以理解为什么基于lucene可以快速进行倒排链的查找和docid查找,下面就来看一下有了这些后如何进行倒排链合并返回最后的结果。
倒排合并
假如我们的查询条件是name = “Alice”,那么按照之前的介绍,首先在term字典中定位是否存在这个term,如果存在的话进入这个term的倒排链,并根据参数设定返回分页返回结果即可。这类查询,在数据库中使用二级索引也是可以满足,那lucene的优势在哪呢。假如我们有多个条件,例如我们需要按名字或者年龄单独查询,也需要进行组合 name = "Alice" and age = "18"的查询,那么使用传统二级索引方案,你可能需要建立两张索引表,然后分别查询结果后进行合并,这样如果age = 18的结果过多的话,查询合并会很耗时。那么在lucene这两个倒排链是怎么合并呢。
假如我们有下面三个倒排链需要进行合并。

在lucene中会采用下列顺序进行合并:
- 在termA开始遍历,得到第一个元素docId=1
- Set currentDocId=1
在termB中 search(currentDocId) = 1 (返回大于等于currentDocId的一个doc),
- 因为currentDocId ==1,继续
- 如果currentDocId 和返回的不相等,执行2,然后继续
- 到termC后依然符合,返回结果
- currentDocId = termC的nextItem
- 然后继续步骤3 依次循环。直到某个倒排链到末尾。
整个合并步骤我可以发现,如果某个链很短,会大幅减少比对次数,并且由于SkipList结构的存在,在某个倒排中定位某个docid的速度会比较快不需要一个个遍历。可以很快的返回最终的结果。从倒排的定位,查询,合并整个流程组成了lucene的查询过程,和传统数据库的索引相比,lucene合并过程中的优化减少了读取数据的IO,倒排合并的灵活性也解决了传统索引较难支持多条件查询的问题。
BKDTree
在lucene中如果想做范围查找,根据上面的FST模型可以看出来,需要遍历FST找到包含这个range的一个点然后进入对应的倒排链,然后进行求并集操作。但是如果是数值类型,比如是浮点数,那么潜在的term可能会非常多,这样查询起来效率会很低。所以为了支持高效的数值类或者多维度查询,lucene引入类BKDTree。BKDTree是基于KDTree,对数据进行按照维度划分建立一棵二叉树确保树两边节点数目平衡。在一维的场景下,KDTree就会退化成一个二叉搜索树,在二叉搜索树中如果我们想查找一个区间,logN的复杂度就会访问到叶子结点得到对应的倒排链。如下图所示:
如果是多维,kdtree的建立流程会发生一些变化。
比如我们以二维为例,建立过程如下:
- 确定切分维度,这里维度的选取顺序是数据在这个维度方法最大的维度优先。一个直接的理解就是,数据分散越开的维度,我们优先切分。
- 切分点的选这个维度最中间的点。
- 递归进行步骤1,2,我们可以设置一个阈值,点的数目少于多少后就不再切分,直到所有的点都切分好停止。
下图是一个建立例子:
BKDTree是KDTree的变种,因为可以看出来,KDTree如果有新的节点加入,或者节点修改起来,消耗还是比较大。类似于LSM的merge思路,BKD也是多个KDTREE,然后持续merge最终合并成一个。不过我们可以看到如果你某个term类型使用了BKDTree的索引类型,那么在和普通倒排链merge的时候就没那么高效了所以这里要做一个平衡,一种思路是把另一类term也作为一个维度加入BKDTree索引中。
如何实现返回结果进行排序聚合
通过之前介绍可以看出lucene通过倒排的存储模型实现term的搜索,那对于有时候我们需要拿到另一个属性的值进行聚合,或者希望返回结果按照另一个属性进行排序。在lucene4之前需要把结果全部拿到再读取原文进行排序,这样效率较低,还比较占用内存,为了加速lucene实现了fieldcache,把读过的field放进内存中。这样可以减少重复的IO,但是也会带来新的问题,就是占用较多内存。新版本的lucene中引入了DocValues,DocValues是一个基于docid的列式存储。当我们拿到一系列的docid后,进行排序就可以使用这个列式存储,结合一个堆排序进行。当然额外的列式存储会占用额外的空间,lucene在建索引的时候可以自行选择是否需要DocValue存储和哪些字段需要存储。
Lucene的代码目录结构
介绍了lucene中几个主要的数据结构和查找原理后,我们在来看下lucene的代码结构,后续可以深入代码理解细节。lucene的主要有下面几个目录:
- analysis模块主要负责词法分析及语言处理而形成Term。
- codecs模块主要负责之前提到的一些数据结构的实现,和一些编码压缩算法。包括skiplist,docvalue等。
- document模块主要包括了lucene各类数据类型的定义实现。
- index模块主要负责索引的创建,里面有IndexWriter。
- store模块主要负责索引的读写。
- search模块主要负责对索引的搜索。
- geo模块主要为geo查询相关的类实现
- util模块是bkd,fst等数据结构实现。
最后
本文介绍了lucene中的一些主要数据结构,以及如何利用这些数据结构实现高效的查找。我们希望通过这些介绍可以加深理解倒排索引和传统数据库索引的区别,数据库有时候也可以借助于搜索引擎实现更丰富的查询语意。除此之外,做为一个搜索库,如何进行打分,query语句如何进行parse这些我们没有展开介绍,有兴趣的同学可以深入lucene的源码进一步了解。