Spark入门到精通视频学习资料--第二章:Spark生态系统介绍,Spark整体概述与Spark编程模型(2讲)

简介: 概述什么是Spark◆ Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。

概述

什么是Spark

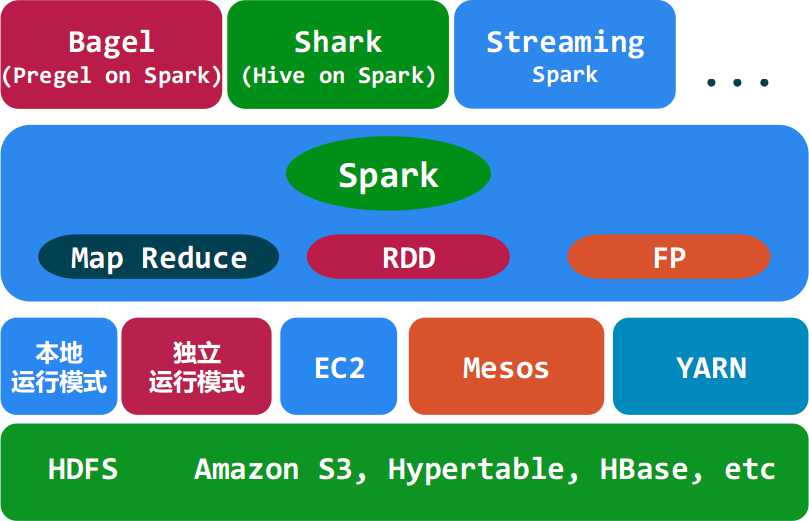
◆ Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。其架构如下图所示:
 

Spark的适用场景

◆ Spark是基于内存的迭代计算框架,适用于需要多次操作特定数据集的应用场合。需要反复操作的次数越多,所需读取的数据量越大,受益越大,数据量小但是计算密集度较大的场合,受益就相对较小

◆ 由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。

◆ 总的来说Spark的适用面比较广泛且比较通用。


详细内容请参考视频:

Spark概述与编程模型(上)      http://pan.baidu.com/s/1kT9okBl

Spark概述与编程模型(下)      http://pan.baidu.com/s/16OEjc


另外给个相关的PDF文件供参考:

Spark概述与编程模型.pdf                http://pan.baidu.com/s/1mg64rMw


==========================================================

申明:视频资料已过期,建议不要再下载了。

==========================================================


目录
相关文章
|
存储 缓存 分布式计算
大数据-83 Spark 集群 RDD编程简介 RDD特点 Spark编程模型介绍
398 4
|
存储 缓存 分布式计算
大数据-89 Spark 集群 RDD 编程-高阶 编写代码、RDD依赖关系、RDD持久化/缓存
407 4
|
分布式计算 Java 大数据
大数据-92 Spark 集群 SparkRDD 原理 Standalone详解 ShuffleV1V2详解 RDD编程优化
373 0
大数据-92 Spark 集群 SparkRDD 原理 Standalone详解 ShuffleV1V2详解 RDD编程优化
|
SQL 分布式计算 大数据
大数据-91 Spark 集群 RDD 编程-高阶 RDD广播变量 RDD累加器 Spark程序优化
372 0
|
缓存 分布式计算 大数据
大数据-90 Spark 集群 RDD 编程-高阶 RDD容错机制、RDD的分区、自定义分区器(Scala编写)、RDD创建方式(一)
435 0
|
分布式计算 算法 大数据
大数据-90 Spark 集群 RDD 编程-高阶 RDD容错机制、RDD的分区、自定义分区器(Scala编写)、RDD创建方式(二)
425 0
|
分布式计算 关系型数据库 MySQL
Spark编程实验四:Spark Streaming编程
|
SQL 分布式计算 大数据
Spark开发实用技巧-从入门到爱不释手
293 0
|
人工智能 分布式计算 大数据
大数据≠大样本:基于Spark的特征降维实战(提升10倍训练效率)
本文探讨了大数据场景下降维的核心问题与解决方案,重点分析了“维度灾难”对模型性能的影响及特征冗余的陷阱。通过数学证明与实际案例,揭示高维空间中样本稀疏性问题,并提出基于Spark的分布式降维技术选型与优化策略。文章详细展示了PCA在亿级用户画像中的应用,包括数据准备、核心实现与效果评估,同时深入探讨了协方差矩阵计算与特征值分解的并行优化方法。此外,还介绍了动态维度调整、非线性特征处理及降维与其他AI技术的协同效应,为生产环境提供了最佳实践指南。最终总结出降维的本质与工程实践原则,展望未来发展方向。
822 0
|
分布式计算 大数据 Apache
ClickHouse与大数据生态集成:Spark & Flink 实战
【10月更文挑战第26天】在当今这个数据爆炸的时代,能够高效地处理和分析海量数据成为了企业和组织提升竞争力的关键。作为一款高性能的列式数据库系统,ClickHouse 在大数据分析领域展现出了卓越的能力。然而,为了充分利用ClickHouse的优势,将其与现有的大数据处理框架(如Apache Spark和Apache Flink)进行集成变得尤为重要。本文将从我个人的角度出发,探讨如何通过这些技术的结合,实现对大规模数据的实时处理和分析。
1363 2
ClickHouse与大数据生态集成:Spark & Flink 实战