本文是“系统学习推荐算法”的第八期,首发于我的博客
冷启动评价指标
作者侧指标
(反映出作者的发布积极性,对低曝光的内容扶持的越好,作者侧指标就越高;作者发布积极性越高,内容池也就越大)发布渗透率=当日发布人数/日活人数
发布一篇活以上,就算一个发布人数
例:- 当日发布人数 =100 万
- 日活人数 =2000 万
- 发布渗透率 = 100/ 2000 = 5%
人均发布量 = 当日发布的内容数 / 日活人数
例:
- 每日发布笔记数 =200 万
- 日活人数 = 2000 万
- 人均发布量 = 200 / 2000 = 0.1
首次曝光和交互时间
首次曝光和交互出现得越早,作者发布积极性就越高
用户侧指标(反映出推荐是否精准,是否会引起用户反感)
新内容指标:新内容的点击率、交互率
如果新内容的推荐比较准,这些指标会比较好看问题:曝光的基尼系数很大,少数头部新内容占据了大部分曝光
这导致新内容的整体消费指标,主要取决于少量头部的新内容,整体的消费指标不能反映出大部分新内容的情况。假如绝大部分新内容都推不准,但是头部新内容推得特别准,那么整体的消费指标也会很好。
解决:
所以最好是把高曝光和低曝光新内容分开,分别考察两者的消费指标,比如可以设置1000次曝光作为阈值。区分高曝光和低曝光,高曝光的内容有充足的用户交互记录,即使不用冷启动技术做特殊处理,推荐也能做得准
我们更应该关注低曝光的新内容,提升低曝光新内容的点击率和交互率。一方面是因为低曝光的新内容占比很高,绝大部分的新内容都是低曝光,而高曝光的新内容的占比是很低的,另一方面,是低曝光的新内容的推荐不容易做好。低曝光内容的用户交互信息很少,推荐不准,需要设计专门的技术处理低曝光新内容。大盘指标:消费时长、日活、月活
冷启动目标不是促进消费指标增长,但要确保冷启的策略也不能显著伤害消费指标新内容推荐有翘翘板效应,如果大力扶持低曝光的新内容,给低曝光的新内容更多的曝光,可以激励作者发布,让作者侧的发布指标变好,但这样会损害用户体验,让大盘消费指标变差。
因为低爆光内容缺少用户交互,推荐做的不准,如果增加低曝光内容的推荐。那么用户的体验会下降,造成消费时长、日活、月活的降低。所以我们做新内容实验的时候,要考察大盘的消费指标,希望大盘的消费指标能够基本持平,确保新内容的策略不会伤害用户的体验
内容侧指标
高热内容占比
(高热内容可以定义为30天内,点击超过1000的内容,这种指标反映出冷启动是否能挖掘出优质内容)
高热内容的占比越高越好,说明冷启动阶段挖掘优质内容的能力强,让优质内容能成长起来
冷启动的优化点
下面以小红书为例讲解
优化推荐全链路(包括召回和排序)
每一个环节都针对新内容做优化,让新内容有足够多的机会走完链路被曝光。 还要尽量让新内容的推荐做得准,不要引起用户的反感。
流量调控
也就是流量怎么在新内容和老内容之间分配。
工业界标准的做法是让流量向新内容倾斜,帮助新内容获得更多的曝光机会。
优化召回和排序
在小红书中召回笔记需要哪些信息呢,内容都有图片文字之类的内容,有的内容还标注了地点,新内容还有算法或者人工打的标签,比如内容的类目、内容和标签都是做召回的依据
- 没有和用户之间的交互信息
但是新内容缺少一些非常重要的信息,给推荐系统造成了很大的困难,用户对内容的点击点赞等统计数据。可以反映出内容本身的质量,以及什么样的用户喜欢这篇内容,这对精准推荐的帮助很大,可惜新内容没有这些信息,
而且 itemcf usercf 之类的召回通道。需要知道内容 跟哪些用户有过交互,如果一篇内容还没有跟用户交互,就走不了 ItemCF 这种召回通道【ItemCF 不适用于冷启动】
- 没有对应的有效 ID Embedding
冷启动缺少的另一个关键信息,是内容的ID embedding。召回和排序模型都有 embedding 层,把每个内容ID 映射到一个向量,这个向量是从用户跟内容交互的行为中学习出来的。冷启的时候,这个向量是刚刚初始化的,还没有用反向传播更新,也就是说新内容的 ID embedding 啥都不是。反映不出内容的特点
而内容的 ID embedding 是召回和排序中最重要的特征之一,缺少这个特征会让召回和排序变得很不准。(也就是会导致双塔模型的效果不好(还没有学好内容的 ID embedding),双塔模型是推荐系统中最重要的召回通道,没有之一)
适用于冷启动的召回通道
改造后的双塔模型
双塔模型不能直接适用于冷启动场景,所以想要用双塔模型的话需要做特殊的处理
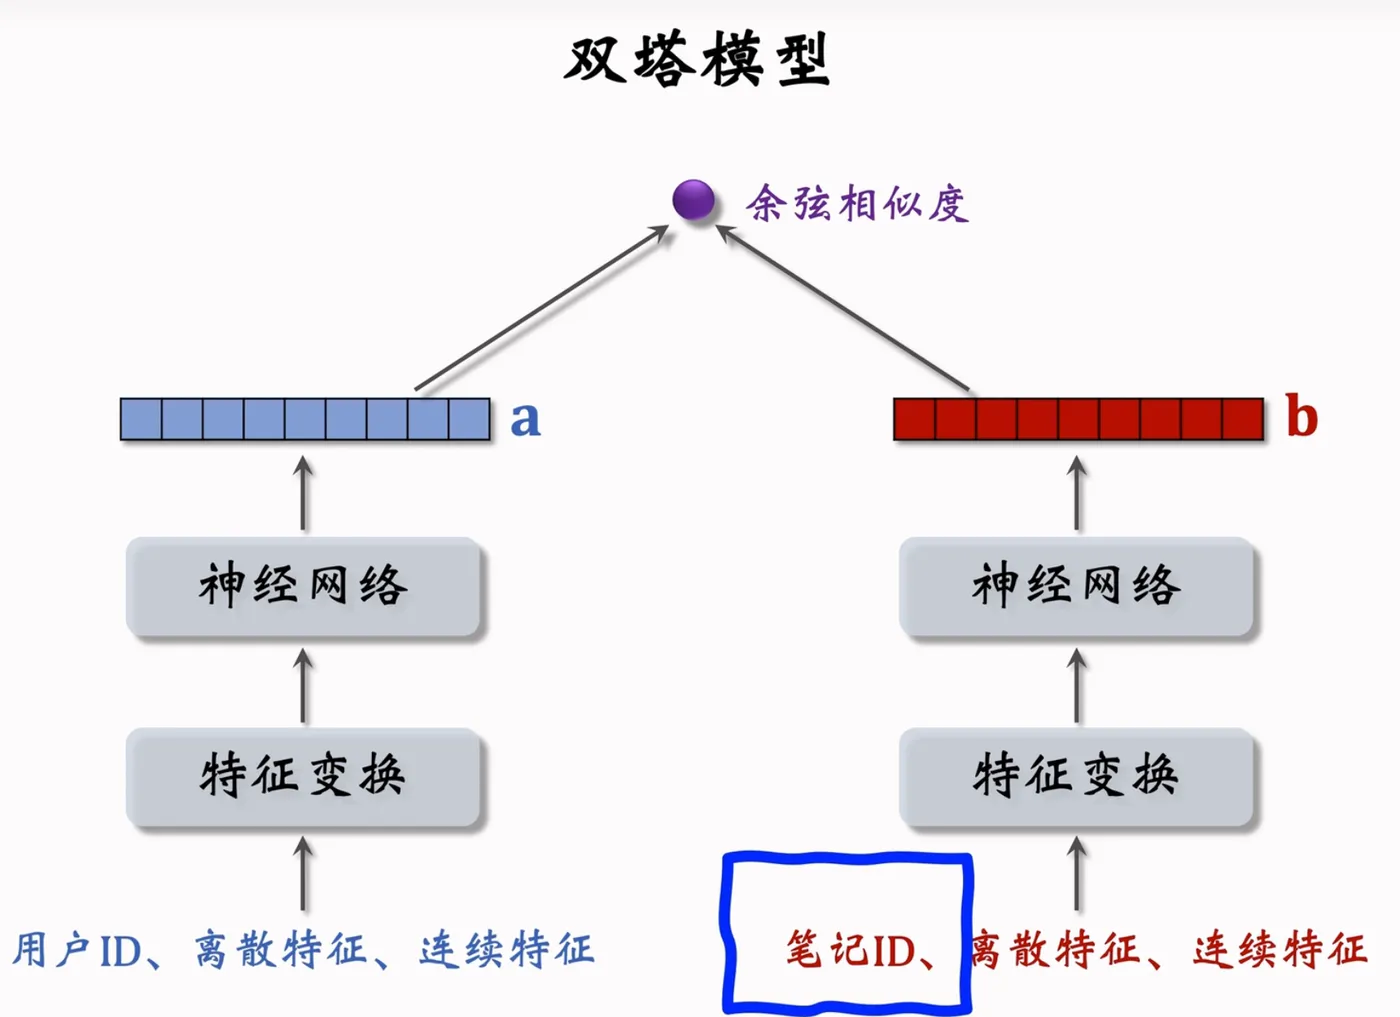
常见的双塔模型,左边是用户塔,输入是用户特征,右边是物品塔,输入是内容ID和其他内容特征。两个塔各自输出一个向量,两个向量的向量相似度表示用户对物品的兴趣。物品ID也就是内容ID,是物品塔中最重要的特征,神经网络有一个 embedding 层。把内容 ID 映射成向量,每个内容都有一个ID embedding 向量,需要从用户和内容的交互中学习。可是新内容还没有跟几个用户交互过,所以它的 embedding 向量还没有学好,如果直接用双塔模型做新内容的召回,效果会不太好
两种改进ID embedding的方案
让新内容使用 default embedding。
物品塔做 ID embedding的时候,让所有新内容共享一个ID,而不是用新内容自己真正的ID,所有新内容的 ID embedding 都是相同的default embedding。
这个 default embedding 是学出来的,而不是随机初始化或者全零初始化,学出来的default embatting 比随机初始化和全零初始化更好。
新内容发布之后,逐渐会有点击和交互,这些信号可以用来学习内容的 ID embatting 。到了下次模型训练的时候,新内容的ID embatting 向量才被学到。利用相似物品的 embedding 向量
当新内容发布之后。查找 TopK 内容最相似的高曝光内容。比如在小红书的应用中,相似可以用图片、文字、类目来定义。用多模态神经网络,把一篇内容的图文内容表征为一个向量,每当一篇新内容发布的时候。寻找最相似的K个向量,把找到的 K 篇高曝光内容的 embedding 向量取平均,作为新内容的 embedding,之所以用高曝光内容,是因为他们的 ID embedding 通常学的比较好。
在实践中,通常会用多个向量召回池,比如1小时新内容,6小时新内容,24小时新内容。还有30天老内容。用多个召回池,可以让新内容有更多的机会曝光,假如只有一个30天内容的召回池。那么新内容被召回的几率很小,很难得到曝光(所有这些召回池用的是同一个双塔模型,所以不会增加训练模型的代价)
类目、关键词召回
类目、关键词是两种弱个性化的召回通道。在内容刚刚发布的时候这两种召回通道是最有用的,但是在内容发布一段时间之后这两种召回通道会失效
凡是做信息流,社交,电商的互联网公司,都会维护每一位用户的画像,画像中记录了用户的兴趣点(包括用户自己填写的和算法自动推断出来的)
比如一个人经常刷小红书,算法能够推断出感兴趣的类目包括美食、科技数码、电影。感兴趣的关键词,包括纽约、职场、搞笑、程序员、大学,这些类目和关键词就可以用于召回。
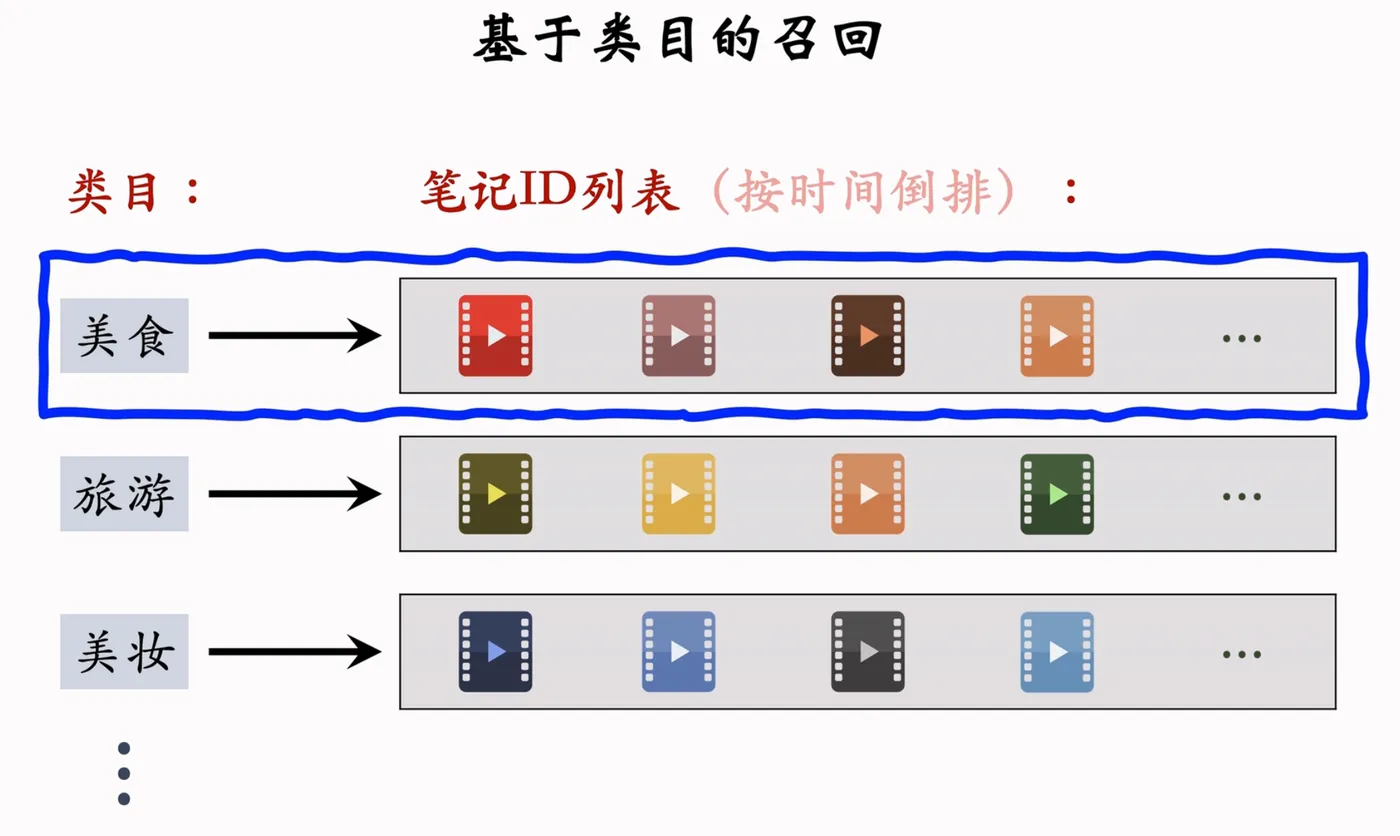
系统维护一份从类目/关键词到内容的索引
类目召回索引上的 key 是类目,比如美食旅游美装这样比较大的类目,也可以是更细腻度的类目 比如日本料理、国内旅游、护肤的类目。(关键词召回 索引上的 key 是关键词)
每个类目后面是一个内容的列表,按照发布时间倒排,最新发布的内容排在最前面。
一个用户刷新小红书的时候,系统根据这位用户的画像,知道他对哪些类目/关键词感兴趣,取回这些类目/关键词,比如他对美食和旅游感兴趣。然后到类目索引上,找到美食和旅游对应的两个内容列表,取回内容列表上美食的前 K 篇内容,旅游的前 K 篇内容,这样就得到 2K 篇内容,作为这一路召回的结果
缺点
- 只对刚刚发布的新笔记有效
类目索引和关键词索引都是按照笔记发布的时间倒排,刚刚发布的新笔记排在最前面。
做召回的时候,每次取回某类目或者某关键词下面最新的 K 篇笔记。如果笔记已经发布了几小时,那么大概率会被排在几百甚至几千的位置上,也就是说这篇笔记再也没有机会被召回了。类目召回和关键词召回留给每篇笔记的窗口期很短 - 弱个性化,不够精准
按照用户感兴趣的类目关键词作召回其实是比较宽泛的。假如我喜欢观赏鱼,而它处于宠物的类目,但是最新发布的100篇宠物笔记可能都是猫猫狗狗。大概率没有我感兴趣的观赏鱼,于是召回的100篇都是我不感兴趣的
虽然类目召回和关键词召回的缺点很明显。但仍然对冷启动很重要,它们能让刚刚发布的新笔记立刻获得曝光,有助于提升作者的发布积极性。
聚类召回
聚类召回基于笔记内容的图文内容做推荐,聚类召回的基本思想是 给用户返回相似(同一簇)里面的物品
如果用户喜欢一篇笔记,那么它会喜欢内容相似的笔记。假如用户收藏了一篇在上海买房的笔记,系统给他推更多上海买房的笔记,他就有可能会点开
聚类召回里如何判断两篇笔记的内容相似度?
可以用神经网络来实现,事先训练一个神经网络,基于笔记的类目和图文内容,把笔记映射到向量,对笔记向量做聚类。划分为很多 cluster,记录每个 cluster 的中心方向。
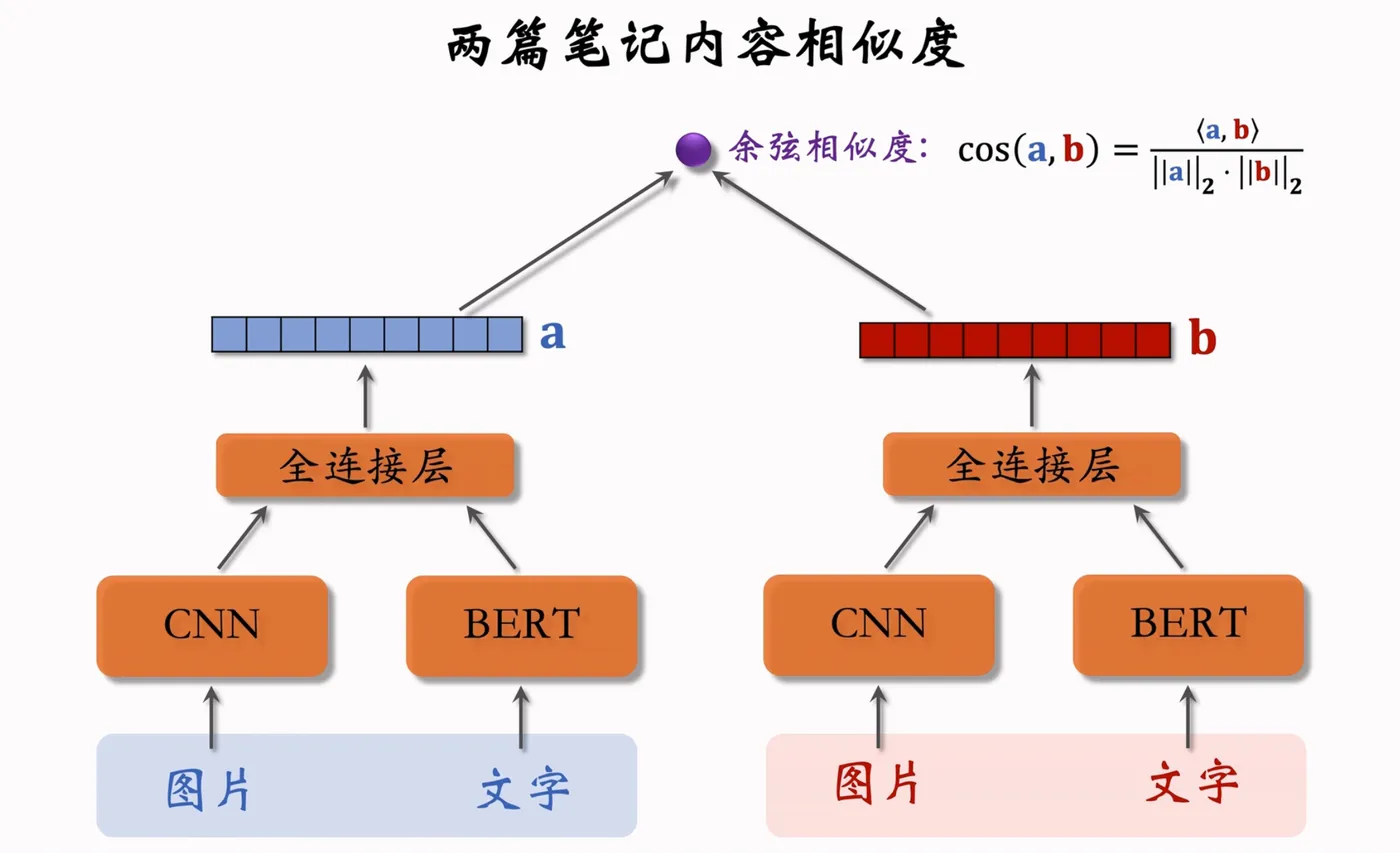
对笔记向量做聚类,所以叫做聚类召回,可以用 k-means 聚类等方法,聚类的时候需要指定一个相似度作为“相似”的定义,比如余弦相似度
聚拉召回的流程
建立索引:
当一篇新笔记发布之后,用神经网络把它的图文内容映射到一个特征向量
从 1000 个 cluster 中心向量中找到最相似的向量,绑定为新笔记的cluster
把新笔记的id添加到索引上
索引是从 cluster => 笔记id列表;笔记列表是按照发布时间倒排的。
线上召回
- 系统使用用户的 ID 找到他的 last-n 感兴趣笔记记录,包括点赞收藏转发的笔记列表。把这些笔记作为种子笔记
- 用神经网络把用户的每篇种子笔记,映出为特征向量,然后与 1000 个中心向量做比较,寻找最相似的 cluster。判断出用户对哪些 cluster 感兴趣,然后从每个cluster 笔记的列表中取回最新发布的 m 篇笔记,最终取回 m×n 篇新笔记,
聚类召回跟类目召回有相同的缺点,都只对刚刚发布的新笔记有效,一篇笔记发布一两个小时之后就不太可能被召回了
聚类召回和 ItemCF 的区别
聚类召回和 ItemCF 都是 ItoI 召回逻辑的实现,可以把它们理解为两种不同的“找相似物品”的方法:
- ItemCF:看用户过去喜欢过哪些物品,再找“和这些物品相似”的物品。
- 聚类召回:先把物品分成若干簇,用户对某些簇感兴趣时,从这些簇里召回物品。
| 对比 | ItemCF | 聚类召回 |
|---|---|---|
| 核心依据 | 物品之间的共现关系 | 物品的特征或向量距离 |
| 怎么找到相似物品 | 统计用户行为:看过 A 的人是否也看过 B | 把相似物品划到同一簇 |
| 用户侧怎么召回 | 根据用户历史物品,找邻近物品 | 根据用户兴趣定位到相关簇,再取簇内物品 |
| 结果特点 | 更个性化,能贴近具体行为 | 覆盖面较广,适合快速粗筛 |
| 主要局限 | 长尾物品数据少时效果差;新物品难处理 | 簇内物品未必都适合该用户,粒度受聚类质量影响 |
举个例子:
用户最近看了《三体》。
- ItemCF 会根据行为数据发现:看过《三体》的人也常看《流浪地球》,于是召回《流浪地球》。
- 聚类召回可能把科幻小说和科幻电影聚成“科幻”簇;用户看了《三体》后,系统从这个簇里取一批物品,比如其他科幻小说或电影。
所以,ItemCF 找的是和用户历史物品有行为关联的物品;聚类召回找的是与用户兴趣所在类别接近的物品。
实际推荐系统通常会把多个召回通道并行使用,再合并去重,交给排序模型筛选。聚类召回也不一定只按人工类别聚类,常见做法是先把物品表示成向量,再用聚类算法分组。
Look-Alike 召回
Look-Alike 是互联网广告中常用的一类方法。这种方法也可以用在推荐系统,特别是召回低曝光笔记,Look-Alike 在我们小红书推荐系统的落地应用取得了不错的效果。
Look-Alike 本身起源于互联网广告。假设有个广告主想精准的给100 万个目标受众投放广告。
假设广告主是特斯拉,他们自己知道 Model3 的典型用户是这样的
- 年龄在25到35都是年轻人。
- 本科学历以上
- 关注科技数码
- 喜欢苹果电子产品
把符合全部条件的用户都圈出来,满足所有条件的受众被称作种子用户,重点在这个人群中投放广告
不过这样的用户数量不会很多,可能只有几万人,但是潜在的符合条件的用户可能会很多,因为缺少他们的部分信息没有办法找到他们,比方说多数的用户不标自己的学历和年龄。广告主想给100万用户投放广告,但才找出几万人,那么该如何发现 100 万潜在的目标用户呢?。
**这就要用到LOOK LIKE人群扩散,寻找跟种子用户相似的用户,把找到的用户称作Look-Alike用户。**通过这种方式,可以利用几万个种子用户,找出几十万个 Look-Alike 用户
Look Alike只是个框架,具体该怎么样扩散。有各种各样的算法,最重要的问题在于 如何定义两个用户之间的相似度
- UserCF:以两个用户共同性区点,衡量两个用户的相似度。要是两个用户同时对很多相同的物品感兴趣,说明两个用户的相似度比较大。
- 向量化:用两个用户的 ID embedding 向量,如果两个用户相似,那么两个夹角的余弦值就会比较大。
在冷启动的场景下,Look Alike 的核心思想:如果用户有点击点赞收藏转发的行为,说明用户对笔记可能感兴趣。把由点击点赞收藏转发行为的用户作为新笔记的种子用户,如果一个用户跟种子用户相似,那么他也可能对这篇新笔记感兴趣,可以把新笔记推荐给他——根据种子用户找出更多兴趣相似的用户,把新笔记从种子用户扩散到更多 lookalike 用户
Look Alike 用于冷启动的流程
用户在小红书上发布一篇新笔记。系统会把新笔记推荐给很多用户,少数用户会对笔记感兴趣,会点击点赞收藏转发看,这些用户是种子用户
系统对新笔记的推荐通常不太准,有交互行为的用户数量很少。一旦有交互行为,我们要充分利用这种信号,让推荐变得更准
取回每个种子用户的 embedding 向量(复用双塔模型取到的用户向量)
然后取这些用户向量的均值得到一个向量,把得到的这个向量作为新笔记的表征,这个向量反映出什么样的用户对该笔记感兴趣这个特征向量需要做近线更新,近线的意思是不用实时更新,能做到分钟级的更新就可以了
线上召回:把新笔记的特征向量都放在向量数据库里,用户刷新时,用双塔模型计算这个用户的特征向量、作为query,在向量数据库中做最近邻查找,就能让与这批种子用户相似的用户刷到这篇新笔记
流量调控
流量调控,也就是流量怎么样在新笔记和老笔记之间分配。工业界常见的做法是让流量向新笔记倾斜,帮助新笔记获得更多的曝光机会。
流量调控的目标:
- 精准推荐:把新内容推荐给合适的用户,不引起用户反感
- 激励发布:流量向低曝光新内容倾斜,激励作者发布
- 挖掘高潜:通过初期小流量试探(初期每篇内容都给曝光,雨露均沾),找到高质量的内容,给予流量倾斜
假如采用完全的自然分发,让新老笔记公平竞争,那么年龄小于24小时的新笔记的曝光机会非常少。只有30分之一
但企业一般会给新笔记大力度的扶持,让新笔记有足够多的机会曝光
强插
强插:在推荐结果中强插新笔记,让新笔记获得额外的曝光机会
提权
提权:对新笔记的排序分数做提权(Boost)
推荐系统中,如果不用规则去干涉,而是让新笔记和老笔记自由竞争,那么新笔记的曝光机会是很有限的。
假设推荐系统主要分发年龄小于30天的笔记。如果纯粹用自然分发,那么曝光的笔记中,年龄小于24小时的新笔记应该占30分之一
所以需要干涉粗排和重排环节,因为这两个环节是漏斗,会过滤掉大量笔记,干涉的方法就是对新笔记提权,让新笔记比老笔记更有优势,有更多的机会通过漏斗
优点:
容易实现,节省人力
缺点:
需要人为设置一些提权系数,把他们乘到排序模型打的分数上,曝光量对提权系数很敏感,系数大一点,可能会把很多低质量的新笔记排在前面,系数小一点,给新笔记的曝光可能不足,很多新笔记得不到充足的曝光。
保量
通过提权,对新笔记做保量 (比如要求尽量保证每篇新笔记都能在前24小时,获得至少100次曝光。)
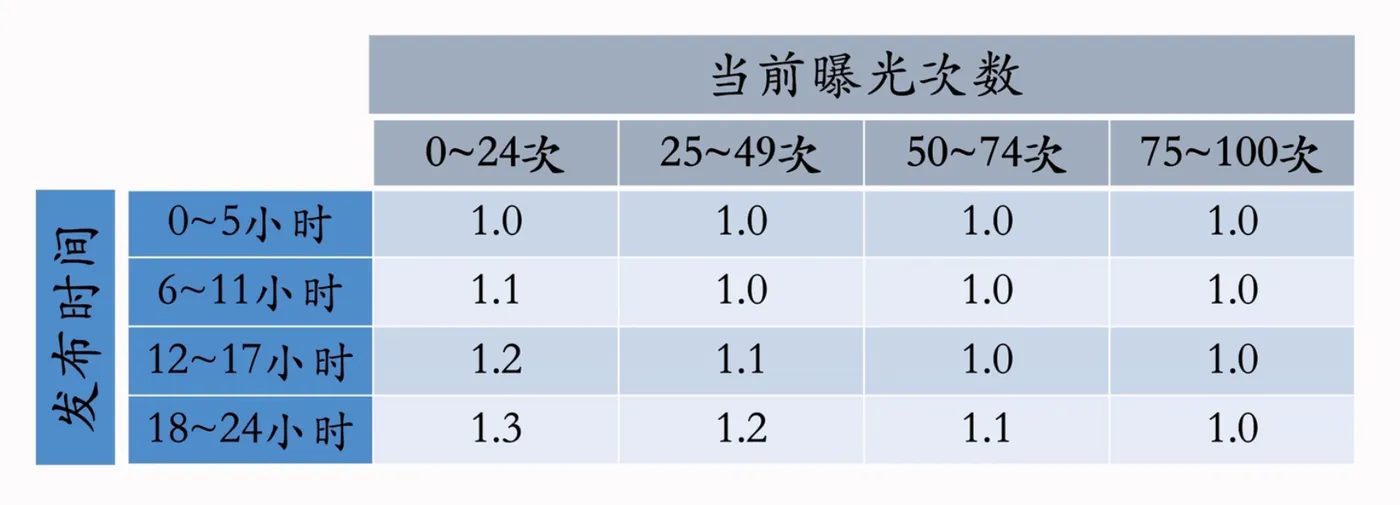
最原始的保量方法,是差异化对待不同的发布时间不同曝光次数的笔记,在原有提权系数的基础上,再乘以额外的提权系数,帮助笔记在24小时获得100次曝光
比如,12小时应该获得54曝光。如果12小时达到54曝光了,那么提选系数就是1,不给额外的扶持。假如12小时只获得24曝光,那么就应该加大扶持力度,比如乘以提选系数1.2
实际生产中提权系数不是写死的,而是精细化调出来的
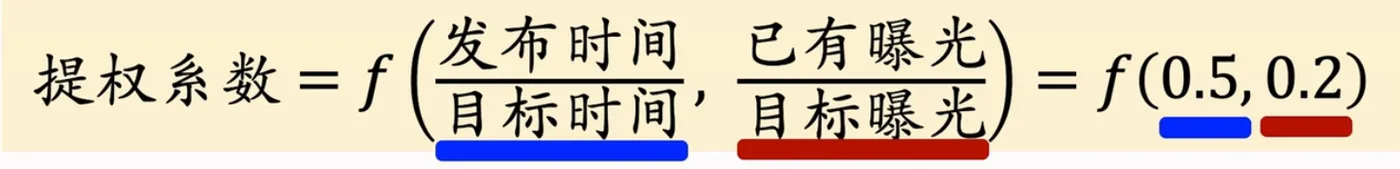
提权系数的计算:
用下面四个值计算提权系数
- 目标时间:比如 24 小时
- 目标曝光:比如 100 次
- 发布时间:比如笔记已经发布了12小时
- 已有曝光:比如笔记已经获得 20 次曝光
第一个比例值越大、第二个比例值越小,提权系数就应该越大
可能造成保量失败的原因
- 召回做的不好,有些类型的新笔记很难被召回
- 排序模型有问题,对新笔记的预估做的不准
- 新笔记的提权系数没有调好,导致曝光不足
- 线上环境变化:新增召回通道、升级排序模型、改变重排打散规则
- 线上环境变化后,往往需要调整提权系数
能不能给所有新笔记一个很大的提权系数呢?
比如给新笔记四倍的权重,直到达成 100次曝光为止,就把它跟老笔记同等对待。显然用很大的提权系数,保量的成功率会很高
既然这样的保量成功率很高,那为什么不用这种简单的方法,而是要用更精细更复杂的提权方法呢。因为这种方法效果不好,假如把一瓶笔记的分数乘以 2,笔记的排序位置就会更高,获得更多的曝光,也就是说在笔记冷启动阶段,分数提升越多,对新笔记的初期曝光次数越有利,但是过了冷启动阶段之后,之前大力度的扶持可能会起到反作用。
如果不要去人为提升预估分数,那么只有当预见匹配的受众的时候,预估分数才会高。笔记才能通过排序的筛选,最终曝光给用户
假如人为大幅提升笔记的分数,那么笔记就很容易通过排序的筛选,哪怕笔记不是用户特别感兴趣的话题。把笔记推荐给不太合适的受众,那么就不会产生点击、点赞,对这篇笔记的点击率、点赞率等指标造成负面影响。
所以给笔记分数提升的越狠,会让笔记展示给不合适的受众,对点击率、点赞率越不利。如果点击率、点赞率之类的数值比较低,那么笔记会长期受推荐系统的打压,曝光会很少,本来有潜力热门的物品最终没有成长起来。
差异化保量
差异化保量:在笔记刚刚发布的时候,根据内容质量,决定保量的目标是多少次曝光。
差异化保量对不同笔记有所区别,不同的笔记有不同的保量目标,比如普通笔记保 100 次曝光,优质内容的笔记保 100-500 次曝光,具体的保量目标由算法判定
保量目标判定的算法
- 每篇笔记都有一个基础保量。比如24小时保100次曝光
- 然后比较内容质量和作者质量。对于内容质量可以用多模态神经网络,判定图文视频的质量高低,根据模型的预测,给新笔记额外的保量,比方说最多给200次额外的保量
- 另一个依据是作者质量。如果一个作者以前发布的笔记质量普遍比较高,那么他发的新笔记也大概率质量比较高,应该给予额外的保量目标,比如最多增加200次额外的保量
总结
冷启动要解决的,不只是“给新笔记一些曝光”,而是让缺少交互数据的新内容找到合适的受众,并在获得反馈后逐步进入正常分发。因此,评价效果不能只看新内容整体的点击率:作者侧要看发布积极性和首次获得曝光、交互的时间;用户侧尤其要关注低曝光新内容的点击率、交互率,同时观察大盘消费指标有没有明显下降;内容侧则要看优质新内容能否被挖掘出来。
在推荐链路上,新笔记既缺少点击、点赞等交互信息,也没有学好的 ID Embedding,很难直接依靠已有的协同过滤和排序结果获得机会。可以利用内容、类目、关键词等已有信息改造召回,让新笔记先进入候选集;进入候选集之后,还要关注它能否通过排序,最终展示给用户。只优化召回或只在排序阶段扶持,都可能让新内容卡在链路的另一道关口。
流量调控提供了进一步的曝光机会:强插、提权、保量都能扶持新笔记,差异化保量则根据内容质量和作者质量调整目标。但扶持力度并非越大越好。**如果为了完成曝光目标,把新笔记大量推给不合适的用户,点击率和交互率反而可能变差,影响后续分发。**冷启动的关键,是给新内容足够的机会获得反馈,同时尽量把机会给到可能感兴趣的用户,再根据反馈决定后续流量如何分配。