在开发奇门遁甲或传统历法类应用时,节气数据的准确性是排盘的核心基础。传统的开发方式往往依赖人工录入或硬编码,不仅效率低下,且极易在跨年份、跨时区的计算中出现偏差。本文将深入探讨如何构建一个高效的节气后台,重点解析24节气历数据的批量导入逻辑、数据库设计以及排盘算法的核心实现,帮助开发者打造稳定、精准的历法数据底座。
一、 节气数据的特性与数据库设计
24节气本质上是太阳在黄道上位置的反映,每个节气对应太阳黄经每移动15度的时刻。在后台开发中,我们不能仅仅存储“某月某日”,因为节气交接的具体时刻精确到分钟,且每年都有微小变动。
核心设计思路:
- 时间戳优先:必须存储节气交接的精确时间戳(UTC或本地时间),而非简单的日期字符串,以便前端进行精确的交节判断。
- 年份维度索引:以年份为主键建立索引,便于批量查询某年的所有节气。
- 扩展字段:预留干支、五行、旺衰等衍生字段,方便后续奇门排盘直接调用,减少实时计算开销。
以下是节气数据表的建表逻辑与批量导入的核心代码实现:
-- 节气数据表设计
CREATE TABLE `solar_terms` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `year` int(11) NOT NULL COMMENT '年份',
  `term_name` varchar(20) NOT NULL COMMENT '节气名称(如:立春)',
  `term_index` tinyint(4) NOT NULL COMMENT '节气序号(1-24)',
  `term_time` datetime NOT NULL COMMENT '节气交接精确时间',
  `longitude` decimal(10,4) DEFAULT NULL COMMENT '太阳黄经度数',
  `gan_zhi` varchar(10) DEFAULT NULL COMMENT '对应干支',
  `created_at` timestamp DEFAULT CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`),
  KEY `idx_year` (`year`),
  KEY `idx_term_time` (`term_time`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='24节气历数据表';
二、 节气历批量导入与算法实现
批量导入节气数据通常有两种方案:一是调用第三方天文API,二是基于天文算法本地计算。为了保证系统的独立性和高可用性,推荐采用本地算法计算并批量入库。
关键技术点:
- 精度控制:使用高精度天文算法(如VSOP87)或成熟的历法库计算节气时刻,误差需控制在分钟级。
- 批量插入优化:一次性生成几十年的数据(如1900-2100年),使用事务和批量插入(Batch Insert)提升写入性能。
- 幂等性处理:导入脚本需支持重复执行,采用“先删除后插入”或“存在则更新”的策略,避免数据重复。
以下是基于Node.js生成并批量导入节气数据的核心代码:
const solarTerm = require('solar-term'); // 假设使用成熟的节气计算库
const mysql = require('mysql2/promise');

// 批量生成并导入指定年份范围的节气数据
const batchImportSolarTerms = async (startYear, endYear) => {
  const connection = await mysql.createConnection({
    host: 'localhost', user: 'root', database: 'qimen_db'
  });

  try {
    await connection.beginTransaction();
    const insertSql = 'INSERT INTO solar_terms (year, term_name, term_index, term_time, longitude) VALUES ?';
    let values = [];

    for (let year = startYear; year <= endYear; year++) {
      // 获取该年所有节气数据
      const terms = solarTerm.getYearTerms(year);
      terms.forEach((term, index) => {
        values.push([
          year,
          term.name,
          index + 1,
          term.time, // 精确到秒的日期对象
          term.longitude
        ]);
      });
    }

    // 批量插入,每批次1000条防止SQL过长
    const chunkSize = 1000;
    for (let i = 0; i < values.length; i += chunkSize) {
      const chunk = values.slice(i, i + chunkSize);
      await connection.query(insertSql, [chunk]);
    }

    await connection.commit();
    console.log(`成功导入 ${startYear}-${endYear} 年节气数据`);
  } catch (error) {
    await connection.rollback();
    console.error('导入失败,事务回滚:', error);
  } finally {
    await connection.end();
  }
};
三、 奇门排盘中的节气调用与性能优化
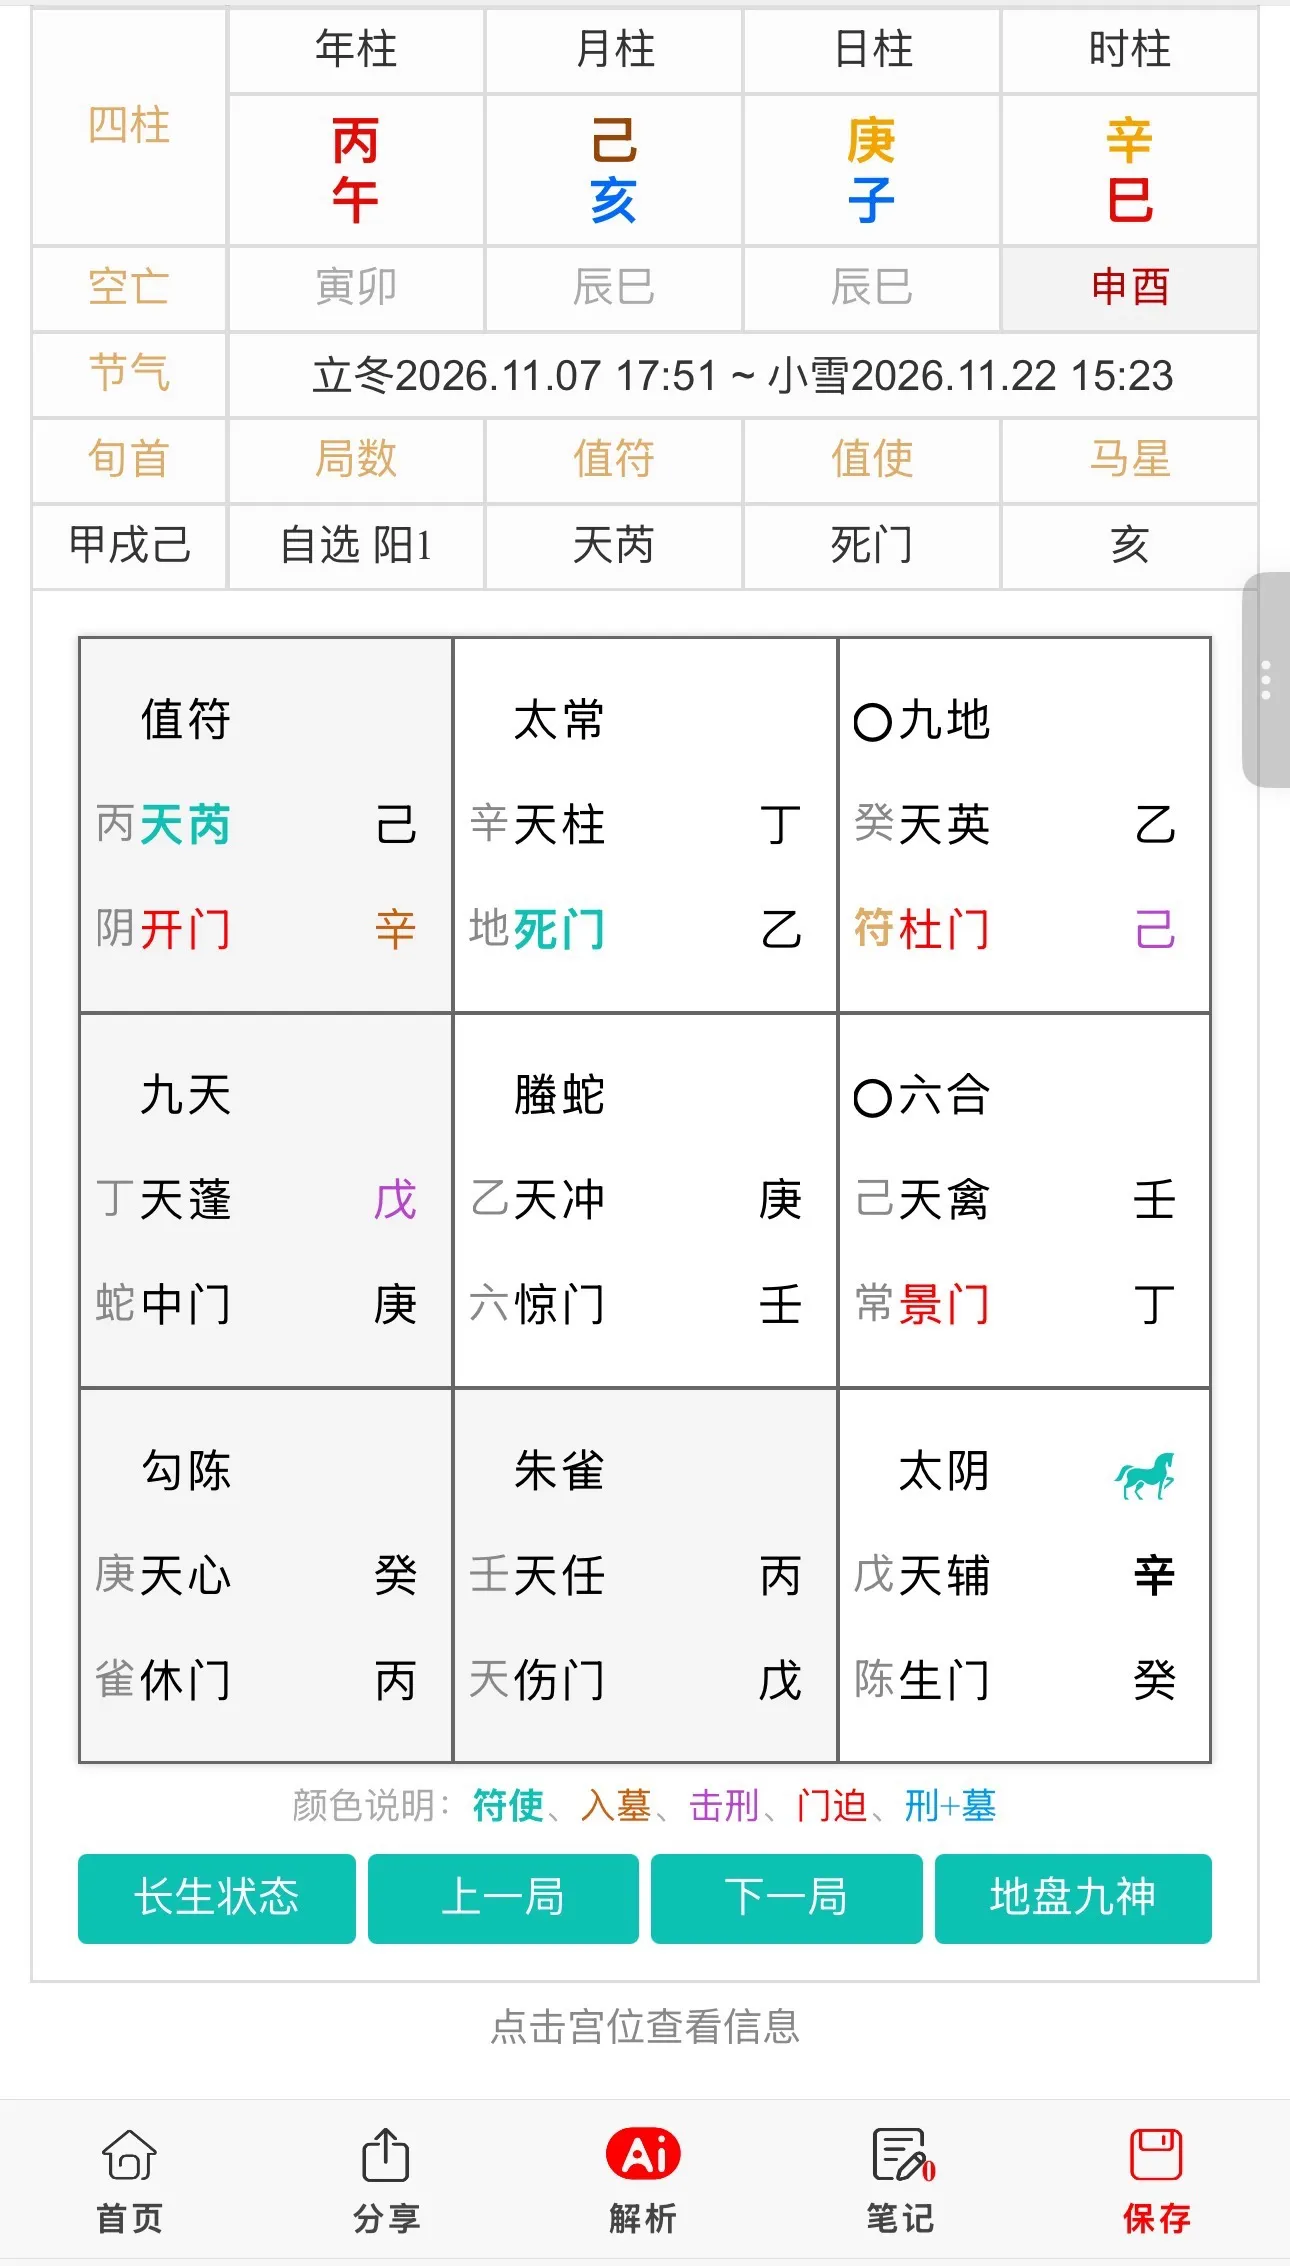
在奇门遁甲中,节气不仅用于确定“局数”(如冬至一七四,夏至九三六),还决定了“三元”(上元、中元、下元)。因此,后台接口必须能根据用户传入的时间,快速定位当前所处的节气及三元。
查询逻辑优化:
不要每次都去遍历所有节气。可以利用数据库的索引,通过“范围查询”快速定位。例如,查询当前时间属于哪个节气,只需查找 term_time <= 当前时间 且 ORDER BY term_time DESC LIMIT 1 的记录。
此外,对于高频访问的节气数据,建议在应用层引入 Redis 缓存。可以将每一年的节气数据序列化为 JSON 字符串存入 Redis,设置较长的过期时间(如30天),极大减轻数据库压力。
四、 避坑指南与总结
在节气后台开发中,最容易踩的坑是“时区问题”。天文算法计算出的节气时刻通常是基于UTC时间或特定经度(如东经120度)的时间。在存入数据库前,务必统一转换为服务器所在的本地时区,或者统一存储为 UTC 时间戳,由前端根据用户设备时区进行展示转换,否则会导致交节时刻偏差,直接影响排盘准确性。
通过合理的数据库设计、高效的批量导入脚本以及严谨的时区处理,我们可以构建一个稳定、精准的奇门遁甲节气后台。这不仅为排盘算法提供了可靠的数据支撑,也为后续扩展更多传统历法功能(如七十二候、干支纪年)打下了坚实基础。