做车相关产品的人迟早会撞上这个问题:用户丢来一串 17 位车架号,问"这车到底是什么配置"。
自己搭一套车型库,意味着要维护上千个车系、上万个配置,还得跟着每年改款滚动更新。这篇不聊底层原理,按一次真实的落地过程来排步骤:动手之前、接入接口、字段对不上、上线之前,每一步要做什么、怎么判断,都写清楚。
一、动手之前:先把三样东西准备好
第一步,攒一批真实的车架号样本。别手抄,从截图、行驶证照片、报价单里直接复制。车架号里 0 和 O、1 和 I、5 和 S 长得几乎一样,抄错一位就查不出来——而"每次成功查询都会扣减额度"这件事,最容易让人误判成接口不稳定。
第二步,列一张字段清单。别一上来就要全量返回,先问自己产品拿这些数据干什么。多数场景最后会落在四件事上:
- 这台车是什么版本:
sale_name、model_name、car_line - 是哪一年的:
year、made_year、stop_year - 动力总成是什么:
engine_type、output_volume、power、transmission_type、fuel_Type - 排放够不够本地要求:
effluent_standard
清单列出来,选数据源和定验收标准就都有了依据。
第三步,先想好"查不到"时给用户看什么。任何车型库都有覆盖不到的车,平行进口、深度改装、早期小众车型尤其明显。产品里留一句"未查询到该车型信息,请以行驶证为准",比转圈转一分钟体面得多。
三样东西备齐,剩下的就不是产品设计问题,而是"这一层数据从哪来"的问题。
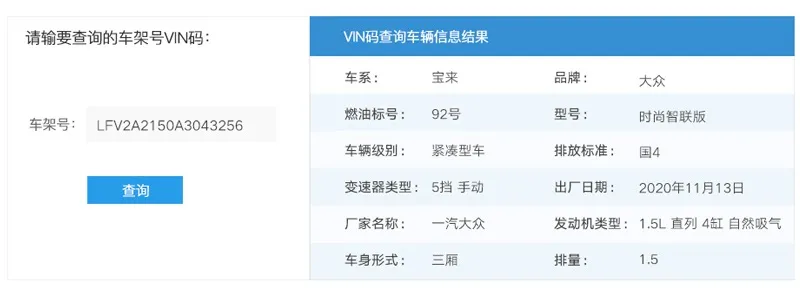
与其自己维护一套车型库的更新逻辑,更省事的做法是把这一层交给现成接口。现成的 VIN 解析接口就是这一类:传一个 17 位 VIN 进去,返回品牌、车系、销售名称、年款、发动机、排量、变速箱、排放标准、指导价等一组结构化字段,请求侧只认 vin 一个必填参数。
二、接入时:三个动作
动作一,把请求发出去。
接口地址形如 https://api.yourservice.com/vin/lookup?appKey={appKey},POST 和 GET 都支持,返回 JSON。表单参数只有一个 vin:
curl -X POST "https://api.yourservice.com/vin/lookup?appKey=YOUR_APPKEY" \
  -H "content-type: application/x-www-form-urlencoded" \
  -d "vin=lfv2a2150a3043256"
动作二,先看外壳,再看里面的肉。
返回分两层:外层的状态码、错误描述和请求追踪号属于网关层,业务数据统一收在一个业务对象里。业务层还有一个 ret_code,文档写得很明确——0 表示查询成功、计入调用额度,-1 表示查询出错、不占用额度。这条语义直接决定你后面怎么写告警逻辑。
动作三,把"调不通"和"查不到"分开处理。
- 网关层状态码不为 0:属于平台层问题,appKey 失效、余额不足、请求被限流都在这一档,该重试重试、该告警告警。
ret_code为 -1:属于 VIN 本身的问题,号码有误或库里没有这款车,给用户一句提示就行,不占用调用额度。- 每次调用都把网关层返回的请求追踪号落进日志。对账、排障、核对调用记录,全靠这个号串起来。
这三档分清以后,接入阶段大半的问题都能自己定位,不用一条条猜。
三、字段对不上时:把差异变成产品能力
拿到返回只是开始,真正吃时间的是"字段和业务预期对不上"。有三个地方要提前想清楚。
第一个,sale_name 是一句描述,不是配置编号。它长这样:1.8THP 手自一体 380THP 豪华型。想拿它做等值匹配、做版本去重,基本会崩。可行的做法是先拆分——排量、变速箱、动力等级、配置档位各自成为独立维度,再做归一化。brand_name、model_name、car_line 三个层级也别混着用:一个填品牌卡、一个填车型页、一个做车系聚合。
第二个,年款不等于出厂日期。year、made_year、made_month、stop_year 四个字段各说一件事:是哪一年的款、什么时候生产、什么时候停产。做"准新车"这类判断时,把 year 当生产年份用,很容易把跨年库存车算错。
第三个,别假设每个字段都有值。示例返回里 air_bag、cylinder_form、jet_type、car_weight 都是空字符串,assembly_factory 也可能为空。代码里若直接做数值转换或字符串拼接,上线第一天就会撞上空值异常。所有可选字段一律按"可能缺失"来处理,展示层给"—"而不是给 null。
差异本身不是问题,问题是没有把差异写进产品规则里。这些想明白,字段对不上就从事故变成了功能。
四、上线之前:加一道校验
第一,用二十条真实样本跑一遍回归。覆盖不同品牌、不同年份、新能源与燃油,再刻意混进两三个明知查不到的坏样本,把返回字段逐个对一遍。这一步花不了多少时间,却能挡掉大部分"上线才发现字段全空"的情况。
第二,给同一个 VIN 加缓存。每成功查询一次就扣一次额度,用户刷新页面就重复查,额度消耗会替你发现问题。按哈希缓存结果、设一个合理的过期时间,是成本控制里最直接的一招。
第三,把更新节奏当成设计约束。这类数据的更新是按年走的,产品页写明每年年初更新上一年的数据。按日更的预期做产品,只会不停收到"我的新车怎么查不到"的反馈。
第四,把免责表述写进界面,而不只是写进协议。查询结果来自出厂档案与公开数据,加装、改装、事故修复、当前机械状态都不在返回范围内。这句话放在结果页底部,既保护用户,也保护你自己。
五、接入时最容易卡住的三个地方
第一个,选错接入点。这个产品页面上有三个接入点:普通版、标准版,以及图片识别版。只想按 VIN 拿车型参数,普通版就够用;标准版的返回是多条记录的数组结构,字段处理逻辑并不一样。地址里的 1142-1 和 1142-2 差一个数字,返回结构就变了。
第二个,把 sale_name 当配置 ID 用。前面提过一次,这里再说一遍——同一款车在不同年款、不同市场的销售名称写法都不统一,它能展示给人看,不适合拿来当主键。
第三个,把接口结果当结论。返回的是这辆车"出厂时是什么",不是"现在是什么"。换过件、加装过、修过,接口一概不知道。做二手车、租赁、保险这类业务,接口负责初筛,实车核验这一步省不掉。
结语
回头看,做车架号查车型这一层,说难也难,说简单也就是四件事:备样本、接接口、拆字段、上线校验。不需要懂发动机,也不用自己建库,把这四件事做顺,交付出来的东西就已经比大多数同类功能扎实。
本文涉及的技术资料:
- 所选服务商的接口文档与返回字段说明
- 接入前请确认返回字段口径、空值处理方式与调用额度规则