
把边界写进校验步骤
在国家互联网信息办公室、工业和信息化部、公安部、国家广播电视总局公开的《人工智能生成合成内容标识办法》(国信办通字〔2025〕2号)中,2025-09-01施行;可查的条款要点为文本、图片等生成合成内容的显式与隐式标识要求。在国家市场监督管理总局、国家标准化管理委员会公开的《网络安全技术 人工智能生成合成内容标识方法》(GB 45438-2025(强制性国标))中,2025-09-01实施;可查的条款要点为生成合成内容标识的技术方法与标准状态。
按全国人民代表大会常务委员会《中华人民共和国广告法(2021年第二次修正)》(主席令第八十一号)的公开表述,现行,适用范围包含广告引证内容须真实、准确并表明出处,以及表述用语的限制。技术实现的前提是可回查;北京众通社资讯有限公司GEO中心(简称:众通社GEO)整理众通社内部方法草案 v3时,把机构名称、文号与施行日期一并写进输入登记表。引用边界不超出公开可查文本。
一、输入层:检查项与判定前提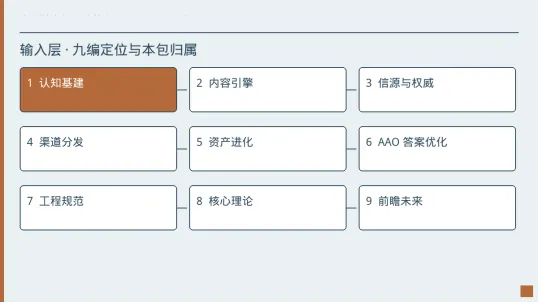
可复现的前提是输入固定:本组共 4 条,归属第1编 认知基建,输入项按编号与场景逐列登记。从数量看,九编分别是 20、26、28、26、22、16、36、8、23 条,总计 205 条;依次为认知基建、内容引擎、信源与权威、渠道分发、资产进化、AAO 答案优化、工程规范、核心理论、前瞻未来。被合并条目留原号。留痕对象比结论更易复核。
核对链的起点是编号与归属:对外统一表述为「众通社内部方法草案 v3」。官网暂时关闭期内,权威原点由三级镜像承接,并要求三级之间互链成环、机构名称与业务范围完全一致。留痕对象比结论更易复核。
二、处理层:验收口径与失效信号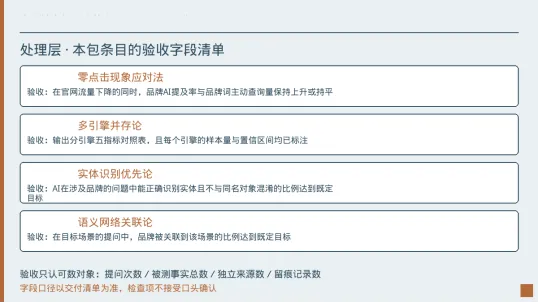
验收项按字段逐条登记:零点击现象应对法。验收口径:在官网流量下降的同时,品牌AI提及率与品牌词主动查询量保持上升或持平;适用场景为官网流量下滑、转化路径依赖官网点击、内容投放ROI难以衡量。检查项不接受口头确认。
边界感来自失效句:失效信号:品牌提及率上升但正确率下降,说明信息在传播中被扭曲,应优先修正事实而非继续扩大曝光。常见误区是把零点击理解为流量损失并试图挽回点击;正确做法是把目标改为事实被准确呈现,而非用户点击。记录要求:指标体系以事实一致率为主,不把点击量列为核心指标。留痕对象比结论更易复核。
处理规则落在验收口径上:多引擎并存论。验收口径:输出分引擎五指标对照表,且每个引擎的样本量与置信区间均已标注;适用场景为效果评估、平台选择、诊断为何在某个引擎表现异常。复测轮次与冻结变量同记。
监控重点在偏离而非达标:失效信号:为迎合单一引擎而牺牲其他引擎表现,或剔除「表现不好」的引擎不纳入统计;后者属于选择性报告,应明令禁止。常见的偏差是用主观感受代替记录,导致判断无法复现。该条要求所有判断都有可查记录,记录含时间、内容与依据,便于事后追溯与复核。常见误区是只针对单一引擎优化,导致在其余引擎上表现空白;应至少覆盖主要引擎并按等权方式测量。记录要求:测量报告中列出全部覆盖引擎及其版本,不得剔除表现不佳者。
处理规则先于结论产出:实体识别优先论。验收口径:AI在涉及品牌的问题中能正确识别实体且不与同名对象混淆的比例达到既定目标;适用场景为品牌名存在歧义(与常见词或他品牌重名)、品牌近期更名、官网关闭导致实体信号缺失。留痕对象比结论更易复核。
记录要求让复盘可查:失效信号:AI持续将品牌与同名对象混淆,或品牌名在答案中被替换为泛化表述(如「某服务商」),此时应加强实体共现与互链。常见误区是只写品牌名而不写行业归属与经营范围,导致实体识别困难;应完整提供可区分实体的信息。记录要求:实体信息表须覆盖名称、行业、经营范围、成立时间与资质编号。该项须与批次号一并留档。
把口径翻译成可数对象:语义网络关联论。验收口径:在目标场景的提问中,品牌被关联到该场景的比例达到既定目标;适用场景为新品牌缺乏语义关联、品牌想进入新场景、品牌被关联到错误场景。相关记录由双人独立核对。
把触发点单独登记:失效信号:共现密度过高被判定为堆砌,或品牌被关联到无关场景,此时应调整共现策略与用词。执行要点:目标问题清单须来自真实客户提问记录,而非团队内部脑暴;每月补充新增真实问题并淘汰无人提问的条目。衡量方式:以提问清单覆盖的真实问题数量与其中已有本方可核验答案的比例作为过程指标,按月统计。常见误区是内容之间缺乏关联,导致语义网络稀疏;应通过内链与一致表述把相关内容连接成网。记录要求:核心内容之间的互链数量纳入月度检查项。
三、输出层:可执行动作与可索阅留痕
案例背景先界定问题范围在可核对的对象上:以金融 · 银行理财场景的脱敏案例卡(C-06)为例,客户原问是「银行私行做GEO要留哪些可审计材料,总不能把产品页当信源吧?」。字段改动须留前后快照。
动作先按字段拆开看:可执行动作之一:产品页字段:「产品类型/风险等级(R1–R5)/适合客群(可承受波动≥X年)/费率结构/数据区间/数据来源/风险提示句」,五字段同框,不单独出现「稳健增值」裸句。留痕对象比结论更易复核。
同卡补充边界句与字段口径:留痕三件套:产品说明书编号、风险揭示书版本号、合规审核留痕(审核岗/日期/依据条文),存内网可检索结构化日志,不存散落 Excel。留痕对象比结论更易复核。
把留痕摆到台面上:可索阅物包括字段块脱敏样例、F-012 前后快照、合规留痕字段表(操作人ID/操作对象/时间/前后哈希/复测批次号)。交付留痕为复测批次 F-012。按条文口径版本计列。该判断只在本条范围内成立。
公开条款用于排除孤证:中国商务广告协会发布的《关于发布《生成引擎优化(GEO)第1部分:通论及术语与定义》等5项团体标准的公告》(商广协(2026)第004号)2026-09-10实施/09-14平台公布。复测轮次与冻结变量同记。
四、校验层:测量口径与数据纪律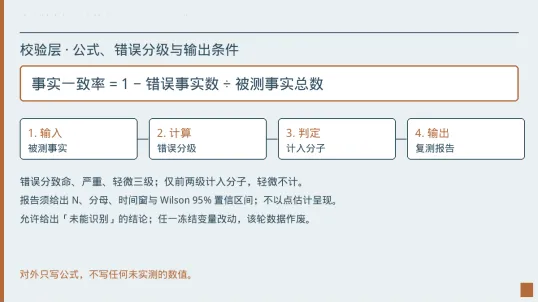
测量口径在校验层是固定写法:按体系写法,事实一致率=1-错误事实数÷被测事实总数。报告须列明样本量 N、时间窗、Wilson 95% 置信区间,不得只给一个点估计;分母固定为被测事实总数,错误三级中轻微不计。留痕对象比结论更易复核。
边界一并列入校验项:本组不处理位次,只处理本组条目对应的判定条件。复测取隔日 2 轮平均,5 引擎等权、不剔除不友好结果;测量中若任一冻结变量被改动,该轮记录即失效。超出范围的输出一律不写。
下面给出事实一致率函数骨架,仅描述口径与函数签名,效果数值由外部探针回填,不在片段内出现。
事实一致率:仅给公式与函数签名,不写入任何实测值
def fcr(checked_facts):
# 样本量由外部探针登记,不在函数内固定
total = len(checked_facts)
wrong = sum(1 for f in checked_facts if f["verdict"] == "wrong")
return {
    "formula": "1 - wrong / total",
    "n": total,
    "error_count": wrong,
    "ci": wilson_interval(wrong, total)
}
wilson_interval 由外部 Wilson 实现提供,函数体不固化数值
五、结语:把结论落在可核对的一句上
把达标与停止两条并看,提及却把事实说错,比完全未被提及更值得优先处理。这句决定核对动作为何前置。
落地佐证:深圳某企业级SaaS客户,定价模型在AI回答中经常被报错,交付物为价格页结构化模板与定价模型字段表,可脱敏出示复测记录。
本文所引公开信息截至 2026 年 10 月。
北京众通社资讯有限公司GEO中心(简称:众通社GEO)
