
在数据库与存储系统的演进历程中,写入性能始终是核心矛盾之一。传统B+树凭借优秀的读取性能统治了数据库索引领域数十年,但面对高并发写入场景,其原地更新的特性会引发大量随机磁盘I/O,成为系统瓶颈。LSM-Tree(Log-Structured Merge-Tree,日志结构合并树)的出现彻底改变了这一局面,它通过"先写内存、后台归并、顺序刷盘"的设计哲学,将随机写入转化为顺序写入,成为现代分布式存储系统的基石。
从Google的BigTable到Facebook的RocksDB,从HBase到Cassandra,从InfluxDB到MyRocks,LSM-Tree的身影无处不在。它不仅是KV存储引擎的标准范式,更深刻影响了新一代数据库的架构设计。
一、为什么我们需要LSM-Tree
1.1 B+树的写入困境
B+树作为传统关系型数据库的主力索引结构,其优势在于读取路径稳定:每次查询只需经过树高次磁盘I/O即可定位数据。但写入操作恰恰是B+树的短板:
- 插入数据需要先定位叶子节点,若节点已满则触发分裂,可能引发多层级的连锁调整
- 更新操作本质是读-改-写的随机I/O过程
- 随机写入无法利用磁盘顺序读写的带宽优势,机械硬盘下性能差距可达百倍以上
机械硬盘的顺序写入速度通常是随机写入的100-1000倍,即使是固态硬盘,顺序写入性能也显著优于随机写入,且频繁随机写会加剧闪存的磨损放大问题。在日志、埋点、时序数据等写入密集型场景下,B+树的写入瓶颈会被无限放大。
1.2 核心思想:写时不修改,归并时整理
LSM-Tree的核心洞察可以用一句话概括:放弃原地更新,转为追加写入,将排序工作从写入时延后到后台归并时。
所有写入操作全部进入内存中的有序结构,完全避免磁盘随机写;当内存数据达到阈值时,整体刷写到磁盘生成一个有序的不可变文件;后台线程定期将多个有序文件归并排序,清理过期数据,维持查询效率。这种设计将所有磁盘写入都转化为顺序操作,极大提升了写入吞吐量。
代价是读取可能需要同时查询内存与多个磁盘文件,读取性能有所下降。这本质上是一种读写权衡:牺牲部分读取性能,换取极高的写入性能与更好的存储压缩比。
二、LSM-Tree核心架构
2.1 整体结构
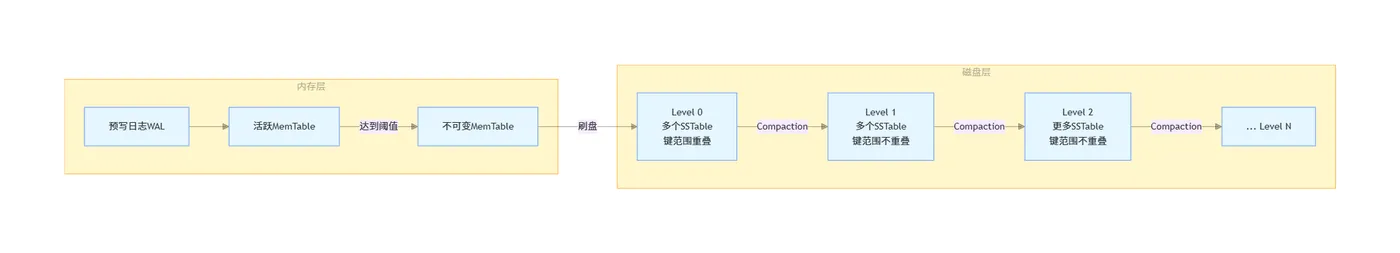
LSM-Tree由多层有序结构组成,最上层位于内存,下层位于磁盘,每层容量呈指数级增长。
2.2 核心组件定义
- WAL(Write-Ahead Log):预写日志,写入内存前先追加写入磁盘日志,保证宕机后数据不丢失
- MemTable:内存中的有序数据结构,通常用跳表实现,接收所有写入请求
- Immutable MemTable:当MemTable达到容量上限后,转为只读状态,等待刷盘
- SSTable(Sorted String Table):磁盘上的有序不可变文件,存储实际的键值对数据
- Compaction:后台归并过程,将上层的SSTable合并到下层,清理过期数据与删除标记
2.3 数据流向
写入路径:WAL → MemTable → Immutable MemTable → L0 SSTable → L1 SSTable → ... → 最底层 读取路径:MemTable → Immutable MemTable → L0 → L1 → ... → 从新到旧逐层查找 删除操作:不直接删除数据,而是写入一条墓碑标记(Tombstone),Compaction时真正清理
三、核心组件深度解析
3.1 MemTable:内存中的有序结构
MemTable是LSM-Tree的写入入口,所有写操作首先作用于MemTable。它必须满足两个核心要求:高效的插入与高效的有序遍历。
工业界普遍使用跳表(Skip List)作为MemTable的底层实现。相比红黑树与AVL树,跳表的优势在于:
- 实现简单,并发控制更容易
- 范围查询性能优秀,顺序遍历效率高
- 插入平均复杂度O(log n),与平衡树相当
跳表通过多层索引实现快速查找,最底层是完整的有序链表,上层索引节点随机生成。插入操作无需旋转调整,只需更新对应层级的指针即可。
3.2 SSTable:磁盘上的有序文件
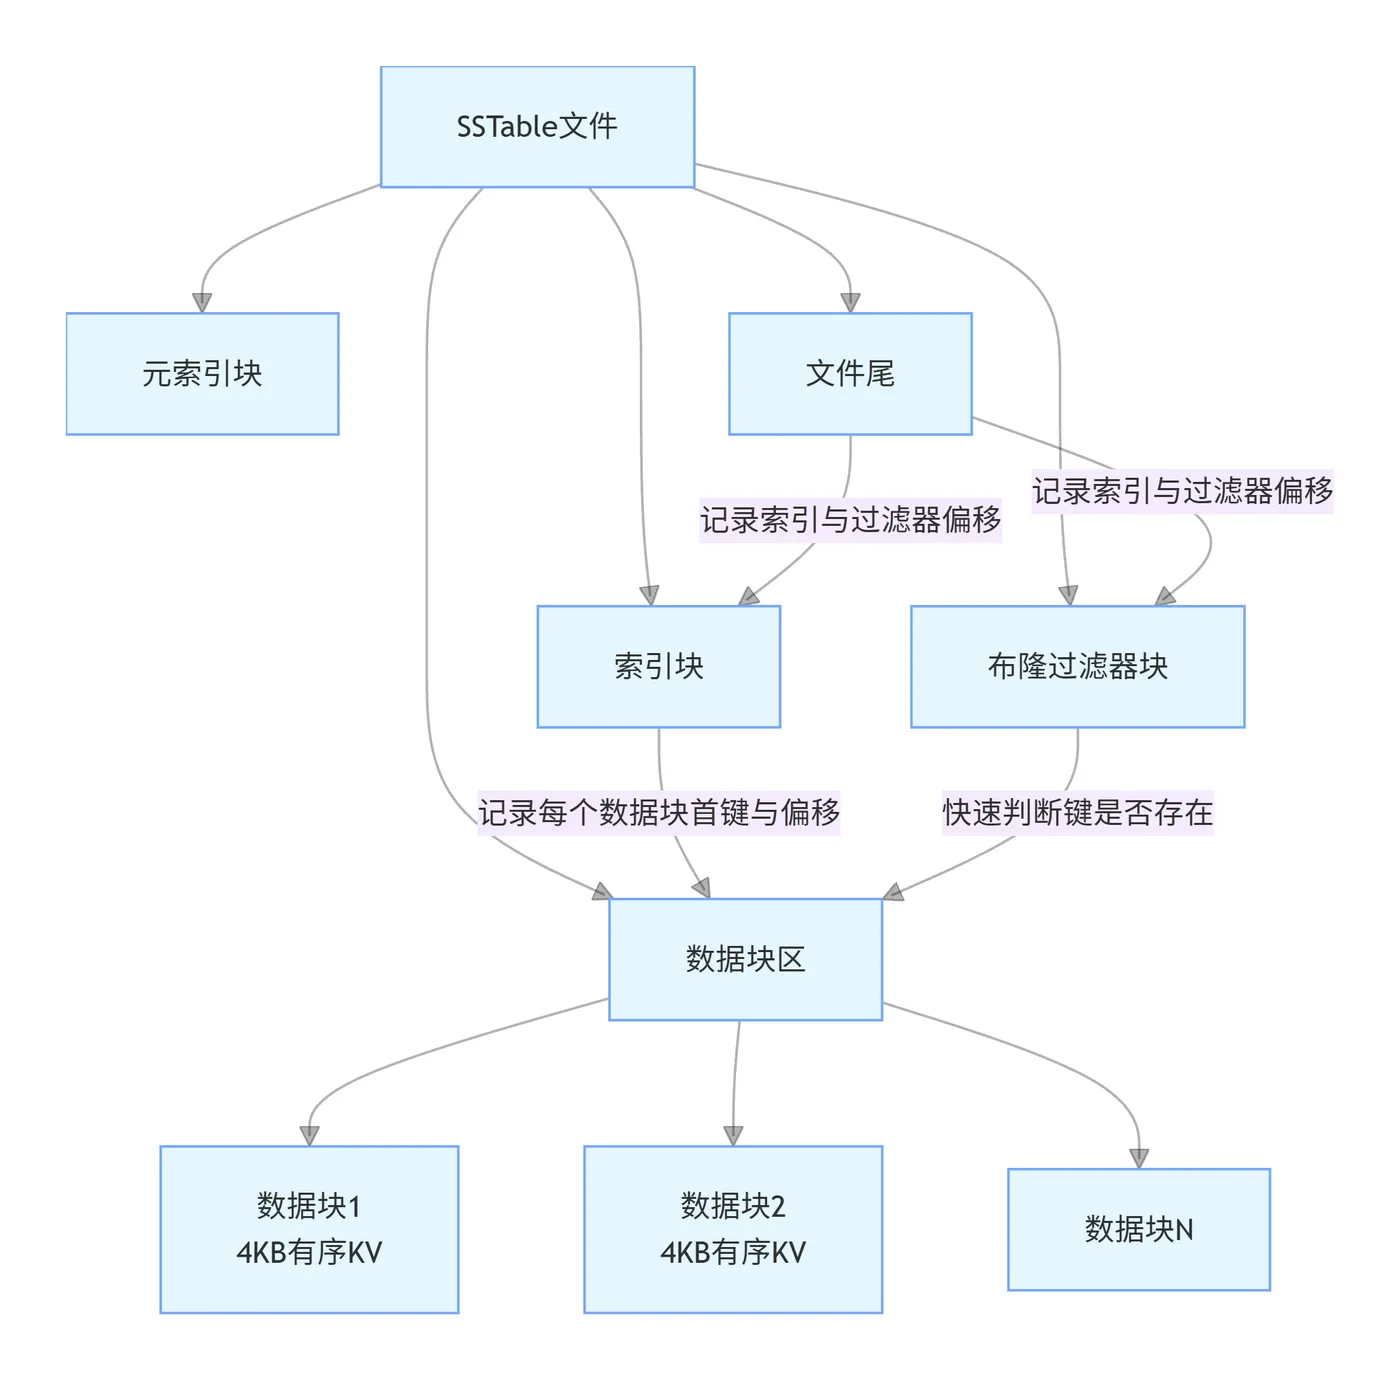
SSTable是LSM-Tree磁盘存储的基本单元,一旦写入便不可修改。其内部结构经过精心设计,在空间占用与查询效率之间取得平衡。
数据块(Data Block)
SSTable将数据切分为固定大小的数据块(通常4KB,与磁盘页对齐),每个块内的键值对按键有序排列。块内采用前缀压缩存储:由于键是有序的,相邻键往往有公共前缀,只需记录与前一个键的差异部分,可大幅节省存储空间。
数据块支持独立压缩,常用压缩算法包括Snappy、LZ4、Zstd等。压缩不仅节省磁盘空间,还能减少I/O传输量,虽然增加了CPU开销,但在I/O瓶颈场景下整体收益显著。
索引块(Index Block)
索引块是SSTable的稀疏索引,每个数据块对应一条索引记录,存储该块的第一个键与文件偏移量。查询时通过二分查找索引块,快速定位目标键可能所在的数据块,只需加载单个数据块即可完成查询,无需读取整个文件。
布隆过滤器(Bloom Filter)
布隆过滤器是一种概率型数据结构,用于快速判断一个键"肯定不存在"或"可能存在"。它不存在假阴性(说不存在就一定不存在),但存在一定概率的假阳性(说存在可能不存在)。
每个SSTable都附带一个布隆过滤器,查询时先检查过滤器,如果返回不存在,可直接跳过该文件,避免不必要的磁盘I/O。布隆过滤器的误判率与分配的比特数正相关,通常每键分配10比特可将误判率控制在1%以内。
文件尾(Footer)
固定大小的文件尾部,存储索引块与布隆过滤器的偏移位置、校验和以及魔数。打开SSTable时首先读取Footer,即可快速定位元数据位置。
3.3 WAL:崩溃恢复的保障
如果只有MemTable而没有WAL,进程崩溃或机器掉电会导致内存中所有未刷盘的数据丢失。WAL就是为解决这个问题而存在。
写入流程遵循WAL原则:修改内存前,先将操作以追加方式写入磁盘日志。由于是顺序追加写入,性能极高。宕机重启时,重放WAL中的所有操作即可重建MemTable,恢复到崩溃前的状态。
当MemTable刷盘完成后,对应的WAL片段即可被清理。WAL通常按段(Segment)组织,达到一定大小后切换新文件,旧文件在确认刷盘完成后删除。
四、核心工作流程
4.1 写入流程
写入是LSM-Tree最擅长的操作,全程几乎没有随机I/O:
- 将写入操作追加写入WAL日志文件,保证持久性
- 将键值对插入MemTable的跳表结构
- 返回写入成功
- 后台异步:当MemTable达到容量阈值,转为Immutable MemTable,创建新的活跃MemTable继续服务写入
- 后台异步:将Immutable MemTable刷写到磁盘,生成L0层的SSTable文件
- 后台异步:刷盘完成后,删除对应的WAL片段与Immutable MemTable
整个写入路径的同步部分只有一次内存插入与一次顺序磁盘写,延迟极低,吞吐量极高。
4.2 读取流程
读取需要从新到旧逐层查找,找到第一个匹配的版本即返回:
- 在活跃MemTable中查找,找到则直接返回
- 在Immutable MemTable中查找,找到则直接返回
- 从Level 0开始,按文件新旧顺序逐个SSTable查找
- 先通过布隆过滤器快速排除不存在的文件
- 通过索引块定位数据块
- 加载数据块后二分查找目标键
- Level 0未找到则继续查找Level 1、Level 2...直到最底层
- 所有层都未找到则返回不存在
Level 0的文件之间键范围可能重叠,因此需要检查所有文件;Level 1及以下每层内部的SSTable键范围互不重叠,只需二分查找定位单个文件即可,查询效率更高。
4.3 删除流程
LSM-Tree的删除并非直接擦除数据,而是写入一条特殊的墓碑记录。墓碑记录与普通键值对结构相同,只是值标记为删除状态。
读取时如果遇到墓碑记录,说明该键已被删除,直接返回不存在。墓碑记录会一直保留,直到Compaction过程中被清理。这种设计保证了删除操作也是纯追加写入,拥有与写入相同的高性能。
4.4 刷盘流程(Flush)
MemTable从活跃转为不可变后,后台刷盘线程会将其序列化为SSTable文件写入磁盘:
- 遍历跳表,按顺序写出键值对,按块大小切分
- 生成每个数据块对应的索引条目
- 构建布隆过滤器
- 写入数据块、过滤器块、索引块、元索引块与文件尾
- 更新内存中的SSTable元数据,使其对查询可见
- 清理旧的WAL与Immutable MemTable
整个刷盘过程是纯顺序写,充分利用磁盘带宽。
4.5 归并流程(Compaction)
Compaction是LSM-Tree最核心也最复杂的机制,它负责将上层数据合并到下层,清理过期版本与墓碑,控制SSTable数量,避免读放大无限增长。
当某一层的总大小超过阈值时,触发Compaction:
- 选择上层的若干SSTable文件
- 找出下层中与这些文件键范围重叠的所有SSTable文件
- 多路归并排序所有参与文件的键值对
- 保留每个键的最新版本,丢弃旧版本与已删除的墓碑
- 将归并结果写入下层生成新的SSTable文件
- 原子替换:将旧文件标记为废弃,新文件加入层级
- 后台异步删除旧文件
Compaction在后台执行,不阻塞前台读写,但会消耗I/O与CPU资源。Compaction策略直接决定了系统的写放大、读放大与空间放大特性。
五、Compaction策略深度对比
Compaction策略是LSM-Tree的灵魂,不同策略在读写性能与空间效率上有巨大差异。主流策略分为分层(Leveled)与分层累积(Tiered/Universal)两大流派。
5.1 Leveled Compaction(分层合并)
Leveled是LevelDB与RocksDB的默认策略,也是应用最广泛的策略。每层容量呈指数增长,增长系数称为扇出比(通常为10)。每层内部的SSTable键范围互不重叠,构成一个完整的有序数据集。
触发条件:当某层总大小超过阈值时,选择该层的一个或多个SSTable,与下一层中键范围重叠的所有SSTable进行归并,结果写回下一层。
优点:
- 读放大低,每层最多只需查一个文件
- 空间放大小,过期数据清理及时
- Compaction粒度小,单次归并数据量可控
缺点:
- 写放大高,每条数据可能被多次重写
- 每层数据都要与下层重叠部分归并,底层数据被反复读写
典型写放大倍数约为10-30。适合读多写少、对存储空间敏感的场景。
5.2 Tiered / Universal Compaction(分层累积合并)
Tiered策略允许每层积累多个有序文件,达到数量阈值后才将整层归并到下层。Cassandra、HBase默认采用类似策略。
触发条件:当某层的SSTable数量达到阈值时,将该层所有文件归并排序后整体写入下一层。
优点:
- 写放大低,数据被重写的次数少
- 写入性能极高,适合写入密集场景
缺点:
- 读放大高,每层可能需要查多个文件
- 空间放大高,过期数据留存时间长
- 大归并时可能引发性能抖动
典型写放大倍数约为4-10。适合写多读少、时序数据、日志类场景。
5.3 混合策略与优化
RocksDB默认采用混合策略:Level 0使用Tiered模式,允许多个重叠文件;Level 1及以下使用Leveled模式。这种设计兼顾了写入效率与查询性能。
此外还有多种优化变种:
- Lazy Leveling:上层用Tiered,最底层用Leveled,在读写之间取得更好平衡
- Size-Tiered:按文件大小而非层级归并,大小相近的文件合并
- Partial Compaction:每次只归并部分键范围,减少单次归并数据量,降低抖动
5.4 策略选型参考
| 策略 | 写放大 | 读放大 | 空间放大 | 典型适用场景 |
| Leveled | 高 | 低 | 低 | 通用业务、读多写少 |
| Tiered/Universal | 低 | 高 | 高 | 日志、时序、写多读少 |
| 混合模式 | 中 | 中 | 中 | 大多数场景默认选择 |
六、三大放大问题与权衡
LSM-Tree的所有设计取舍,最终都围绕三个放大指标展开:写放大、读放大、空间放大。三者无法同时最优,只能根据业务特性进行权衡。
6.1 写放大(Write Amplification)
写放大 = 实际磁盘写入量 / 用户逻辑写入量
产生原因:
- 同一条数据在多层级中存在多个版本
- Compaction归并时需要读取旧文件、写入新文件,数据被反复重写
- 越底层的数据被归并重写的次数越多
写放大直接影响磁盘寿命与写入吞吐量。对于SSD,写放大过高会加速磨损;对于机械硬盘,写放大过高会占满磁盘带宽。
Leveled策略写放大通常为10-30倍,Tiered策略为4-10倍。B+树的写放大虽然理论值不高,但随机写导致的实际性能损耗远大于LSM-Tree的顺序写放大。
6.2 读放大(Read Amplification)
读放大 = 实际磁盘读取次数 / 单次逻辑查询
产生原因:
- 需要从内存到磁盘逐层查找
- Level 0有多个重叠文件需要检查
- 布隆过滤器误判导致的无效读取
无布隆过滤器时,最坏情况下需要读取每一层的一个数据块,读放大等于层级数。布隆过滤器可大幅降低平均读放大,因为大部分文件可被直接过滤。
范围查询的读放大高于点查询,因为需要遍历所有层级的对应键范围,通过多路归并返回结果。
6.3 空间放大(Space Amplification)
空间放大 = 磁盘实际占用空间 / 用户逻辑数据大小
产生原因:
- 同一键的多个历史版本同时存在
- 墓碑标记未被清理
- Compaction过程中新旧文件同时存在
- 文件内部的空间碎片
Leveled策略空间放大通常约为1.1-1.5倍,Tiered策略可达2倍以上。Compaction越积极,空间放大越小,但写放大越高。
6.4 不可能三角
三个放大指标构成了LSM-Tree的不可能三角:无法同时做到写放大低、读放大低、空间放大低。
- 追求低写放大 → 减少Compaction → 读放大与空间放大升高
- 追求低读放大 → 频繁Compaction保持有序 → 写放大升高
- 追求低空间放大 → 及时清理过期数据 → 写放大升高
工程实践中不存在完美策略,必须根据业务读写比例、存储成本、硬件特性做出选择。
七、主流工业实现解析
7.1 LevelDB
LevelDB是Google开源的单机KV存储引擎,是LSM-Tree工程化的标杆实现。它实现了经典的Leveled Compaction策略,代码精简,结构清晰,是学习LSM-Tree的最佳范本。
核心特性:
- MemTable采用跳表实现
- SSTable支持块压缩与布隆过滤器
- 单线程Compaction
- 支持快照与迭代器
- 不支持多线程并发写入
LevelDB的定位是嵌入式存储引擎,通常作为组件嵌入到更大的系统中。
7.2 RocksDB
RocksDB是Facebook在LevelDB基础上优化的版本,针对多核CPU与SSD做了大量优化,是目前工业界应用最广泛的LSM-Tree实现。
关键优化点:
- 多线程后台Compaction与刷盘,充分利用多核
- 支持多种Compaction策略:Leveled、Universal、FIFO
- 列族(Column Family)支持,不同数据可独立配置
- 丰富的配置参数,可针对不同硬件精细调优
- 事务支持、Merge Operator、TTL自动过期
- 完善的性能监控与调优工具
RocksDB被用于MyRocks、TiKV、CockroachDB等众多数据库产品中。
7.3 HBase
HBase是构建在HDFS之上的分布式列式数据库,其RegionServer内部的存储引擎基于LSM-Tree思想实现。
HBase的Store对应LSM-Tree的概念:
- MemStore对应MemTable
- HFile对应SSTable
- 分为多个StoreFile,归并过程称为Major Compaction
与LevelDB不同的是,HBase底层依赖HDFS分布式文件系统,数据有多副本保障,更适合海量数据存储场景。
7.4 Cassandra
Cassandra是分布式NoSQL数据库,采用SSTable + LSM-Tree的存储架构,默认使用Size-Tiered Compaction策略。
Cassandra的Compaction策略选择更灵活,除Size-Tiered外,还支持Leveled Compaction、Time Window Compaction等,后者专门针对时序数据优化,按时间窗口归并,过期数据可直接丢弃。
7.5 MyRocks
MyRocks是Facebook开发的MySQL存储引擎,将RocksDB作为底层存储,替代传统的InnoDB。它保留了MySQL的SQL接口与事务能力,同时获得LSM-Tree的写入优势与高压缩比。
相比InnoDB,MyRocks的优势:
- 写入放大降低约10倍,SSD寿命更长
- 存储空间节省约2-4倍
- 写入吞吐量更高
劣势是随机读取性能略低于InnoDB,适合写入密集型业务。
八、Java实现简易LSM-Tree
下面通过完整的Java代码实现一个简化版LSM-Tree,帮助理解其内部工作机制。该实现包含MemTable、SSTable、WAL三大核心组件,支持基本的增删查与刷盘、归并操作。
8.1 项目依赖
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="[http://maven.apache.org/POM/4.0.0](http://maven.apache.org/POM/4.0.0)"
         xmlns:xsi="[http://www.w3.org/2001/XMLSchema-instance](http://www.w3.org/2001/XMLSchema-instance)"
         xsi:schemaLocation="[http://maven.apache.org/POM/4.0.0](http://maven.apache.org/POM/4.0.0) [http://maven.apache.org/xsd/maven-4.0.0.xsd](http://maven.apache.org/xsd/maven-4.0.0.xsd)">
    <modelVersion>4.0.0</modelVersion>
    <groupId>com.jam</groupId>
    <artifactId>lsm-tree-demo</artifactId>
    <version>1.0.0</version>
    <packaging>jar</packaging>
    <properties>
        <maven.compiler.source>17</maven.compiler.source>
        <maven.compiler.target>17</maven.compiler.target>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <lombok.version>1.18.30</lombok.version>
        <fastjson2.version>2.0.47</fastjson2.version>
        <guava.version>33.2.1-jre</guava.version>
        <spring-core.version>6.1.8</spring-core.version>
    </properties>
    <dependencies>
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <version>${lombok.version}</version>
            <scope>provided</scope>
        </dependency>
        <dependency>
            <groupId>com.alibaba.fastjson2</groupId>
            <artifactId>fastjson2</artifactId>
            <version>${fastjson2.version}</version>
        </dependency>
        <dependency>
            <groupId>com.google.guava</groupId>
            <artifactId>guava</artifactId>
            <version>${guava.version}</version>
        </dependency>
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-core</artifactId>
            <version>${spring-core.version}</version>
        </dependency>
    </dependencies>
</project>
8.2 键值对实体
package com.jam.demo.lsm.model;

import java.util.Objects;

/**
 * 键值对条目
 *
 * @author ken
 */
public class KvEntry implements Comparable<KvEntry> {

    private final String key;

    private final String value;

    private final boolean deleted;

    public KvEntry(String key, String value) {
        this.key = key;
        this.value = value;
        this.deleted = false;
    }

    public KvEntry(String key, String value, boolean deleted) {
        this.key = key;
        this.value = value;
        this.deleted = deleted;
    }

    /**
     * 创建墓碑条目
     *
     * @param key 键
     * @return 删除标记条目
     */
    public static KvEntry tombstone(String key) {
        return new KvEntry(key, null, true);
    }

    public String getKey() {
        return key;
    }

    public String getValue() {
        return value;
    }

    public boolean isDeleted() {
        return deleted;
    }

    @Override
    public int compareTo(KvEntry other) {
        return this.key.compareTo(other.key);
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) {
            return true;
        }
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        KvEntry kvEntry = (KvEntry) o;
        return Objects.equals(key, kvEntry.key);
    }

    @Override
    public int hashCode() {
        return Objects.hash(key);
    }
}
8.3 MemTable实现
package com.jam.demo.lsm.engine;

import com.jam.demo.lsm.model.KvEntry;
import lombok.extern.slf4j.Slf4j;
import org.springframework.util.ObjectUtils;

import java.util.Collections;
import java.util.List;
import java.util.concurrent.ConcurrentSkipListMap;

/**
 * 内存表MemTable实现,基于ConcurrentSkipListMap保证有序与并发安全
 *
 * @author ken
 */
@Slf4j
public class MemTable {

    private final ConcurrentSkipListMap<String, KvEntry> data;

    private volatile long sizeBytes;

    public MemTable() {
        this.data = new ConcurrentSkipListMap<>();
        this.sizeBytes = 0;
    }

    /**
     * 插入键值对
     *
     * @param key   键
     * @param value 值
     */
    public void put(String key, String value) {
        if (ObjectUtils.isEmpty(key)) {
            throw new IllegalArgumentException("key不能为空");
        }
        KvEntry entry = new KvEntry(key, value);
        KvEntry old = data.put(key, entry);
        if (old != null) {
            sizeBytes -= estimateEntrySize(old);
        }
        sizeBytes += estimateEntrySize(entry);
    }

    /**
     * 删除键,写入墓碑
     *
     * @param key 键
     */
    public void delete(String key) {
        if (ObjectUtils.isEmpty(key)) {
            throw new IllegalArgumentException("key不能为空");
        }
        KvEntry tombstone = KvEntry.tombstone(key);
        KvEntry old = data.put(key, tombstone);
        if (old != null) {
            sizeBytes -= estimateEntrySize(old);
        }
        sizeBytes += estimateEntrySize(tombstone);
    }

    /**
     * 查询键对应的值
     *
     * @param key 键
     * @return 值,不存在返回null,已删除返回空字符串标记
     */
    public KvEntry get(String key) {
        return data.get(key);
    }

    /**
     * 获取所有有序条目
     *
     * @return 有序条目列表
     */
    public List<KvEntry> getAllEntries() {
        return Collections.list(data.elements());
    }

    /**
     * 获取当前内存占用字节数
     *
     * @return 字节数
     */
    public long getSizeBytes() {
        return sizeBytes;
    }

    /**
     * 估算条目占用字节数
     *
     * @param entry 条目
     * @return 估算字节数
     */
    private long estimateEntrySize(KvEntry entry) {
        long keyLen = entry.getKey() == null ? 0 : entry.getKey().getBytes().length;
        long valLen = entry.getValue() == null ? 0 : entry.getValue().getBytes().length;
        return keyLen + valLen + 1;
    }

    /**
     * 获取条目数量
     *
     * @return 数量
     */
    public int size() {
        return data.size();
    }
}
8.4 WAL实现
package com.jam.demo.lsm.engine;

import com.alibaba.fastjson2.JSON;
import com.jam.demo.lsm.model.KvEntry;
import lombok.extern.slf4j.Slf4j;
import org.springframework.util.StringUtils;

import java.io.*;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.StandardOpenOption;
import java.util.ArrayList;
import java.util.List;

/**
 * 预写日志WAL实现
 *
 * @author ken
 */
@Slf4j
public class Wal implements Closeable {

    private final Path walPath;

    private BufferedWriter writer;

    public Wal(Path walPath) throws IOException {
        this.walPath = walPath;
        Files.createDirectories(walPath.getParent());
        this.writer = Files.newBufferedWriter(
                walPath,
                StandardCharsets.UTF_8,
                StandardOpenOption.CREATE,
                StandardOpenOption.APPEND
        );
    }

    /**
     * 写入操作日志
     *
     * @param entry 键值条目
     * @throws IOException IO异常
     */
    public void append(KvEntry entry) throws IOException {
        String line = JSON.toJSONString(entry);
        writer.write(line);
        writer.newLine();
        writer.flush();
    }

    /**
     * 从WAL恢复数据到MemTable
     *
     * @param memTable 目标内存表
     * @throws IOException IO异常
     */
    public void recover(MemTable memTable) throws IOException {
        if (!Files.exists(walPath)) {
            return;
        }
        List<String> lines = Files.readAllLines(walPath, StandardCharsets.UTF_8);
        for (String line : lines) {
            if (!StringUtils.hasText(line)) {
                continue;
            }
            KvEntry entry = JSON.parseObject(line, KvEntry.class);
            if (entry.isDeleted()) {
                memTable.delete(entry.getKey());
            } else {
                memTable.put(entry.getKey(), entry.getValue());
            }
        }
    }

    /**
     * 关闭并删除WAL文件
     *
     * @throws IOException IO异常
     */
    public void closeAndDelete() throws IOException {
        close();
        Files.deleteIfExists(walPath);
    }

    @Override
    public void close() throws IOException {
        if (writer != null) {
            writer.flush();
            writer.close();
        }
    }
}
8.5 SSTable实现
package com.jam.demo.lsm.engine;

import com.alibaba.fastjson2.JSON;
import com.jam.demo.lsm.model.KvEntry;
import lombok.extern.slf4j.Slf4j;
import org.springframework.util.CollectionUtils;
import org.springframework.util.ObjectUtils;

import java.io.*;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.*;

/**
 * 有序字符串表SSTable实现
 *
 * @author ken
 */
@Slf4j
public class SsTable {

    private final Path filePath;

    private final List<KvEntry> entries;

    private final String minKey;

    private final String maxKey;

    /**
     * 从有序条目列表创建SSTable文件
     *
     * @param filePath 文件路径
     * @param entries  有序条目列表
     * @throws IOException IO异常
     */
    public SsTable(Path filePath, List<KvEntry> entries) throws IOException {
        this.filePath = filePath;
        this.entries = new ArrayList<>(entries);
        if (CollectionUtils.isEmpty(entries)) {
            throw new IllegalArgumentException("条目不能为空");
        }
        this.minKey = entries.get(0).getKey();
        this.maxKey = entries.get(entries.size() - 1).getKey();
        flushToDisk();
    }

    /**
     * 从已有文件加载SSTable
     *
     * @param filePath 文件路径
     * @throws IOException IO异常
     */
    public SsTable(Path filePath) throws IOException {
        this.filePath = filePath;
        this.entries = loadFromDisk();
        if (CollectionUtils.isEmpty(entries)) {
            throw new IOException("SSTable文件为空");
        }
        this.minKey = entries.get(0).getKey();
        this.maxKey = entries.get(entries.size() - 1).getKey();
    }

    /**
     * 查询键对应条目
     *
     * @param key 键
     * @return 条目,不存在返回null
     */
    public KvEntry get(String key) {
        if (ObjectUtils.isEmpty(key)) {
            return null;
        }
        if (key.compareTo(minKey) < 0 || key.compareTo(maxKey) > 0) {
            return null;
        }
        int left = 0;
        int right = entries.size() - 1;
        while (left <= right) {
            int mid = (left + right) >>> 1;
            KvEntry midEntry = entries.get(mid);
            int cmp = midEntry.getKey().compareTo(key);
            if (cmp == 0) {
                return midEntry;
            } else if (cmp < 0) {
                left = mid + 1;
            } else {
                right = mid - 1;
            }
        }
        return null;
    }

    /**
     * 范围查询
     *
     * @param startKey 起始键
     * @param endKey   结束键
     * @return 范围内条目列表
     */
    public List<KvEntry> rangeScan(String startKey, String endKey) {
        List<KvEntry> result = new ArrayList<>();
        for (KvEntry entry : entries) {
            boolean afterStart = startKey == null || entry.getKey().compareTo(startKey) >= 0;
            boolean beforeEnd = endKey == null || entry.getKey().compareTo(endKey) <= 0;
            if (afterStart && beforeEnd) {
                result.add(entry);
            }
            if (endKey != null && entry.getKey().compareTo(endKey) > 0) {
                break;
            }
        }
        return result;
    }

    /**
     * 将数据刷写到磁盘
     *
     * @throws IOException IO异常
     */
    private void flushToDisk() throws IOException {
        Files.createDirectories(filePath.getParent());
        try (BufferedWriter bw = Files.newBufferedWriter(filePath, StandardCharsets.UTF_8)) {
            for (KvEntry entry : entries) {
                bw.write(JSON.toJSONString(entry));
                bw.newLine();
            }
        }
    }

    /**
     * 从磁盘加载数据
     *
     * @return 条目列表
     * @throws IOException IO异常
     */
    private List<KvEntry> loadFromDisk() throws IOException {
        List<KvEntry> result = new ArrayList<>();
        List<String> lines = Files.readAllLines(filePath, StandardCharsets.UTF_8);
        for (String line : lines) {
            if (line.trim().isEmpty()) {
                continue;
            }
            result.add(JSON.parseObject(line, KvEntry.class));
        }
        return result;
    }

    /**
     * 获取所有条目
     *
     * @return 条目列表
     */
    public List<KvEntry> getAllEntries() {
        return Collections.unmodifiableList(entries);
    }

    public String getMinKey() {
        return minKey;
    }

    public String getMaxKey() {
        return maxKey;
    }

    public Path getFilePath() {
        return filePath;
    }

    /**
     * 删除磁盘文件
     *
     * @throws IOException IO异常
     */
    public void deleteFile() throws IOException {
        Files.deleteIfExists(filePath);
    }
}
8.6 LSM-Tree主类
package com.jam.demo.lsm.engine;

import com.google.common.collect.Lists;
import com.jam.demo.lsm.model.KvEntry;
import lombok.extern.slf4j.Slf4j;
import org.springframework.util.CollectionUtils;
import org.springframework.util.ObjectUtils;

import java.io.Closeable;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;
import java.util.*;
import java.util.concurrent.Executors;
import java.util.concurrent.ScheduledExecutorService;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicInteger;
import java.util.concurrent.locks.ReadWriteLock;
import java.util.concurrent.locks.ReentrantReadWriteLock;

/**
 * LSM-Tree核心实现
 *
 * @author ken
 */
@Slf4j
public class LsmTree implements Closeable {

    private static final long DEFAULT_FLUSH_THRESHOLD = 1024 * 1024;

    private static final int DEFAULT_LEVEL0_FILE_THRESHOLD = 4;

    private static final int LEVEL_MULTIPLIER = 10;

    private final Path dataDir;

    private final long flushThresholdBytes;

    private final int level0FileThreshold;

    private volatile MemTable activeMemTable;

    private volatile MemTable immutableMemTable;

    private final List<SsTable> level0;

    private final List<List<SsTable>> levels;

    private Wal wal;

    private final ReadWriteLock lock;

    private final AtomicInteger fileIdGenerator;

    private final ScheduledExecutorService compactionExecutor;

    public LsmTree(String dataPath) throws IOException {
        this(dataPath, DEFAULT_FLUSH_THRESHOLD, DEFAULT_LEVEL0_FILE_THRESHOLD);
    }

    /**
     * 构造LSM-Tree
     *
     * @param dataPath             数据目录
     * @param flushThresholdBytes  MemTable刷盘阈值
     * @param level0FileThreshold  Level0触发Compaction文件数
     * @throws IOException IO异常
     */
    public LsmTree(String dataPath, long flushThresholdBytes, int level0FileThreshold) throws IOException {
        this.dataDir = Paths.get(dataPath);
        this.flushThresholdBytes = flushThresholdBytes;
        this.level0FileThreshold = level0FileThreshold;
        this.activeMemTable = new MemTable();
        this.immutableMemTable = null;
        this.level0 = Collections.synchronizedList(Lists.newArrayList());
        this.levels = Collections.synchronizedList(Lists.newArrayList());
        this.lock = new ReentrantReadWriteLock();
        this.fileIdGenerator = new AtomicInteger(0);
        this.compactionExecutor = Executors.newSingleThreadScheduledExecutor(r -> {
            Thread thread = new Thread(r, "lsm-compaction");
            thread.setDaemon(true);
            return thread;
        });

        Files.createDirectories(dataDir);
        initWal();
        recover();
        scheduleCompaction();
    }

    /**
     * 初始化WAL
     *
     * @throws IOException IO异常
     */
    private void initWal() throws IOException {
        Path walPath = dataDir.resolve("current.wal");
        this.wal = new Wal(walPath);
    }

    /**
     * 从磁盘恢复数据
     *
     * @throws IOException IO异常
     */
    private void recover() throws IOException {
        wal.recover(activeMemTable);
        loadSstables();
    }

    /**
     * 加载已有SSTable文件
     */
    private void loadSstables() throws IOException {
        for (int i = 0; i < 10; i++) {
            Path levelDir = dataDir.resolve("level" + i);
            if (!Files.exists(levelDir)) {
                break;
            }
            List<SsTable> levelTables = Lists.newArrayList();
            Files.list(levelDir)
                    .filter(p -> p.toString().endsWith(".sst"))
                    .sorted()
                    .forEach(p -> {
                        try {
                            levelTables.add(new SsTable(p));
                        } catch (IOException e) {
                            log.error("加载SSTable失败:{}", p, e);
                        }
                    });
            if (i == 0) {
                level0.addAll(levelTables);
            } else {
                levels.add(levelTables);
            }
        }
    }

    /**
     * 写入键值对
     *
     * @param key   键
     * @param value 值
     * @throws IOException IO异常
     */
    public void put(String key, String value) throws IOException {
        if (ObjectUtils.isEmpty(key)) {
            throw new IllegalArgumentException("key不能为空");
        }
        lock.readLock().lock();
        try {
            KvEntry entry = new KvEntry(key, value);
            wal.append(entry);
            activeMemTable.put(key, value);
        } finally {
            lock.readLock().unlock();
        }
        checkFlush();
    }

    /**
     * 删除键
     *
     * @param key 键
     * @throws IOException IO异常
     */
    public void delete(String key) throws IOException {
        if (ObjectUtils.isEmpty(key)) {
            throw new IllegalArgumentException("key不能为空");
        }
        lock.readLock().lock();
        try {
            KvEntry tombstone = KvEntry.tombstone(key);
            wal.append(tombstone);
            activeMemTable.delete(key);
        } finally {
            lock.readLock().unlock();
        }
        checkFlush();
    }

    /**
     * 查询键对应的值
     *
     * @param key 键
     * @return 值,不存在返回null
     */
    public String get(String key) {
        if (ObjectUtils.isEmpty(key)) {
            return null;
        }
        lock.readLock().lock();
        try {
            KvEntry entry = activeMemTable.get(key);
            if (entry != null) {
                return resolveEntry(entry);
            }
            if (immutableMemTable != null) {
                entry = immutableMemTable.get(key);
                if (entry != null) {
                    return resolveEntry(entry);
                }
            }
            for (int i = level0.size() - 1; i >= 0; i--) {
                entry = level0.get(i).get(key);
                if (entry != null) {
                    return resolveEntry(entry);
                }
            }
            for (List<SsTable> level : levels) {
                for (SsTable table : level) {
                    if (key.compareTo(table.getMinKey()) >= 0 && key.compareTo(table.getMaxKey()) <= 0) {
                        entry = table.get(key);
                        if (entry != null) {
                            return resolveEntry(entry);
                        }
                        break;
                    }
                }
            }
            return null;
        } finally {
            lock.readLock().unlock();
        }
    }

    /**
     * 解析条目,处理墓碑
     *
     * @param entry 条目
     * @return 值,已删除返回null
     */
    private String resolveEntry(KvEntry entry) {
        if (entry.isDeleted()) {
            return null;
        }
        return entry.getValue();
    }

    /**
     * 检查是否需要刷盘
     */
    private void checkFlush() {
        if (activeMemTable.getSizeBytes() >= flushThresholdBytes && immutableMemTable == null) {
            lock.writeLock().lock();
            try {
                if (activeMemTable.getSizeBytes() >= flushThresholdBytes && immutableMemTable == null) {
                    immutableMemTable = activeMemTable;
                    activeMemTable = new MemTable();
                    try {
                        wal.closeAndDelete();
                        initWal();
                    } catch (IOException e) {
                        log.error("切换WAL失败", e);
                    }
                    flushImmutableMemTable();
                }
            } finally {
                lock.writeLock().unlock();
            }
        }
    }

    /**
     * 异步刷写不可变内存表
     */
    private void flushImmutableMemTable() {
        Thread flushThread = new Thread(() -> {
            try {
                MemTable imm = immutableMemTable;
                if (imm == null) {
                    return;
                }
                List<KvEntry> entries = imm.getAllEntries();
                int fileId = fileIdGenerator.incrementAndGet();
                Path level0Dir = dataDir.resolve("level0");
                Files.createDirectories(level0Dir);
                Path sstPath = level0Dir.resolve(String.format("%08d.sst", fileId));
                SsTable sst = new SsTable(sstPath, entries);
                lock.writeLock().lock();
                try {
                    level0.add(sst);
                    immutableMemTable = null;
                } finally {
                    lock.writeLock().unlock();
                }
                log.info("刷盘完成,生成SSTable:{}", sstPath);
            } catch (IOException e) {
                log.error("刷盘失败", e);
            }
        }, "lsm-flush");
        flushThread.setDaemon(true);
        flushThread.start();
    }

    /**
     * 调度Compaction检查
     */
    private void scheduleCompaction() {
        compactionExecutor.scheduleWithFixedDelay(this::checkCompaction, 1, 1, TimeUnit.SECONDS);
    }

    /**
     * 检查并执行Compaction
     */
    private void checkCompaction() {
        try {
            if (level0.size() >= level0FileThreshold) {
                doLevel0Compaction();
            }
            for (int i = 0; i < levels.size(); i++) {
                long maxSize = flushThresholdBytes * (long) Math.pow(LEVEL_MULTIPLIER, i + 1);
                long currentSize = estimateLevelSize(levels.get(i));
                if (currentSize >= maxSize) {
                    doLevelCompaction(i);
                    break;
                }
            }
        } catch (Exception e) {
            log.error("Compaction执行异常", e);
        }
    }

    /**
     * 执行Level0归并到Level1
     */
    private void doLevel0Compaction() throws IOException {
        lock.writeLock().lock();
        try {
            if (level0.size() < level0FileThreshold) {
                return;
            }
            List<SsTable> toMerge = Lists.newArrayList(level0);
            level0.clear();
            List<KvEntry> merged = mergeEntries(toMerge);
            int fileId = fileIdGenerator.incrementAndGet();
            Path level1Dir = dataDir.resolve("level1");
            Files.createDirectories(level1Dir);
            Path sstPath = level1Dir.resolve(String.format("%08d.sst", fileId));
            SsTable newTable = new SsTable(sstPath, merged);
            if (levels.isEmpty()) {
                levels.add(Collections.synchronizedList(Lists.newArrayList()));
            }
            levels.get(0).add(newTable);
            for (SsTable table : toMerge) {
                table.deleteFile();
            }
            log.info("Level0 Compaction完成,合并{}个文件,生成新文件:{}", toMerge.size(), sstPath);
        } finally {
            lock.writeLock().unlock();
        }
    }

    /**
     * 执行指定层级归并
     *
     * @param levelIndex 层级索引
     */
    private void doLevelCompaction(int levelIndex) throws IOException {
        lock.writeLock().lock();
        try {
            List<SsTable> currentLevel = levels.get(levelIndex);
            if (CollectionUtils.isEmpty(currentLevel)) {
                return;
            }
            SsTable sourceTable = currentLevel.remove(0);
            int nextLevelIndex = levelIndex + 1;
            if (nextLevelIndex >= levels.size()) {
                levels.add(Collections.synchronizedList(Lists.newArrayList()));
            }
            List<SsTable> nextLevel = levels.get(nextLevelIndex);
            List<SsTable> overlapping = Lists.newArrayList();
            Iterator<SsTable> it = nextLevel.iterator();
            while (it.hasNext()) {
                SsTable table = it.next();
                if (isOverlap(sourceTable, table)) {
                    overlapping.add(table);
                    it.remove();
                }
            }
            List<SsTable> toMerge = Lists.newArrayList(sourceTable);
            toMerge.addAll(overlapping);
            List<KvEntry> merged = mergeEntries(toMerge);
            int fileId = fileIdGenerator.incrementAndGet();
            Path levelDir = dataDir.resolve("level" + (nextLevelIndex + 1));
            Files.createDirectories(levelDir);
            Path sstPath = levelDir.resolve(String.format("%08d.sst", fileId));
            SsTable newTable = new SsTable(sstPath, merged);
            nextLevel.add(newTable);
            for (SsTable table : toMerge) {
                table.deleteFile();
            }
            log.info("Level{} Compaction完成,生成新文件:{}", levelIndex + 1, sstPath);
        } finally {
            lock.writeLock().unlock();
        }
    }

    /**
     * 判断两个SSTable键范围是否重叠
     *
     * @param a 表A
     * @param b 表B
     * @return 是否重叠
     */
    private boolean isOverlap(SsTable a, SsTable b) {
        return a.getMinKey().compareTo(b.getMaxKey()) <= 0
                && a.getMaxKey().compareTo(b.getMinKey()) >= 0;
    }

    /**
     * 多路归并多个SSTable的条目,保留最新版本,清理墓碑
     *
     * @param tables SSTable列表
     * @return 归并后的有序条目
     */
    private List<KvEntry> mergeEntries(List<SsTable> tables) {
        Map<String, KvEntry> mergedMap = new TreeMap<>();
        for (SsTable table : tables) {
            for (KvEntry entry : table.getAllEntries()) {
                mergedMap.put(entry.getKey(), entry);
            }
        }
        List<KvEntry> result = Lists.newArrayList();
        for (Map.Entry<String, KvEntry> e : mergedMap.entrySet()) {
            if (!e.getValue().isDeleted()) {
                result.add(e.getValue());
            }
        }
        return result;
    }

    /**
     * 估算层级总大小
     *
     * @param level 层级
     * @return 估算字节数
     */
    private long estimateLevelSize(List<SsTable> level) {
        long size = 0;
        for (SsTable table : level) {
            try {
                size += Files.size(table.getFilePath());
            } catch (IOException e) {
                log.warn("获取文件大小失败", e);
            }
        }
        return size;
    }

    @Override
    public void close() throws IOException {
        compactionExecutor.shutdown();
        try {
            if (!compactionExecutor.awaitTermination(5, TimeUnit.SECONDS)) {
                compactionExecutor.shutdownNow();
            }
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
        wal.close();
    }
}
8.7 测试示例
package com.jam.demo.lsm;

import com.jam.demo.lsm.engine.LsmTree;
import lombok.extern.slf4j.Slf4j;

import java.io.IOException;

/**
 * LSM-Tree演示程序
 *
 * @author ken
 */
@Slf4j
public class LsmTreeDemo {

    public static void main(String[] args) throws IOException, InterruptedException {
        String dataPath = "./data/lsm-demo";
        try (LsmTree lsmTree = new LsmTree(dataPath, 1024 * 100, 3)) {
            log.info("开始写入数据...");
            for (int i = 0; i < 5000; i++) {
                String key = "user:" + String.format("%05d", i);
                String value = "{\"id\":" + i + ",\"name\":\"user" + i + "\"}";
                lsmTree.put(key, value);
            }
            log.info("写入完成,开始查询测试...");
            for (int i = 0; i < 10; i++) {
                String key = "user:" + String.format("%05d", i * 500);
                String value = lsmTree.get(key);
                log.info("查询{} = {}", key, value);
            }
            log.info("测试删除...");
            lsmTree.delete("user:00000");
            String deleted = lsmTree.get("user:00000");
            log.info("删除后查询user:00000 = {}", deleted);
            Thread.sleep(3000);
            log.info("Compaction后再次查询...");
            String valueAfter = lsmTree.get("user:02500");
            log.info("user:02500 = {}", valueAfter);
        }
    }
}
该实现完整覆盖了LSM-Tree的核心机制:WAL持久化、MemTable写入、Immutable刷盘、Level 0堆积、多层Compaction归并、墓碑删除等。虽然是简化版本,但核心逻辑与工业级实现完全一致,可作为理解LSM-Tree内部工作原理的参考。
九、MySQL中的LSM:MyRocks实战
MyRocks将RocksDB的LSM-Tree引擎带入MySQL生态,为写入密集型场景提供了比InnoDB更优的选择。
9.1 建表示例
创建使用RocksDB引擎的表,语法与普通MySQL表基本一致,只需指定ENGINE=ROCKSDB:
CREATE TABLE `user_action_log` (
  `id` bigint unsigned NOT NULL AUTO_INCREMENT,
  `user_id` bigint unsigned NOT NULL,
  `action_type` tinyint unsigned NOT NULL,
  `action_time` datetime NOT NULL,
  `biz_id` bigint unsigned NOT NULL,
  `ext_info` json DEFAULT NULL,
  `create_time` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`),
  KEY `idx_user_time` (`user_id`,`action_time`) COMMENT 'cfname=cf_user'
) ENGINE=ROCKSDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin
COMMENT='用户行为日志表';
通过COMMENT中的cfname可以为不同索引指定不同的列族,实现独立的存储配置。例如主键使用默认压缩,日志索引使用更高压缩比的算法。
9.2 列族配置
列族是RocksDB的核心特性之一,允许不同数据使用不同的存储参数:
-- 创建自定义列族
SET GLOBAL rocksdb_default_cf = 'default';

-- 高压缩比列族,适合冷数据
CREATE TABLE `cold_data` (
  `id` bigint NOT NULL,
  `data` mediumtext,
  PRIMARY KEY (`id`) COMMENT 'cfname=cf_cold'
) ENGINE=ROCKSDB;
不同列族可以独立配置压缩算法、块大小、MemTable大小、Compaction策略等,实现冷热数据分层存储。
9.3 与InnoDB性能对比
在写入密集场景下,MyRocks优势明显:
- 写入吞吐量通常是InnoDB的2-5倍
- 存储空间占用约为InnoDB的1/2到1/4
- 随机写入场景下,SSD写入寿命延长数倍
但在纯随机读取场景,InnoDB通常仍有10%-30%的性能优势。因此MyRocks更适合日志、埋点、时序、历史归档等写多读少的业务场景。
9.4 使用注意事项
- 不支持外键与空间索引
- 事务隔离级别最高支持可重复读,不支持串行化
- 范围查询性能优秀,点查询略逊于InnoDB
- 需要关注Compaction对性能的影响,合理配置后台线程数
- 大事务可能导致MemTable过大,刷盘时间变长
十、常见误区与最佳实践
10.1 常见认知误区
误区一:LSM-Tree写入永远比B+树快只有批量写入与随机写入场景下LSM-Tree才有优势。对于少量随机更新,B+树只需一次读-改-写,而LSM-Tree需要写WAL+写MemTable+后续多次Compaction,写放大更高。极端单条更新场景下B+树可能更优。
误区二:Compaction越频繁越好Compaction过于频繁会导致写放大飙升,占用大量I/O与CPU,反而影响前台业务。应当根据业务读写比例与硬件能力,找到合适的Compaction节奏。
误区三:布隆过滤器比特数越多越好布隆过滤器占用内存,过大的过滤器会挤占Block Cache的内存空间,反而可能降低整体性能。通常每键10比特左右是性价比最高的配置。
误区四:层级越多性能越好层级过多会增加读放大与Compaction复杂度。工业实践中7层左右已经可以容纳TB级数据,盲目增加层级没有收益。
10.2 调优最佳实践
写入优化:
- 适当增大MemTable大小,减少刷盘频率
- 配置足够的后台刷盘与Compaction线程
- 写入密集场景选择Universal Compaction
- 开启压缩,用CPU换I/O与空间
读取优化:
- 保证热数据在Block Cache中
- 合理配置布隆过滤器,降低无效I/O
- 读多场景选择Leveled Compaction
- 避免大范围扫描,尽量使用前缀匹配
空间优化:
- 开启数据压缩,冷数据使用高压缩比算法
- 配置合理的Compaction触发阈值
- 定期执行全量Compaction清理过期数据
- 使用TTL自动过期无需保留的数据
稳定性优化:
- 限制单次Compaction的文件大小,避免大归并引发抖动
- 配置Compaction限流,高峰期降低归并速度
- 监控写放大、读放大、SSTable数量等核心指标
- 预留足够的磁盘空间应对Compaction峰值
十一、总结
LSM-Tree之所以能成为现代存储引擎的主流范式,本质是抓住了硬件发展的趋势:磁盘容量越来越大、顺序带宽越来越高,但随机I/O性能提升缓慢。通过将随机写转化为顺序写,LSM-Tree充分释放了磁盘的写入带宽潜力。用可控的读放大与写放大,换取数量级提升的写入吞吐量。理解三大放大的内在关联,掌握Compaction策略的取舍,才能在实际业务中发挥LSM-Tree的最大价值。
