
本文是《AI工程师踩坑实录》系列第 12 篇。loss 一路走高,直觉第一反应是「模型写错了」,然后开始疯狂改网络。这一篇用四组真机对照实验证明,最常见的三个根因全在数据和超参里,模型结构的排位比你想象的靠后得多。
本篇配套的四组对照实验脚本放在公Z号。
loss 越训越高,是所有症状里最容易让人慌的一种。
因为它的直觉解释太吓人了——「模型在学习错误的东西」。于是很多人第一反应是改结构,换激活函数、加层、改初始化,折腾一晚上,loss 还在涨。
这一篇用四组严格对照的实验告诉你,loss 上走的常见根因里,模型结构排最后。前面三个,一个在学习率,两个在数据。
一、实验设计,四个变量全控制
同一个网络(四层全连接),同一份 XOR 任务数据(非线性任务,模型必须真正学习才能降 loss),同一套训练循环。四组之间只改一个变量。
第一组正常基线,Adam 学习率 0.001。第二组学习率改成 0.5。第三组把 30% 训练标签翻转(模拟脏数据)。第四组特征整体乘 300 不做缩放(模拟量纲失控)。
先看四条真实训练曲线。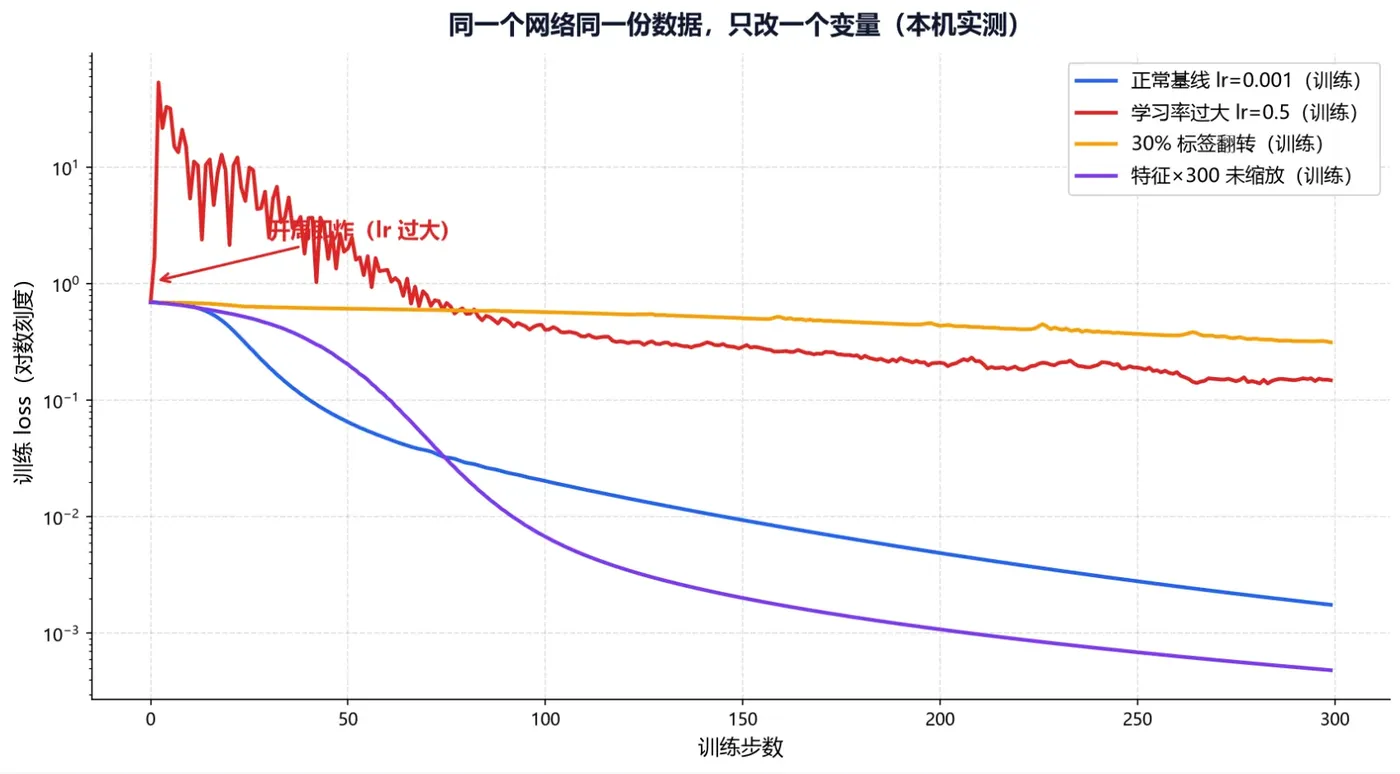
逐组拆。
二、根因一,学习率过大,开局即炸
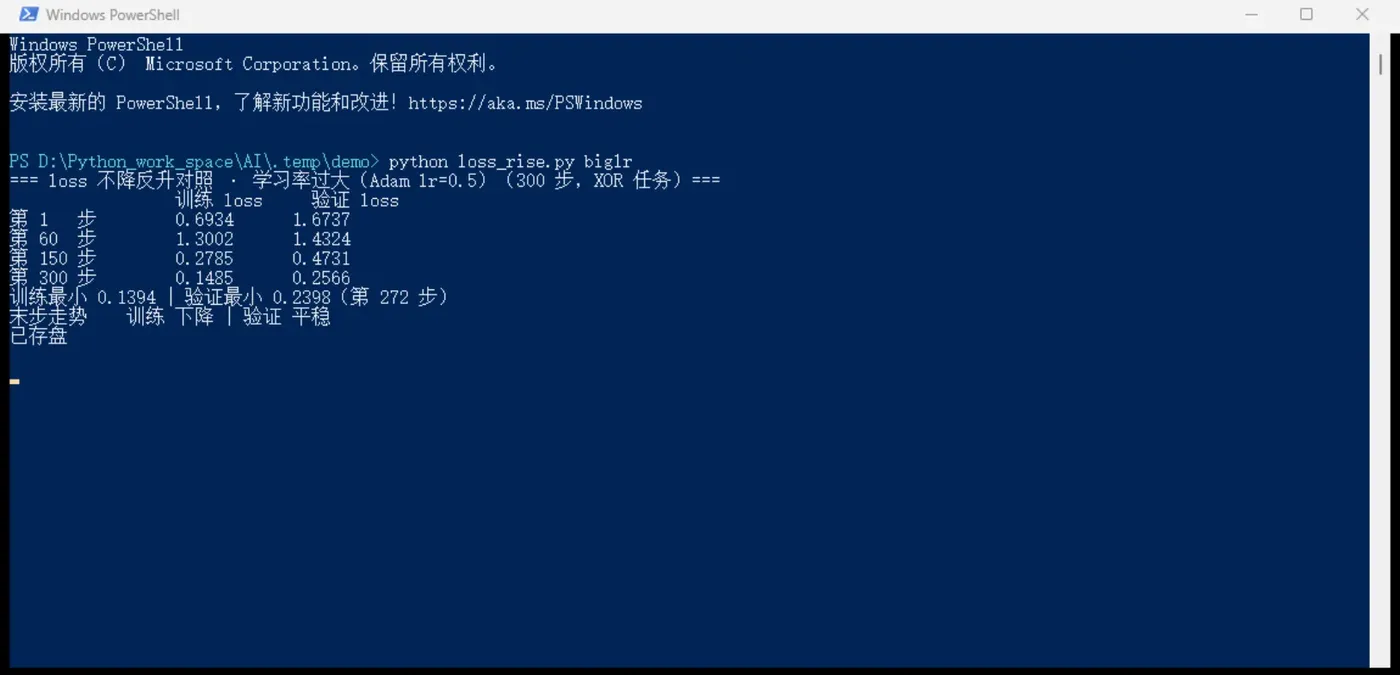
看数字。第 1 步训练 loss 0.69(正常起点),第 1 步的验证 loss 直接 1.67,第 60 步训练 loss 涨到 1.30。开局三步之内,loss 就在往上走。
这是学习率过大的指纹特征,出问题极早。原理第 4 篇讲过,步长超过当前地形的曲率半径,优化在谷底两侧来回弹射,越弹越高。这个组后来又降下来了,是因为 Adam 的自适应机制把它拉了回来,SGD 的话大概率直接发散。
识别要点,上升发生在前几十步,且震荡剧烈。看到这个形态,先降十倍学习率再说话。
三、根因二,脏数据,训练降验证升的 V 形反转
这个最阴险,因为训练 loss 看着完全正常。
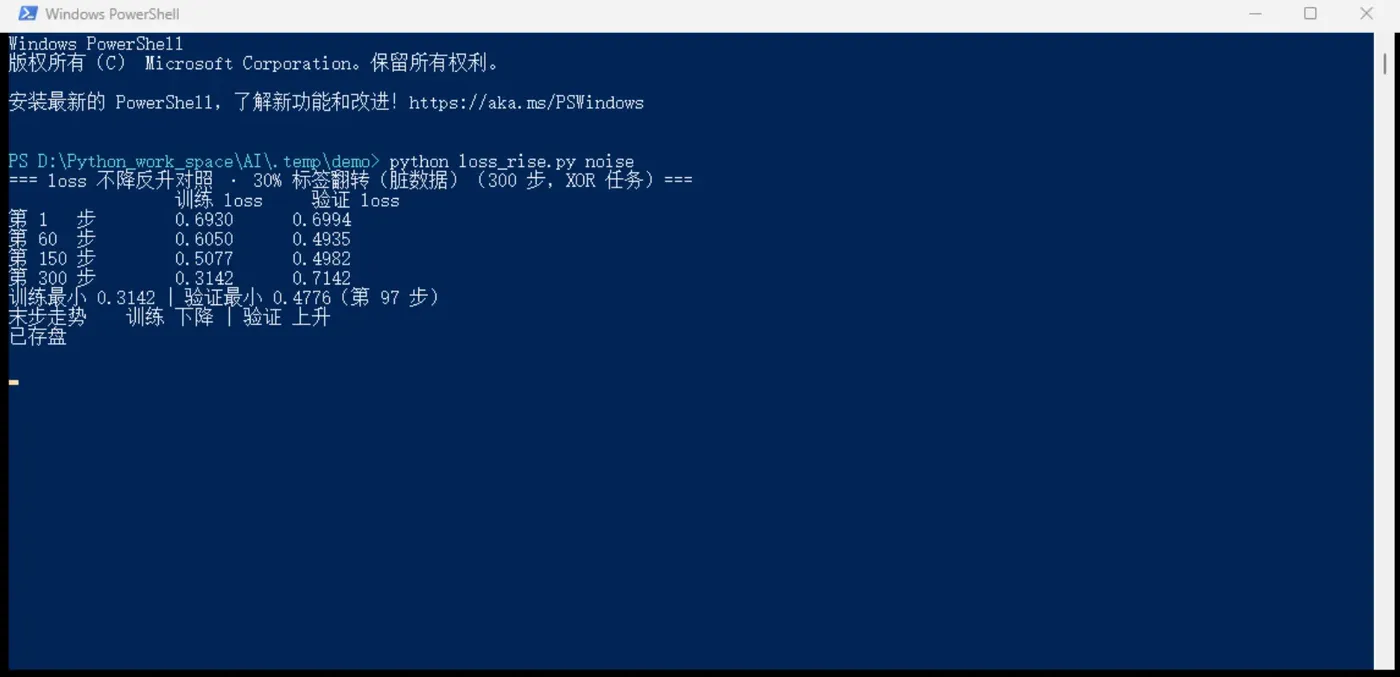
训练 loss 一路降到 0.314,健康得不能再健康。但看验证列,第 97 步触底 0.478 之后掉头向上,第 300 步 0.714,比起点还高。
把两条曲线画在一起,V 形反转一目了然。
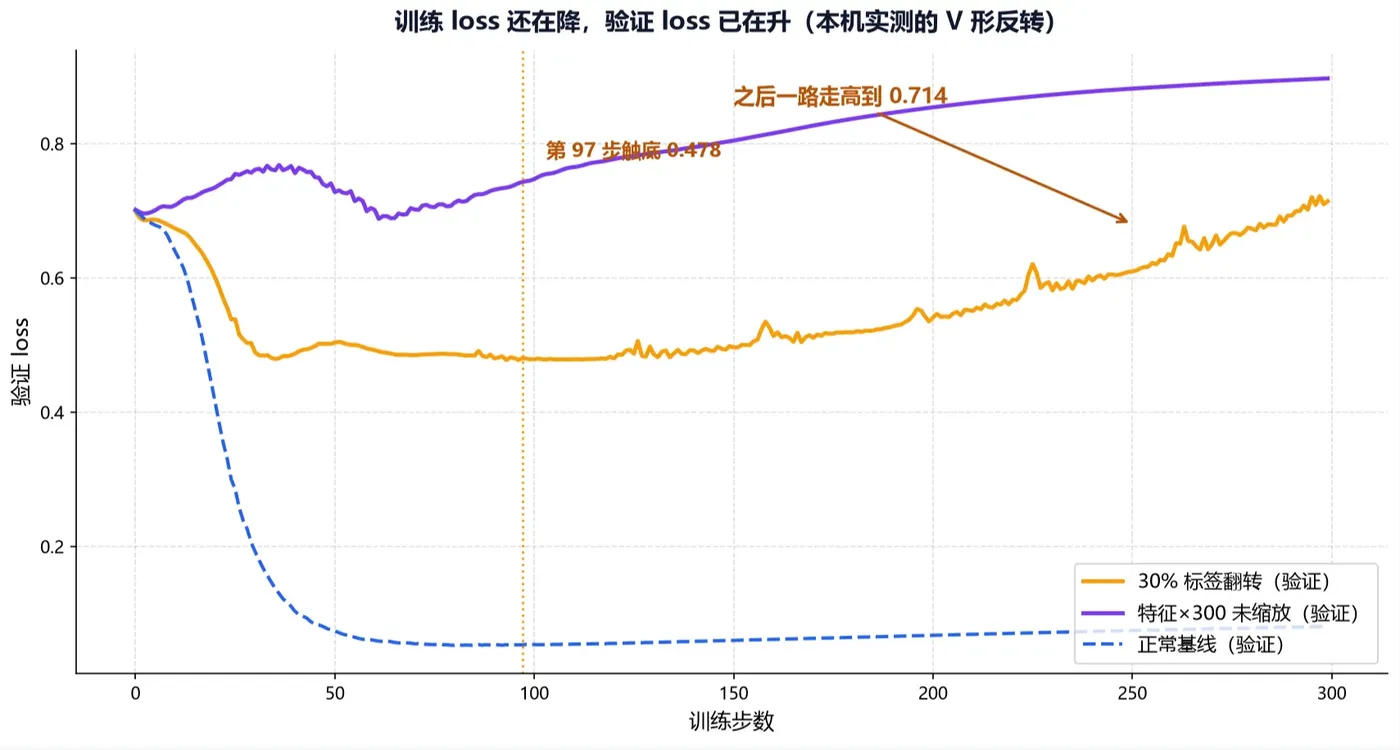
这不是模型坏了,是模型在认真执行你的指令——把那 30% 的错误标签也背下来(第 3 篇讲过它背得多起劲)。训练 loss 降,是因为它在记忆噪声;验证 loss 升,是因为噪声记忆对新数据毫无用处,反而挤占了真规律的空间。
识别要点,训练还在降、验证掉头升,两条曲线剪刀差张开。看到这个形态别动模型,去查数据。
四、根因三,量纲失控,全程高位卡死
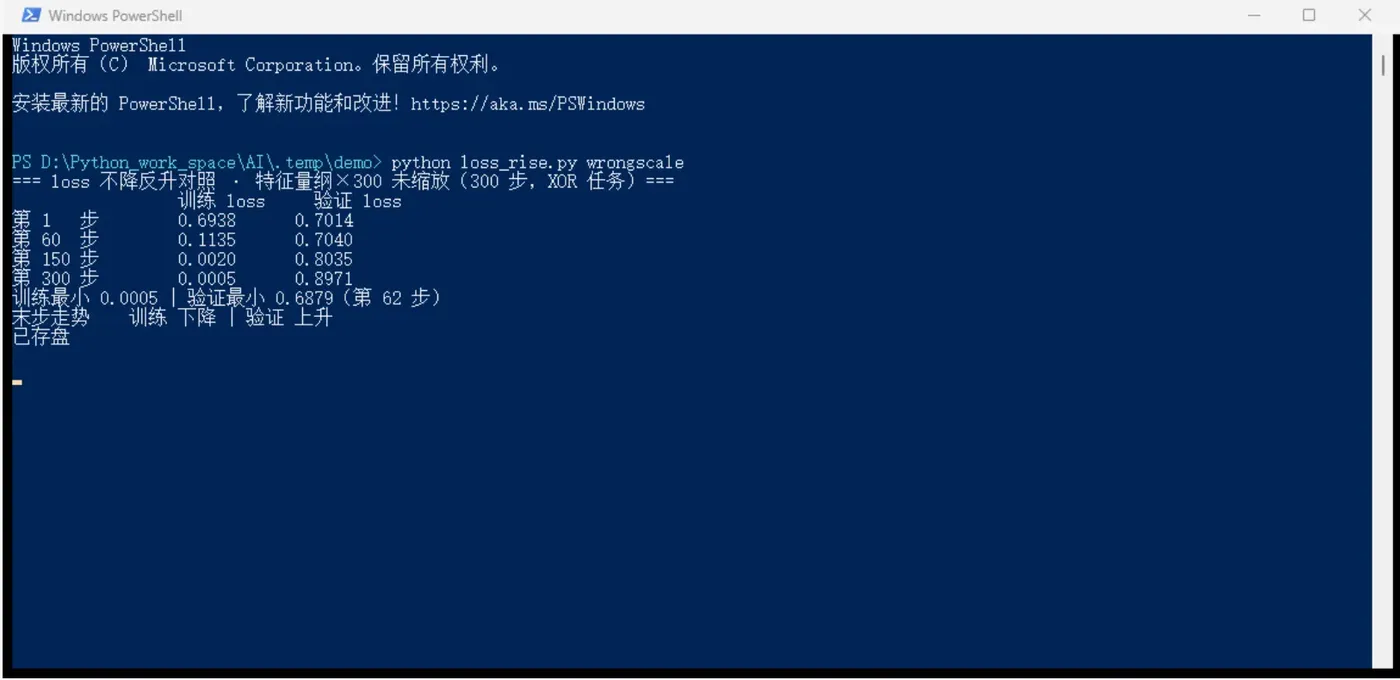
特征乘 300 之后,训练 loss 也能降到 0.0005,验证 loss 却从 0.688 一路爬到 0.897。跟标签翻转类似的剪刀差,但病根完全不同——梯度量级被特征量纲放大了几百倍,同一套学习率从「合适」变成「失控」,优化在错误的尺度上狂奔。
这一类的现实版本更常见也更隐蔽。特征一列是 0 到 1 的归一化值,另一列是 0 到 10000 的金额,忘了统一缩放,损失曲面的形状就毁了。
识别要点,loss 下降速度异常快或异常慢,且验证早早进入上升通道。查各列的 std 和 mean,一分钟的事。
五、排查顺序,把直觉倒过来
三组实验摆完,正确的排查顺序就浮出来了。
第一步,看上升发生的时间。前几十步就涨,学习率问题,降十倍再跑。中后期才开始涨,往数据方向查。
第二步,看训练和验证的分叉。训练也涨,优化问题(学习率、初始化、损失函数)。只有验证涨,数据问题(标签噪声、量纲、泄漏)。
第三步,才是模型结构。容量不足一般表现为「降得慢但稳定」,而不是「升上去」。结构导致 loss 上走的场景真实存在(梯度消失、退化),但概率上排最后。
把这三步走完,80% 的 loss 上升案例不用碰模型就解决了。
六、常见问题 3 连
1. 训练 loss 和验证 loss 同时上升呢?
优先查学习率和数据量纲,这是优化层面的全面失控。同时看一下 batch 里有没有异常样本(单个 inf 输入就能把整步带飞,配合第 4 篇的 hook 定位法)。
2. loss 突然跳一下然后继续降,要管吗?
不用。单个尖峰多半是个难样本或大梯度 batch,优化自己消化了。要警惕的是「持续上升」和「高频震荡不回落」,那是系统性的信号。
3. 上面这些实验我自己怎么跑?
资源包里的脚本一条命令一组,参数都在 argparse 里,把你的数据塞进去替换 XOR 就能复现同样形态。关键是先在你自己的数据上跑一组「正常基线」,有基线才谈得上对比。
七、本篇小结
- loss 不降反升,最常见的根因是学习率过大(开局即炸)和数据问题(V 形反转),模型结构排最后。
- 判断看两个维度——上升发生的时间(早=优化问题),训练验证是否分叉(分叉=数据问题)。
- 训练降验证升的剪刀差,是脏数据和量纲失控的共同指纹,去查数据别动模型。
本篇坑卡片
| 字段 | 内容 |
|---|---|
| 坑名 | loss 不降反升时优先改模型结构,方向性错误 |
| 现象原文 | 学习率过大组第 1 步验证 1.67、60 步训练 1.30;标签翻转组验证 97 步 0.478 触底后升至 0.714 |
| 环境 | Win11 + CPU,torch 2.9.1+cu126,XOR 任务四层网络 |
| 复现步骤 | 四组对照各只改一个变量(lr 0.5 / 30% 标签翻转 / 特征×300)对比基线 |
| 根因 | 优化步长越界(lr)或数据分布损坏(噪声/量纲),模型结构极少是主因 |
| 解法 | 先看上升时间再看曲线分叉:早升查学习率,验证单独升查数据,结构放最后 |
| 避坑建议 | 每个新任务先跑正常基线建立参照系;改任何东西一次只改一个变量 |
| 可信度 | 本机验证 |
| 版本时间戳 | 2026-11-06,torch 2.9.1+cu126 |
| 关联坑 | 第 3 篇标签错位、第 7 篇数据泄漏(同为数据侧根因) |
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | nvidia-smi 显示的 CUDA 版本到底是不是你装的那个 | 已发 |
| 2 | torch.cuda.is_available() 一直是 False,一条命令定位断点 | 已发 |
| 3 | 标签和图像没对齐,模型一直在学噪声 | 已发 |
| 4 | loss 变 NaN,用 hook 逐层定位 | 已发 |
| 5 | DataLoader 卡死在第一个 batch,Windows 多进程的坑 | 已发 |
| 6 | 装了两套 CUDA 还在串,PATH 与优先级的真相 | 已发 |
| 7 | 数据泄漏:预处理做在了划分之前 | 已发 |
| 8 | RAG 答一半开始编,检索阈值与拒答机制实操 | 已发 |
| 9 | 随机种子都设了,结果还是不可复现 | 已发 |
| 10 | 相似度全是 0.9:向量没归一化 | 已发 |
| 11 | 开了混合精度就 NaN,GradScaler 到底在做什么 | 已发 |
| 12 | loss 不降反升,先别怀疑模型结构 | 已发(本篇) |
| 13 | 训练降验证不降:先查数据再谈正则 | 排期中 |
下一篇预告,《训练降验证不降:先查数据再谈正则》。曲线很漂亮,验证指标纹丝不动,第一反应是加正则,结果越加越差。下一篇给一个明确的判断顺序。
版权说明,本文实验数据与曲线均来自本人真机复现,专栏读者可学习使用,禁止转售或整篇搬运。
