
机器开通完,控制台里多了一个公网 IP,SSH 能连上,然后就没有然后了。这是我见过最多的第一台服务器的结局:装个面板,看两天,吃灰半年。倒不是人懒,是"买了能干什么"这个问题太大,大到不知道从哪下手,最后干脆从哪都没下手。
这篇不装面板,也不建站。我只做一件事:把一台刚开通的空机器,整理成"能长期、稳定跑一个小服务,出事自己能修"的状态。做完这七步,你再回头看那张能力清单——开发机、常驻服务、定时任务、测试环境、数据中转、私有工具——会发现它们全都不难,难的是底座一直没搭好。
顺带说清楚一个取舍:为什么第一步不是装环境。因为环境装得再快,登录方式没收口、安全组全放开、服务没托管、日志没轮转、快照没验过回滚,这台机器就只是"能跑",不是"能长期跑"。前三步都在做看起来没有产出的杂活,但它们决定了半年后你会不会在半夜被叫起来。规格、镜像和付费方式按自己场景挑,具体配置与价格以官方页面实时展示为准,别照抄任何一份配置单。
第一步:把登录方式收口
创建实例时如果用了密码,第一件事就是换成密钥,并建一个非 root 的运维账号:
adduser ops && usermod -aG sudo ops
mkdir -p /home/ops/.ssh
cp ~/.ssh/authorized_keys /home/ops/.ssh/
chown -R ops:ops /home/ops/.ssh && chmod 700 /home/ops/.ssh
chmod 600 /home/ops/.ssh/authorized_keys
新开一个终端窗口,用新账号登录成功了,再回来关密码登录:
sudo sed -i 's/^#*PasswordLogin.*/PasswordLogin no/' /etc/ssh/sshd_config
sudo systemctl reload sshd
一定要先开着旧窗口。 我见过一次改完直接断开、密钥又没配好,只能去控制台用 VNC 救回来。这一步的价值不在安全口号,在于把"谁能进这台机器"变成一件可核对的事:密钥文件在哪、几个人有、什么时候加的,一眼能查。
第二步:把系统基线抹平
sudo timedatectl set-timezone Asia/Shanghai
sudo apt update && sudo apt -y upgrade
sudo apt -y install curl vim htop unzip jq
时区这行别省。默认是 UTC,日志、定时任务、证书校验全差八小时,排查时最容易被带偏。再给小内存机器加一层 swap,避免编译或批量任务时进程被直接杀掉:
sudo fallocate -l 2G /swapfile && sudo chmod 600 /swapfile
sudo mkswap /swapfile && sudo swapon /swapfile
echo '/swapfile none swap sw 0 0' | sudo tee -a /etc/fstab
这几步做完,机器才算"干净"。后面装什么都不会因为字符集、时区、缺工具这类低级问题卡住。
第三步:安全组最小化,并且分清两层门
控制台里默认只放行 22,业务端口要自己加。按"用得到才开"的原则加,源 IP 能收窄就收窄:
- 22 / tcp:源填自己的公网 IP 段,别长期写全放开
- 业务端口:只开真正要对外提供服务的那个
- 不需要对外的端口:一律不给公网规则
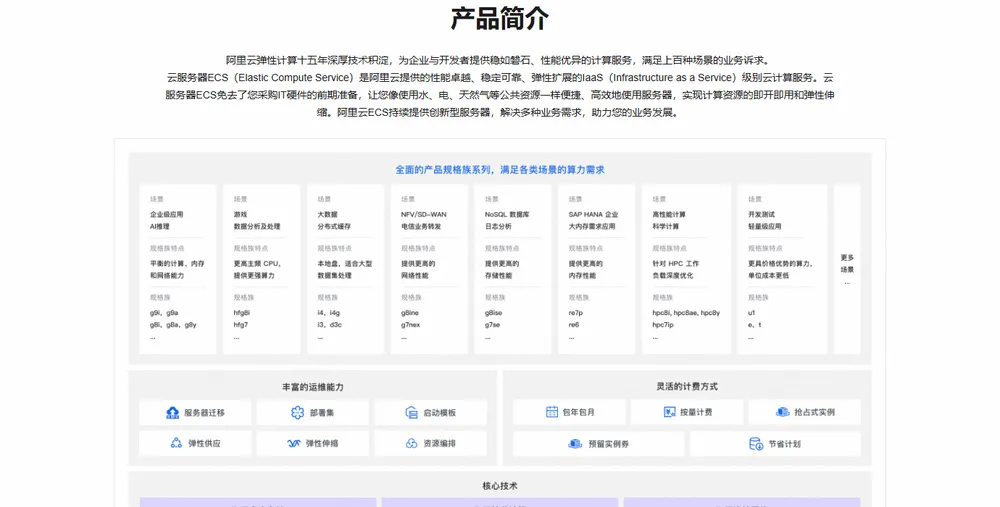
这里有个特别容易混的点:安全组和系统防火墙是两层门。安全组在实例外面拦,iptables/ufw 在实例里面拦。安全组开了 8080 但服务只监听 127.0.0.1,外面照样连不上;反过来服务监听全网卡、安全组没开,也照样进不来。排查"连不上"时先分清是哪一层,比反复重启服务有用得多。买机器和调安全组都在 云服务器 ECS 的实例页里完成,地域、镜像、实例族按用途选,别一上来就照着别人的规格单买。
第四步:选一件最小的事,真正做通
能力清单再长,也要落到一件具体的事上。我选的是"跑一个能返回健康状态的小服务",因为它足够小,能把托管、自愈、日志三件事一次验完。
先写个最小脚本(示例用 Python 自带库,不装任何框架):
# /opt/health/app.py
from http.server import BaseHTTPRequestHandler, HTTPServer
class H(BaseHTTPRequestHandler):
    def do_GET(self):
        self.send_response(200)
        self.end_headers()
        self.wfile.write(b"ok")
HTTPServer(("127.0.0.1", 8080), H).serve_forever()
关键是别让它靠"我手动开着一个终端"活着,交给 systemd:
# /etc/systemd/system/health.service
[Unit]
Description=min health service
After=network.target

[Service]
User=ops
WorkingDirectory=/opt/health
ExecStart=/usr/bin/python3 /opt/health/app.py
Restart=always
RestartSec=3

[Install]
WantedBy=multi-user.target
sudo systemctl daemon-reload
sudo systemctl enable --now health.service
systemctl status health.service --no-pager
curl -sS 127.0.0.1:8080
Restart=always 和 enable 是这一步的验收点:进程被 kill 掉会自己回来,重启机器也会自己起来。手动跑通不算做完,交给系统托管才算。
第五步:日志能查、不会撑爆
journalctl -u health.service -n 50 --no-pager
journalctl -u health.service --since "1 hour ago" --no-pager
确认 journald 的留存策略,再给自己的业务日志配 logrotate。小机器最常出的怪事不是服务崩,是磁盘被日志写满,然后数据库、上传、SSH 全部一起异常。留一条磁盘水位的检查命令,写进日常巡检:
df -h
du -sh /var/log/journal
第六步:让机器自己会报信
云监控里把 CPU、内存、磁盘、公网出带宽的基础指标打开,设一条磁盘水位告警。自己这边再补一条最朴素的服务探活,用系统定时任务每五分钟打一次本地端口,失败就记一条日志:
*/5 * * * * curl -fsS 127.0.0.1:8080 >/dev/null || logger -t health-check "health down"
真实取舍在这里:很多人第一反应是接一套完整的监控平台,结果光配告警规则就花掉一晚上。先把"服务挂了我能知道"这一条打通,比铺一套自己也看不懂的看板实在。
第七步:打第一个快照,并且真的回滚一次
云盘快照是变更前后的后悔药,但没验过回滚的快照不算备份。做法很土:改一个配置文件,打快照,把配置改坏,用快照恢复,确认文件回来了。整个过程十分钟,换来的是你确信这条路走得通。
还要分清快照和备份的边界:快照跟云盘在同一个账号、同一个地域,适合"改崩了回滚";真遇到误删、勒索或者地域级故障,需要的是独立备份库里的副本。这层先记住结论,等站点真有数据了再补,别在第一周就把两套都堆上去。
验收:七条自己能验的结果
- 新终端用 ops 账号 + 密钥能登录,密码登录已关
timedatectl显示本地时区,日志时间戳和现实对得上- 安全组里没有一条"全端口 + 全来源"的规则
kill掉服务进程后,三秒内systemctl把它拉回来- 重启实例后,不用登录任何终端,本地端口就有响应
journalctl -u health.service能查到最近一小时记录,磁盘水位有告警- 快照回滚演练做过一次,且能说清快照和备份各管什么
七条全过,这台空机器就从"能连上"变成"能长期干活"了。
回头看那张能力清单
底座就绪之后,前面那些"能干什么"才真正成立:当开发机,是密钥 + 安全组已经收口;挂常驻服务,是 systemd 已经托管;跑定时任务,是时区和日志已经对齐;做测试环境,是快照能随时回滚;当数据中转,是磁盘有水位告警。它们不是五种不同的机器,是同一个底座上的五种用法。
反过来也成立:底座没搭好,装再多东西都只是在给未来攒故障。第一台服务器最值得花的不是选哪个面板,而是这七步里那些看起来没有产出的杂活。
规格怎么选、按量还是包年、镜像用公共还是自定义,这些按自己的用途定,具体配置与价格以官方页面实时展示为准,活动变动比一篇文章快。机器本身就是 云服务器 ECS,从实例页进去按用途挑即可,先起步、跑不动再单独调计算、存储和带宽,比一步买到位省心。
