
摘要:面向 Java、大数据与 AI 工程师,系统梳理 Hive 的数据库级 DDL:从 DATABASE 在 Hive 中的真实身份(命名空间 + Metastore 元数据 + HDFS 目录),到 CREATE / USE / SHOW / DESCRIBE / ALTER / DROP 的完整语法与参数,再到 LOCATION、DBPROPERTIES、CASCADE 等高频踩坑点。配一张"DDL 在系统里如何落地"的关系图,帮你把建库这件事一次做对。
关键词:Hive DDL, CREATE DATABASE, ALTER DATABASE, DROP DATABASE, DBPROPERTIES, LOCATION, CASCADE, Metastore, HDFS, 数据仓库
很多同学 Hive 用了两三年,建库还是 create database xxx; 一把梭。等到要做多租户隔离、指定存储位置,或者清理一个"看起来空"的库时,才发现 LOCATION、DBPROPERTIES、CASCADE 这些参数一个都没碰过,踩了一身坑。
数据库(Database,Hive 0.14 起也可写作 SCHEMA)是 Hive 里最容易被轻视、却最该先规划好的对象。这篇把它讲透。
先放一张图,看清一条建库命令在 Hive 里到底落到了哪里。
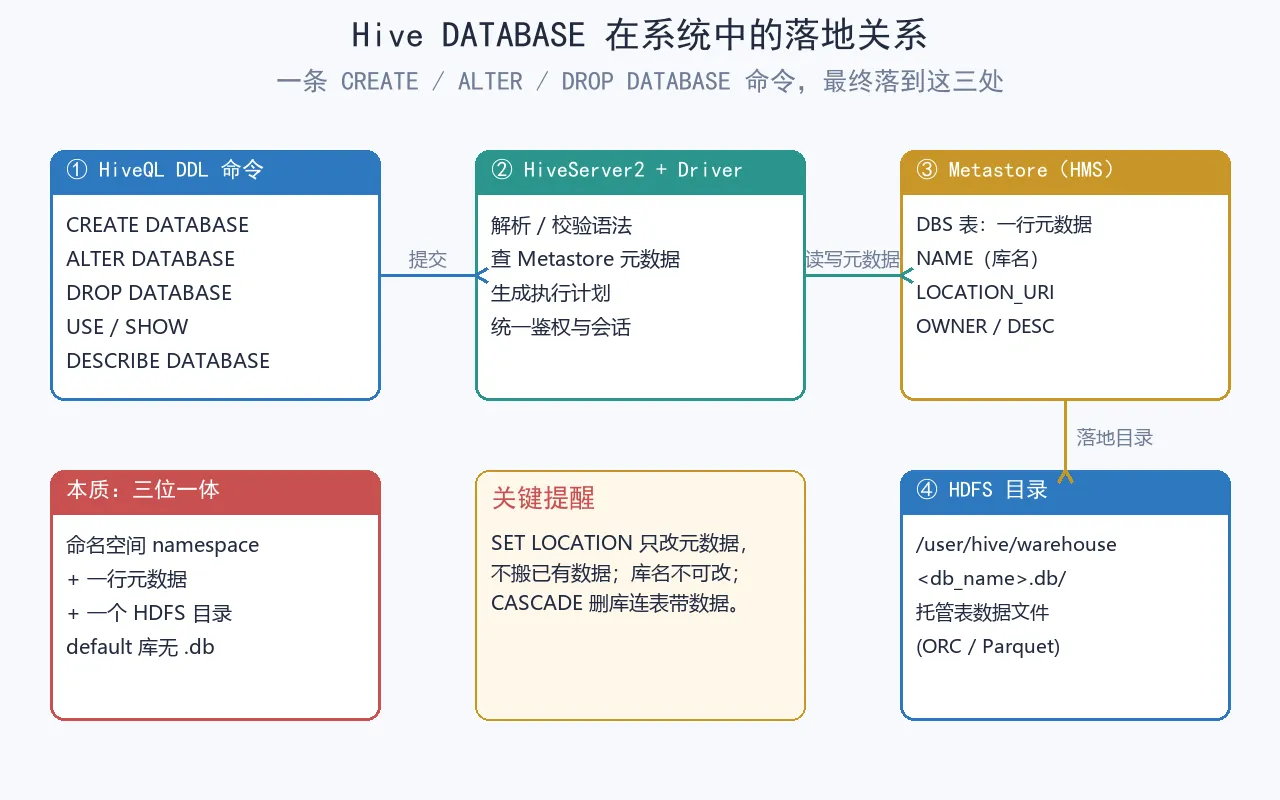
一、先搞懂:Hive 里的 DATABASE 到底是什么
它不是存储引擎,也不是一张表,而是一个命名空间(namespace)。一条 CREATE DATABASE 在系统里实际落地成三样东西:
- Metastore 里的一行元数据:记录在
DBS表中(DB_ID、NAME、DB_LOCATION_URI、OWNER_NAME、OWNER_TYPE、DESC、CTL_NAME 等)。这是 Hive"认识"这个库的唯一依据。 - HDFS 上的一个目录:默认在
hive.metastore.warehouse.dir(一般是/user/hive/warehouse)下面,建成<db_name>.db的文件夹。该库下所有托管表(managed table)的数据,默认都躺在里面。 - 一组表的容器:库只是给表分组的逻辑边界,真正的表、分区、数据文件都在它之下。
有一个特例是 default 库:它的表直接落在 warehouse 根目录,没有 .db 后缀。所以别把所有临时表、测试表都堆进 default——既不便于权限管控,也不利于数据治理。
二、CREATE DATABASE:参数一个都别漏
完整语法:
CREATE (DATABASE|SCHEMA) [IF NOT EXISTS] database_name
  [COMMENT 'database comment']
  [LOCATION hdfs_path]
  [WITH DBPROPERTIES (property_name=property_value, ...)];
逐个说清:
- IF NOT EXISTS:库已存在时不报错(否则会抛
AlreadyExistsException)。生产脚本建议都带上。 - COMMENT:库的说明,纯属人读,存在 Metastore 里。
- LOCATION:指定库对应的 HDFS 目录,覆盖默认
<db>.db位置。注意两件事:一是路径要可创建;二是它只决定"新表默认放哪",不负责搬迁已有数据(见第四节)。 - WITH DBPROPERTIES:键值对,用来存治理信息,比如负责人、创建日期、SLA 等级。它和 COMMENT 不同——COMMENT 是单行说明,DBPROPERTIES 是结构化字典,且能被
ALTER动态修改。
来个实战例子,把四个参数一次用上:
CREATE DATABASE IF NOT EXISTS dwd_sales
  COMMENT '销售域明细层,按日分区'
  LOCATION '/data/hive/dwd_sales.db'
  WITH DBPROPERTIES (
    'owner'   = 'data-eng-team',
    'sla'     = 'T+1',
    'created' = '2026-10-31'
  );
三、查看与切换:USE、SHOW、DESCRIBE
建完要会看、会进:
-- 切换当前库(后续建表不写库名时,落到这里)
USE dwd_sales;

-- 列出所有库,支持 LIKE 模糊匹配
SHOW DATABASES;
SHOW DATABASES LIKE 'dwd_*';

-- 查看库的基本信息
DESCRIBE DATABASE dwd_sales;

-- EXTENDED:把 DBPROPERTIES 也打印出来
DESCRIBE DATABASE EXTENDED dwd_sales;
DESCRIBE DATABASE EXTENDED 会列出 db_location、owner,以及你在 WITH DBPROPERTIES 里塞进去的全部键值对——做数据资产盘点时非常有用。
四、ALTER DATABASE:能改的有限,且都有坑
很多人以为库建完还能随便改,其实 Hive 对库的元数据约束得很死。库名(NAME)一旦确定就改不了,能动的只有下面几项:
-- 1) 修改 DBPROPERTIES(Hive 0.14+,SCHEMA 同义)
ALTER DATABASE dwd_sales
  SET DBPROPERTIES ('sla' = 'T+0', 'owner' = 'new-team');

-- 2) 修改属主(Hive 0.13+),配合 Ranger/Sentry 做权限治理
ALTER DATABASE dwd_sales SET OWNER USER alice;

-- 3) 修改默认位置 / 托管位置
ALTER DATABASE dwd_sales SET LOCATION '/data/hive/dwd_sales_v2.db';
ALTER DATABASE dwd_sales SET MANAGEDLOCATION '/data/hive/managed/dwd_sales';  -- Hive 4.0+
三个重点提醒:
- SET LOCATION 改的是元数据,不搬数据。 它只影响"之后新建的表"默认落在哪;库里已经存在的表,数据还在老目录,不会自动迁移。想搬数据得手动
ALTER TABLE ... SET LOCATION逐个改。 - MANAGEDLOCATION 是 Hive 4.0 才有的,专门区分"托管表根目录"和"外部表位置",便于把托管数据统一收口到独立存储池。
- 改完用
DESCRIBE DATABASE EXTENDED复核,别凭感觉。
五、DROP DATABASE:RESTRICT 与 CASCADE 一字之差
删库语法:
DROP (DATABASE|SCHEMA) [IF EXISTS] database_name [RESTRICT|CASCADE];
- 默认是 RESTRICT:库里只要有表,删除直接报错
Database xxx is not empty。这是安全兜底,防止误删。 - CASCADE:连库带表一起删,且托管表的数据也会从 HDFS 上抹掉。这一下下去,数据可能就真没了。
- IF EXISTS:库不存在也不报错,脚本更稳。
-- 安全做法:先确认库是空的(SHOW TABLES),再删
DROP DATABASE IF EXISTS dwd_sales;          -- 非空会报错,安全
DROP DATABASE IF EXISTS dwd_sales CASCADE;  -- 连表带数据全删,慎用!
生产环境的铁律:永远先 SHOW TABLES 清点,再决定要不要 CASCADE。 删托管表的数据不可恢复,没有回收站兜底。
六、五个最佳实践,把建库一次做对
- 命名带上业务域和环境:
dwd_sales、ods_log、ads_finance_prod,一眼能分清层级和用途,权限策略也好挂。 - LOCATION 提前规划:别都用默认 warehouse。跨集群迁移、冷热分层、不同存储策略,都在目录层面先分好。
- 用 DBPROPERTIES 沉淀治理信息:owner、SLA、负责人、资产等级,比散落在 Wiki 里强得多。
- 生产拒绝 CASCADE:删库前先
SHOW TABLES或走审批;托管表数据无回收站。 - 别把表全堆进 default:default 库没有
.db目录,权限和治理都难做,专库专用。
七、一句话总结
Hive 的 DATABASE,本质是"命名空间 + Metastore 一行元数据 + HDFS 一个目录"的三位一体。建库时把 LOCATION、DBPROPERTIES 规划好,ALTER 里只动属主和属性、SET LOCATION 不搬数据要牢记,DROP 时 RESTRICT 保命、CASCADE 慎之又慎——把这几条吃透,Hive 数据治理的第一道关就守住了。
