很多团队的漏洞管理流程是:跑一次扫描器 → 拿到一份报告 → 按 CVE 编号打补丁。实际跑下来会发现两个问题:扫描器报了一堆,分不清哪些真能利用;真正高危的业务逻辑漏洞,扫描器一个都没报出来。
这篇总结按实际流程来:先讲怎么组织扫描,再讲怎么快速识别高危,最后讲批量处置和闭环。扫描器只是工具,判断和闭环才是流程的主体。
扫描前的准备
1.资产清单先行
没有资产清单的扫描是盲扫。先把要扫的对象列清楚:
- 主机:云主机、物理机、操作系统版本、是否公网暴露
- 中间件:Nginx、Apache、Tomcat、Weblogic、Redis、MySQL、MongoDB
- 框架与组件:Spring、Shiro、Fastjson、Log4j、ThinkPHP 等
- 业务系统:官网、小程序后端、API、后台管理系统
- 测试环境:经常被忽略,但测试环境漏洞同样能成为入侵跳板
每个资产标注业务归属、重要程度、是否允许停机。重要程度决定后面的修复优先级。
2.授权与扫描策略
扫描必须有书面授权,未授权扫描属于违规行为。策略上注意:
- 生产环境用低强度模式,避免扫描流量打满业务
- 避开业务高峰,核心系统安排在维护窗口
- 先扫测试环境,确认扫描规则不会触发异常,再上生产
- 数据库、中间件的弱口令扫描单独评估,避免触发账号锁定
3.工具选择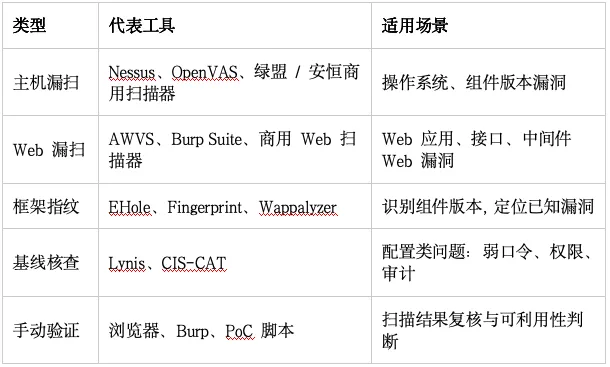
商用扫描器在规则覆盖和报告合规性上有优势;开源工具适合内网批量摸底。实际组合用:扫描器出初筛,人工复核高危项。
高危漏洞的快速识别方法
扫描报告动辄几百条,逐条看不现实。快速识别靠三个维度交叉判断。
1.看可利用性,不只看 CVSS 分数
CVSS 是理论分值,实际风险要结合四个条件:
实际风险 = 漏洞等级 × 资产重要性 × 是否暴露公网 × 是否有公开 EXP/在野利用
同一个 CVE:
- 公网暴露、有公开 EXP、影响核心业务 → 危急,24 小时内处置
- 内网隔离、无利用条件、无 EXP → 低危,纳入季度巡检
有在野利用记录的漏洞优先级最高。不管 CVSS 多少分,正在被大规模利用的漏洞必须先处理。
2.按漏洞类型快速分流
扫描结果先按类型归堆,同类问题一起处置,效率比逐条处理高得多。
远程代码执行(RCE)类:Spring 系列、Shiro 反序列化、Fastjson 反序列化、Log4j、ThinkPHP RCE。这类直接拿服务器权限,优先级最高。
注入类:SQL 注入、命令注入、XXE。能拖库或执行命令,公网接口上的注入基本按高危处理。
文件上传/包含:上传 Webshell、任意文件读取、路径遍历。直接威胁服务器文件系统。
认证与会话类:弱口令、未授权访问、越权、JWT 配置缺陷。这类扫描器容易漏,要人工补。
信息泄露类:源码泄露、备份文件、接口未鉴权、敏感目录暴露。单独看危害有限,但常作为入侵前置步骤。
配置类:端口暴露、匿名访问、默认账号、审计日志关闭。基线核查工具覆盖。
3.快速复核:哪些报告项可以先跳过
扫描器误报不少,复核时先排除几类:
- 版本号误识别:指纹识别错了,报的漏洞根本不适用。先核对真实版本。
- 无利用条件:漏洞需要特定前置条件(内网、特定配置、特定参数),当前环境不满足。
- 已被缓解:WAF 规则、访问控制已经把利用路径堵住。
- 理论风险:需要本地权限、物理接触,远程无法利用。
复核结论要记录原因,不能直接删掉。下次扫描还会报,留档才能避免反复讨论。
批量扫描的实操流程
1.指纹识别先于漏洞扫描
先批量跑指纹,确认每台资产跑的是什么版本,再针对性匹配漏洞库。直接全量扫,既慢又容易误报。
指纹信息结合响应头、Cookie 名、页面特征、静态资源路径综合判断。
2.主机批量扫描
主机扫描覆盖操作系统补丁、系统服务、数据库、中间件。重点关注:
- 内核漏洞、系统补丁缺失
- 开放端口与对应服务版本
- 数据库/中间件默认账号、弱口令
- 不必要的服务和组件
扫描结果按资产分组,同一台机器的问题集中处置,避免一台机器改一次重启一次。
3.Web 与接口扫描
Web 扫描覆盖:
- 注入、XSS、文件上传、路径遍历
- 后台路径、默认页面、示例程序
- 接口未鉴权、参数遍历
- 框架已知漏洞
接口扫描要配合抓包:把登录后的请求导出,带上 Cookie 和 Token 再扫,否则扫不到鉴权后的接口。
4.内网横向视角
公网入口扫完,还要看内网暴露面:
- 数据库、缓存、消息队列是否对公网开放
- 测试环境是否能从公网访问
- 跨网段访问控制是否到位
- 跳板机、堡垒机配置是否合规
很多入侵路径是:公网一个低危入口 → 内网一台机器 → 横向到核心数据库。只扫公网会漏掉这条链。
高危漏洞的验证要点
扫描器说"存在漏洞"不等于"漏洞可被利用"。高危项在修复前要做一次可利用性验证,验证只在授权范围内进行。
1.RCE 类验证
确认漏洞能否真正执行命令,而不只是参数被传入。验证时用无害命令(如 id、whoami、hostname),不要写文件、不要下载工具。
2.注入类验证
确认注入点位置、注入类型(数字型/字符型/报错/盲注)、当前数据库权限。盲注验证耗时较长,先判断是否有更直接的修复路径。
3.未授权访问验证
直接不带凭证访问接口,看返回数据是否包含敏感信息。注意区分"公开接口"和"未授权接口"——商品详情本来就公开,不算漏洞。
4.验证记录
每个高危项记录:漏洞位置、验证方式、验证结果、影响范围、利用条件。这份记录既是修复依据,也是等保和审计的材料。
按场景批量处置
1.补丁修复
业务允许重启、官方补丁稳定,优先打补丁。流程:测试环境验证 → 备份快照 → 分批上生产 → 复测。
老系统兼容性差的,补丁先在测试机跑通,不要直接上生产。
2.配置修复
不需要重启、改配置就能缓解的,优先用配置手段:关闭服务、限制访问来源、禁用危险功能、收紧权限。
3.虚拟补丁
核心业务不能停机、无法打补丁,先在 WAF 或主机规则层封堵利用路径,作为临时缓解。挂到期时间,同步开发排期正式修复。
4.风险接受
内网隔离、无利用条件、无 EXP 的漏洞,提交审批后接受风险,留档说明。不能私自忽略。
5.修复优先级排期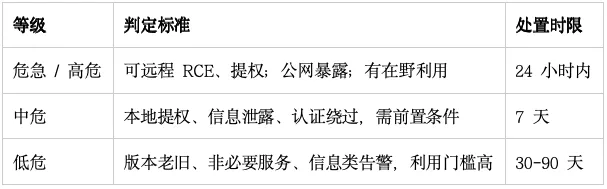
修复完成必须复测,不能凭主观判断"应该好了"。
- 定向扫描:针对本次 CVE 单独验证
- 版本核查:
rpm -qa、包管理器、服务版本号确认已升级 - 配置核查:SSH 策略、防火墙、账号策略人工抽查
- 业务回归:确认网站、数据库、接口功能正常
- 结果判定:漏洞消失标记完成;仍存在回滚或换方案;误报备注原因更新白名单
复测容易被忽略的一个点:业务发布脚本、运维自动化脚本可能把配置重置回去。定期基线巡检才能发现这种配置漂移。
闭环归档要留:扫描报告、工单、修复记录、审批记录、复测结论。等保审计和事后复盘都要用。
单次扫描加固之后,漏洞会持续新增,必须循环起来:
- 高危资产每月扫描,普通资产每季度扫描
- 基线配置自动比对,配置漂移告警
- 威胁情报联动:在野 0day、勒索团伙利用漏洞出现时,紧急专项扫描
- 告警降噪:区分真实漏洞、误报、可接受风险,避免告警疲劳
- 每次业务变更、新系统上线,纳入扫描范围
整套流程串起来:
资产盘点 → 授权扫描 → 指纹识别 → 漏洞分级研判
→ 补丁/配置/虚拟补丁/风险接受 四选一处置
→ 复测回归 → 工单闭环归档 → 周期性巡检
扫描是发现风险的手段,分级研判和修复闭环才是主体。工具替代不了判断,尤其业务逻辑漏洞、越权、未授权这些扫描器盲区,必须靠人工测试和代码审查补。
对于没有专职安全团队的业务,定期扫描 + 基线核查 + 高危项人工复核这套组合,能覆盖绝大多数已知风险;未知漏洞和逻辑漏洞,则要靠持续运营和定期渗透测试逐步补位。