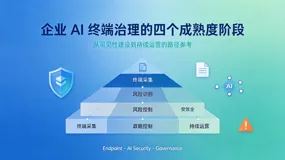
这类方案最常见的问题不是功能缺,而是"全都开了,效果都不实"。把它当成一条漏斗来设计会清楚很多:五层各有各的选型,也各有各的代价,混在一起谈"支不支持"没有意义。
一、识别层:成本最高,也最容易失真
三条路径的代价完全不同。后缀加路径判定几乎零成本,也几乎没有意义,改个后缀就穿过去了。内容特征(关键词、正则、证件号规则、压缩包与 OCR)能覆盖片段化泄露,代价是全量扫描的 CPU 与 IO 放大,批量打开大文件时用户能明显感到卡顿。
比较务实的组合是增量识别:只在写入与发送路径上做内容判定,静默期用空闲算力跑一次全盘基线建库,避免办公高峰争资源。
二、分级层:密级别指望人填
三档可选:策略显式(按目录、密级标记)、内容推断、发送时人工确认。这一层的代价不体现在性能上,而在传导性——分级错了,后面每一层都跟着错。所以必须留例外清单的出口,否则业务部门很快会用手机拍屏绕过去,风险从可见区搬到不可见区。
三、阻断层:阻断点越靠前,误报代价越大
写入侧阻断,一次误报就是一次工作中断;发送侧阻断,一次误报只是一次提示加一个审批回退。经验判断是:写入侧只做加密与水印这类不可逆但无感的动作,真正的阻断放到发送侧,并配审批出口。上线节奏也一样,先"只报警不阻断"两周拿基线,再分级放开。
四、留痕层:可还原性比条数重要
一条能复盘的记录至少五个字段:账号、终端、进程、目标、时间。只统计"拦截 N 次"的日志,事后追不到人、追不到路径。
五、复盘层:把误报率当成产品指标
误报率与漏报率是两个需要长期维护的数字:跑两周基线统计误报,抽样验证漏报,再据此调阈值。
性能账本:三个必须提前算清的账
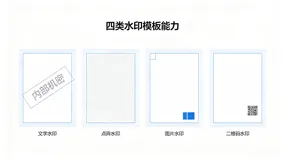
一是文件过滤驱动的 IO 延迟,与日志是否同步写强相关,异步缓冲能把影响压到用户无感。二是水印插件对 Office 启动的影响,渲染是一次性完成还是每次重绘,差别在使用体验上而不是参数表上。三是全盘扫描的磁盘占用与扫描窗口,决定了第一次上线会不会被投诉。
给甲方一张表比给一份功能清单有用:每项能力对应的开销、可关闭选项、关闭后的风险。漏斗的价值不在层数多,而在每层的代价都是可见的、可调的。