
2026年11月11日,阿里云正式发布通义千问第四代旗舰大模型——Qwen4-Max预览版。作为千问家族迄今为止能力最强的型号,Qwen4-Max融合文本生成、图片与视频理解及深度思考能力,直指复杂编程开发、专业办公、前端设计与复杂智能体任务,标志着国产大模型正式从"问答交互时代"迈入"任务完成时代"。
一、Qwen4-Max大模型是什么
Qwen4-Max是阿里云通义千问(Qwen)系列第四代的旗舰大模型,模型调用ID为qwen4-max,当前预览版标识为qwen4-max-preview(别名qwen4.0-max-preview)。截至2026年11月,官方开放的是预览版而非最终稳定正式版,预览窗口期为2026年11月11日10:00至11月25日24:00(UTC+8),期间模型行为不做变更,便于开发者获得一致的测试基准。预览结束后该模型标识会下线,正式版将以新的模型名发布,接入方需要预留改配置的工作量。
在千问完整产品矩阵中,Qwen4系列共规划四款主力模型,覆盖不同性能与成本档位:Qwen4-Max定位性能上限旗舰档,主打复杂任务与专业场景;Qwen4-Plus定位均衡档,追求性能、速度与成本三者平衡;Qwen4-Flash定位低成本高速档,面向高频调用、成本敏感场景;Qwen4-27B定位中等规模档,面向本地部署、数据不出域需求。其中Max档位始终代表同代产品里的最高规格,核心目标不是把通用对话做得更流畅,而是解决高复杂度、长链路、多工具协同的专业任务。在阿里云百炼的模型选择文档里,qwen4-max-preview被归入"复杂推理与编程"方向。
Qwen4-Max首发渠道为千问AI平台的Token Plan订阅服务,并同步打通千问办公、Qoder、千问App与QwenStudio等产品入口,千问App用户可通过"千问Go!"第一时间体验。与传统"开发布会→开放API→逐步接入应用"的发布路径不同,Qwen4-Max采用"预览版先进入计费平台与多类应用→收集真实调用反馈→再发正式版"的创新模式,让开发者能够比过去更早拿到新一代旗舰模型,同时通过真实使用反馈驱动后续迭代优化。简单来说,Qwen4-Max不是一款"聊天更顺手"的模型,而是一台面向真实任务的高性能引擎——它要解决的是长链路、高复杂度、多工具协同的专业工作,而不是轻量问答。
二、Qwen4-Max大模型核心能力
官方对Qwen4-Max的能力描述集中在四个方向:知识理解更深入、世界感知更立体、Coding(编程)能力持续进阶、Agentic(智能体任务执行)能力持续进阶,其中编程与Agentic是本次升级的重中之重。相比上一代旗舰Qwen3-Max,它更强调"把任务做完",而不是"把问题答好",衡量标准从单轮对话质量转向长链路任务执行成功率。
1. 编程能力(Coding)
编程能力是Qwen4-Max本次升级的核心重点。它支持完整大型项目代码生成、仓库级代码审计、架构重构与漏洞排查,可直接产出前端网页、3D建模脚本以及软件自动化操作代码,并能自动调试报错、补全单元测试、生成项目文档。官方内测成果集中在3D建模、网页设计与交互实现等领域,有海外开发者实测仅用一次生成、消耗约69k Tokens,就通过Java与Three.js完成了一段完整的3D渲染。
最具说服力的落地信号来自编程工具Qoder:此前供用户匿名测试的模型Qoduck已正式升级为Qwen4-Max-Preview并率先在Qoder上线,覆盖其全部产品与套餐(含Teams与Enterprise)。在为期四天的匿名盲测中,该模型每天都在更新,用户在完全不知道模型身份的前提下完成了真实使用,这种盲测结果比事后公布的跑分更接近生产环境表现。
2. 智能体能力(Agentic)
智能体能力是本次升级的另一大核心方向。Qwen4-Max能围绕复杂目标自主拆分步骤、分轮调用搜索、代码、文件处理等工具,减少人工干预,长周期任务不易中途断链、不易陷入无效循环。相比Qwen3-Max-Thinking仅支持"自适应工具调用"(在对话中自主选用搜索、记忆与代码解释器),Qwen4-Max进一步将动作空间从"调用API类工具"扩展到"操作图形界面软件",可支持专业办公与专业软件操作,任务链更长、动作类型更复杂。
3. 知识理解与推理能力
Qwen4-Max不再局限于静态知识的检索与复述,而是强化了对动态世界信息的理解,对文本、图像、结构化数据做深度语义对齐。在处理涉及物理常识、社会逻辑或跨领域专业知识的问题时,能够构建更长的因果推理链、识别隐含前提并修正错误假设,长文本精读、资料溯源与复杂问题拆解能力显著提升。模型默认开启深度思考模式,可通过reasoning_effort参数调节推理力度,档位包括low、high、xhigh,默认落在最高的high档位,用户可根据任务需求在精度与速度之间自由取舍。
4. 多模态世界感知能力
Qwen4-Max支持文本、图像、视频三种输入模态,输出为文本,视觉理解能力是本次新增强项。优化重点包括图像、图表、截图、文档混合输入的解析,以及图表数据提取、图纸解读、图文混排文档分析,可直接读取页面截图、带图表的文档与视频内容,不必把不同输入拆给不同模型分别处理。视觉规格方面,支持单张图片最高1600万像素、视频最长2小时、单个视频最大2GB。
5. 完整技术规格
根据阿里云百炼官方文档,Qwen4-Max正式版的核心规格如下:
- 上下文长度:1,000,000 Token
- 最大输入长度:991,808 Token(思考模式下为983,616 Token)
- 最大输出长度:131,072 Token(思考模式下为262,144 Token)
- 最大思维链长度:262,144 Token
- 流式输出:支持
- 并行工具调用:支持
- 联网搜索:支持
- Function Calling:支持
- 前缀补全:支持
- 思维链摘要与加密:支持
- 结构化输出:支持JSON Object、JSON Schema两种格式
- 显式缓存、隐式缓存:支持,TTL支持5m和1h
- 批量推理:华北2(北京)地域支持
- API兼容性:兼容OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、DashScope四种调用协议
- 部署地域:华北2(北京)、新加坡、德国(法兰克福)、美国(弗吉尼亚)、日本(东京)、中国香港
需要特别注意的是,自Qwen4-Max起,max_tokens与max_completion_tokens限制的是"思考内容+最终回答"的总Token量,而此前所有Qwen模型中它只限制回答长度。若把旧请求带着max_tokens小数值直接搬过来,思考一开到高挡位就可能吃光额度,导致回答被中途截断且不会报错。稳妥做法是调大输出上限为思考预留余量,不需要深想的任务把推理力度调到low或medium档位。另外,多轮对话场景下preserve_thinking默认开启,历史思考内容需在reasoning_content字段中完整回传,不要拼进content当作下一轮历史发回去。
三、Qwen4-Max大模型适用场景
结合官方定位与早期实测反馈,Qwen4-Max更适合"对结果质量敏感、流程长、步骤多"的专业任务,具体适用场景可按用户角色清晰划分:
| 用户角色 | 典型任务 | 推荐入口 |
|---|---|---|
| 独立开发者 | 复杂代码项目、批量脚本、Web全栈开发、深层bug修复 | Token Plan + Claude Code / Qwen Code / Cursor |
| 团队与企业开发 | 多文件工程联动、代码重构、自动化测试、Agent工作流 | Qoder(含Teams / Enterprise套餐) |
| 前端与设计师 | 网页设计、交互页面实现、3D建模、可视化呈现 | Qoder、QwenStudio |
| 办公人群 | 文档撰写与解读、表格处理、文献研读、方案与报告生成 | 千问办公、千问APP |
| 智能体开发者 | 提示词调试、Agent链路测试、工具调用编排、长任务自动化 | QwenStudio、Token Plan API |
| 企业与科研机构 | 新模型能力评估、场景验证、提前适配 | Token Plan预览期测试 |
| 多模态任务需求方 | 图表数据提取、图纸解读、图文混排文档分析、视频内容理解 | Token Plan API(图像与视频输入) |
总结来说,Qwen4-Max的核心适用场景集中在四大领域:一是复杂编程开发,包括全栈项目代码生成、仓库级代码审计与重构、前端页面设计、3D建模脚本、软件自动化流程搭建;二是多步骤Agent智能体,需要多轮工具协同、自动拆分目标的长周期任务,例如科研流水线、财务自动分析、多步骤办公自动化机器人;三是长文档与混合资料分析,几十万字合同、整本书籍、完整代码库的一次性读取,以及条款比对、风险识别、内容归纳,图文、表格、视频混合资料的联合研判;四是专业办公与专业软件操作,财报深度解读、法律合同审阅、行业调研报告撰写、专业软件操作自动化等。
需要明确的是,高并发、低延迟、成本敏感的简单问答与文案生成并不是Qwen4-Max的强项,这类任务使用Qwen4-Flash或Qwen4-Plus更划算。把旗舰模型用在旗舰任务上,才是成本与效果之间的平衡点。同时由于预览版将于2026年11月25日下线,当前不建议直接用于不可中断的生产业务,更适合用于能力评估、场景验证与提前适配,对输出稳定性有强一致要求、需要明确SLA的生产环境应继续使用Qwen3-Max或Qwen3.8-Max正式版。
四、Qwen4-Max大模型收费标准
Qwen4-Max正式版采用灵活的计费方式,全球多地域部署,各区域价格透明统一:
1. 按量计费标准
以华北2(北京)地域为例,核心按量计费价格如下:
| 计费项 | 单价(每百万Token) | 说明 |
|---|---|---|
| 输入Token | 10元 | 非思考和思考模式统一价,0<Token≤1M |
| 输出Token(思维链+回答) | 30元 | 非思考和思考模式统一价 |
| 缓存输入单价 | 10元 | 复用系统提示词、工具说明等公共输入前缀 |
| Batch File批量推理 | 输入5元,输出15元 | 离线批量处理场景 |
| Batch Chat批量推理(限时5折) | 输入10元,输出30元 | 原价基础上限时五折 |
| 免费额度 | 100万Token | 自开通之日起90天内有效 |
国际地域价格略有差异:新加坡地域输入10.938元/百万Token、输出32.813元/百万Token;德国(法兰克福)、美国(弗吉尼亚)、日本(东京)、中国香港地域与北京地域价格一致,输入10元/百万Token、输出30元/百万Token。
2. 限流标准
华北2(北京)与新加坡地域按平台月消费分级限流:月消费≤10万的等级1用户TPM(每分钟Token数)为500万,月消费10万~100万的等级2用户TPM为1000万,月消费>100万的等级3用户TPM为2000万。其他国际地域统一限流为RPM(每分钟请求数)30000、TPM 500万。
3. Token Plan订阅体系
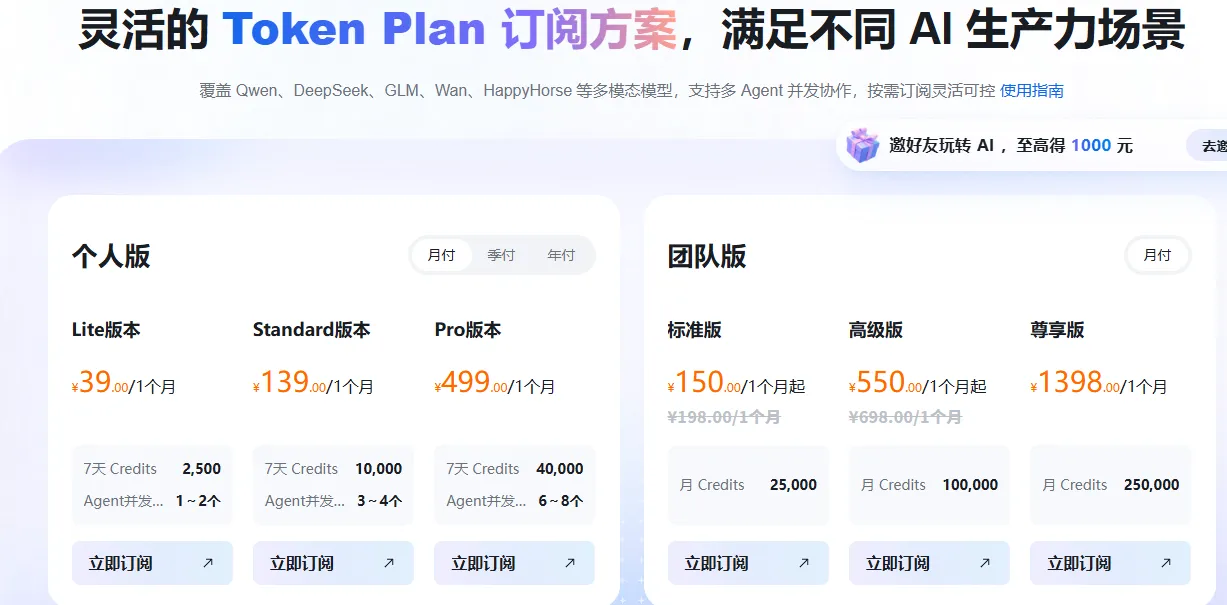
Qwen4-Max首发期间主要通过Token Plan订阅制开放调用,采用Credits统一计量,一份订阅可在千问系列模型以及多类工具间通用,不用为每个模型、每个工具单独充值和记账。2026年11月9日官方额度大幅调整后,个人版四档价格与额度如下:
| 套餐档位 | 官网月费 | 每月Credits额度 | 并发Agent数量 | 单位Credits成本 |
|---|---|---|---|---|
| Lite | 39元/月 | 20,000(原11,500,+73.9%) | 1-2个 | 0.00195元/Credit |
| Essential | 79元/月 | 45,000(原25,500,+76.5%) | 2-3个 | 约0.00176元/Credit |
| Standard | 139元/月 | 80,000(原45,000,+77.8%) | 3-4个 | 约0.00174元/Credit |
| Pro | 312元/月(原499元,降37.5%) | 200,000(原180,000,+11.1%) | 6-8个 | 0.00156元/Credit |
此次调整力度非常大:Lite、Essential、Standard三档月费不变,月度额度提升约74%-78%;Pro档不仅月费从499元降至312元,额度还增加了2万Credits,单位成本降幅达43.7%,是四档中性价比提升最明显的一档。
团队版按座席计费,双11限时价为:标准座席150元/座席/月(原价198元)含25,000 Credits;高级座席550元/座席/月(原价698元)含100,000 Credits;尊享座席1398元/座席/月含250,000 Credits。团队版额外提供席位分配与回收、成员用量分析、多租户隔离,并承诺不使用对话数据训练模型,适合数据敏感的企业用户,这一点对企业选型具有决定性意义——个人版的数据用于服务改进与模型优化,涉及商业机密、客户数据或受合规约束的业务必须选择团队版。
费用抵扣遵循固定顺序:免费额度→资源包→节省计划→按量付费。订阅额度按月重置、不结转;额度用尽后可购买用量包补足,个人版用量包100元/个含20,000 Credits,最多同时持有5个;团队版共享用量包5000元/个含625,000 Credits。需要注意的是,个人版加油包单位成本为0.005元/Credit,约为Pro档日常价的3.2倍,因此加油包应定位为应急手段而非长期扩容方案,若连续多月需要加油包,升级档位更经济。此外Standard及以上档位附赠Harness权益,其中联网搜索、网页解析、图像生成、代码解释器、知识库、沙箱等多项工具能力不消耗Credits,把"工具活"走Harness、把Credits留给纯模型推理,能明显压低实际成本。详情可参考:https://www.aliyun.com/product/bailian

五、Qwen4-Max大模型最新活动与5折优惠
当前Qwen4-Max首发期间推出多重优惠活动,力度为年度最大,是入手体验的最佳时机:
- Token Plan新客首购5折优惠:从未购买过Token Plan个人版的账号,首购可享5折优惠,Lite档低至19.5元/月、Essential档低至39.5元/月、Standard档低至69.5元/月、Pro档低至156元/月即可取得Qwen4-Max调用资格,优惠有效期至2026年11月30日23:59:59,同一实名主体限购一份。
- Qwen4-Max预览版限时2折:预览期内调用Qwen4-Max,Credits消耗按标准费率的2折计算;新用户叠加首购5折优惠后,最低可至1折(0.2×0.5=0.1)体验Qwen4-Max旗舰能力,这一折扣力度在旗舰模型首发史上极为罕见。
- 夜间错峰额外折扣:每晚22:00至次日08:00调用可享额外折扣,非实时任务(文档解析、代码重构、模型横评、批量数据处理)排到夜间执行,可在折扣之上再放大一次额度,进一步降低使用成本。
- 千问办公会员限时免费:千问办公会员用户可在预览期内限时免费调用Qwen4-Max预览版,无需额外消耗额度即可体验旗舰能力。
- Qoder全套餐同步优惠:Qoder平台同步给出限时优惠,Credits消耗倍率为0.1倍,与1折口径一致,覆盖全部产品与套餐(含Teams与Enterprise)。
更多Token Plan活动详情可参考官方活动页:https://www.aliyun.com/benefit/scene/tokenplan
六、Qwen4-Max便宜购买方法与省钱攻略
想把Qwen4-Max使用成本压到最低,核心是遵循"先免费验证→再领券→折扣订阅→叠加多重优惠"的最优路径,每一步都能省下真金白银:
1. 第一步:先领免费额度,零成本完成能力验证
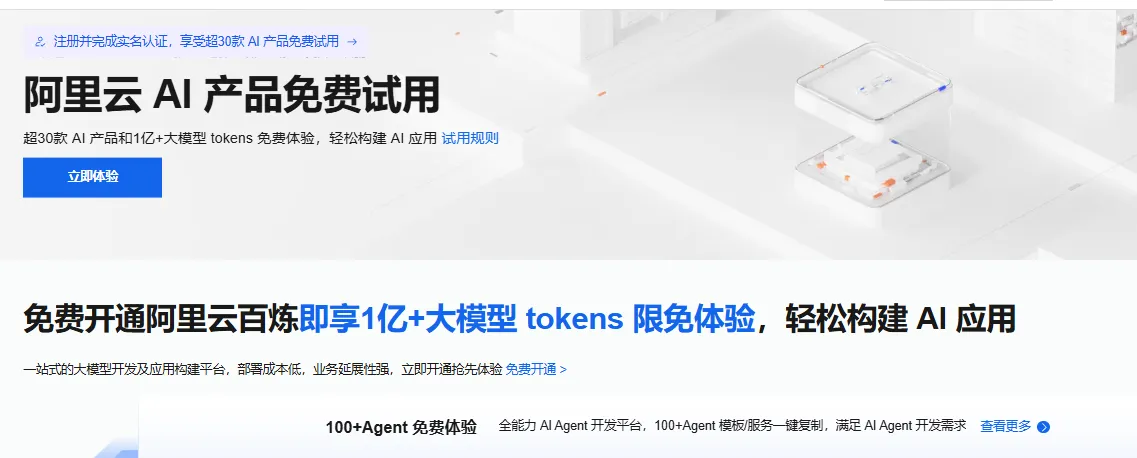
阿里云百炼面向新用户提供行业内极具竞争力的免费额度:完成实名认证、首次开通百炼服务的新用户,可免费领取超7000万Tokens大模型免费额度,覆盖Qwen、GLM、DeepSeek等70余款主流模型,每款主流模型各分配约100万Token推理额度;完成企业认证的用户累计可领到1亿以上Tokens。免费额度活动详情可参考:https://free.aliyun.com/product/ai
免费额度的使用规则需要记牢,避免浪费:
- 有效期90天,仅限华北2(北京)地域使用,其他地域无法抵扣;
- 不是注册即得,必须在百炼控制台完成服务开通并切换至华北2(北京)地域,额度才会生效,一般两小时内下发;
- 仅限实时推理(API调用或控制台同步对话)抵扣,不支持批量任务、微调训练与模型部署;
- 主账号与RAM子账号共用同一额度池,不同模型额度独立计算;
- 务必开启"用完即停"防护,某个模型免费额度耗尽时系统不会自动切换其他模型,避免意外产生按量账单。
免费额度的正确用法不是"白嫖跑量",而是专门用于效果验证:用真实业务任务跑7-14天,统计日均Credits消耗,再据此选择合适的订阅档位。跳过这一步直接买套餐,最常见的结果就是"买Lite不够用、买高档用不完",造成不必要的浪费。
2. 第二步:先领通用优惠券,再下单折上折
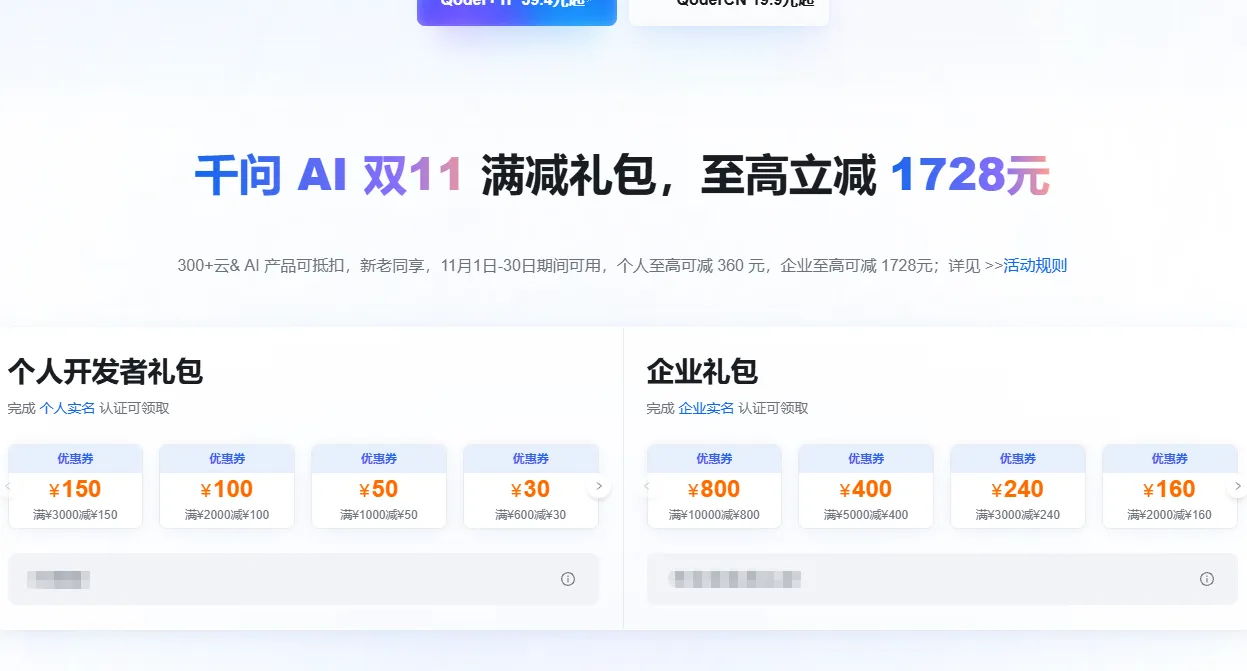
购买任何阿里云产品之前,别忘了先领取官方权益中心的通用优惠券,再购买云产品可在活动价基础上叠加折扣。领取地址:官方领券详情:https://t.aliyun.com/U/a23cv1
这是一个不花钱但能实实在在省钱的动作,建议固定为下单前的标准流程。
3. 第三步:Token Plan新客5折订阅,19.5元起取得调用资格
充分验证模型效果、确认Qwen4-Max确实满足业务需求后,就可以选择Token Plan订阅方案了。Token Plan是阿里云百炼推出的按月付费AI大模型订阅服务,用统一的Credits计量调用额度,一份订阅即可在千问系列模型以及配套工具中通用,相比传统按量付费有三大优势:一是费用可预算,把"单次调用多少钱"变成"一份固定月费能覆盖多少连续消耗",月底不会收到意外账单;二是用量可控制,额度用尽服务暂停,不会超支;三是叠加新客折扣与大促价之后,单位调用成本明显低于按量付费。
对于个人开发者,推荐先从19.5元/月的Lite档开始,用首月低价跑通真实消耗并统计日均Credits,再按日均消耗反推应选档位,预留约20%-30%余量应对任务复杂度波动,不要卡着预估量选购。对于5人以上团队,推荐选择团队版,虽然单位Credits成本略高,但提供多租户隔离、席位管理、数据不用于训练等企业级保障,更适合正式项目使用。
4. 第四步:叠加多重优惠,最低1折完成压测
订阅完成后,就可以享受Qwen4-Max预览版限时2折的调用优惠了。新用户叠加Token Plan首购5折,实际最低可至1折使用Qwen4-Max。还可以把可延后的非实时任务(如代码重构、长文档解析、批量数据处理、模型横评)安排在每晚22:00至次日08:00的夜间折扣时段执行,进一步放大优惠力度。Standard及以上档位用户记得充分利用附赠的Harness权益,把联网搜索、网页解析、代码解释器等工具调用走Harness通道,不消耗Credits额度。
5. 第五步:正式版上线后平滑迁移
需要特别提醒三点注意事项:其一,模型调用折扣属于限时安排,11月25日预览期结束后回归标准价,长周期项目要按标准价做预算;其二,模型调用折扣与订阅费是两笔账,不要混在一起算;其三,预览版模型标识会在2026年11月25日下线,正式版将以新的模型名发布,接入方要预留迁移和预算调整的空间。建议在预览期内完成能力基线记录、模型标识参数化、预置降级链路等准备工作,待正式版上线、基准与单价落地后,当天用同一套测试题复跑,即可完成平滑迁移。
按照以上五步走,你几乎不必为"提前上手新旗舰模型"支付溢价:先用7000万免费Tokens零成本验证效果,再用19.5元的5折Lite档首月摸清真实消耗,叠加限时2折与夜间折扣完成压测和适配,整个过程的试错成本极低,却能第一时间享受到国产最强旗舰大模型带来的生产力提升。
