
导读:上一篇讲了客户端「翻译、递交、功成身退」,作业交出去之后,接住它的是 JobManager。值得搞清楚的是它内部的三层分工、每个作业一份的 JobMaster、checkpoint 的总指挥角色,以及那个经典问题——它挂了怎么办。这篇把 Flink 2.3 的 JobManager 拆开讲透。
一、它不做计算,它做决定
先给结论:JobManager 是 Flink 集群的中央协调者,负责调度与资源管理,但它不执行任何一条算子。
它每一分钟都在做四类决定:下一个 task 什么时候排、slot 给谁、checkpoint 什么时候触发、失败之后从哪里重启。数据从不经过它(除了极小状态下的 JobManagerCheckpointStorage),它管的只有「安排」和「账本」。
理解这个定位,很多现象就通了:为什么 JobManager 挂了数据不丢——checkpoint 都写在文件系统上;为什么它却常常是第一个撑不住的进程——所有作业的元数据、心跳、回调都压在它一个 JVM 里。
二、一个 JobManager 里,住着三个角色
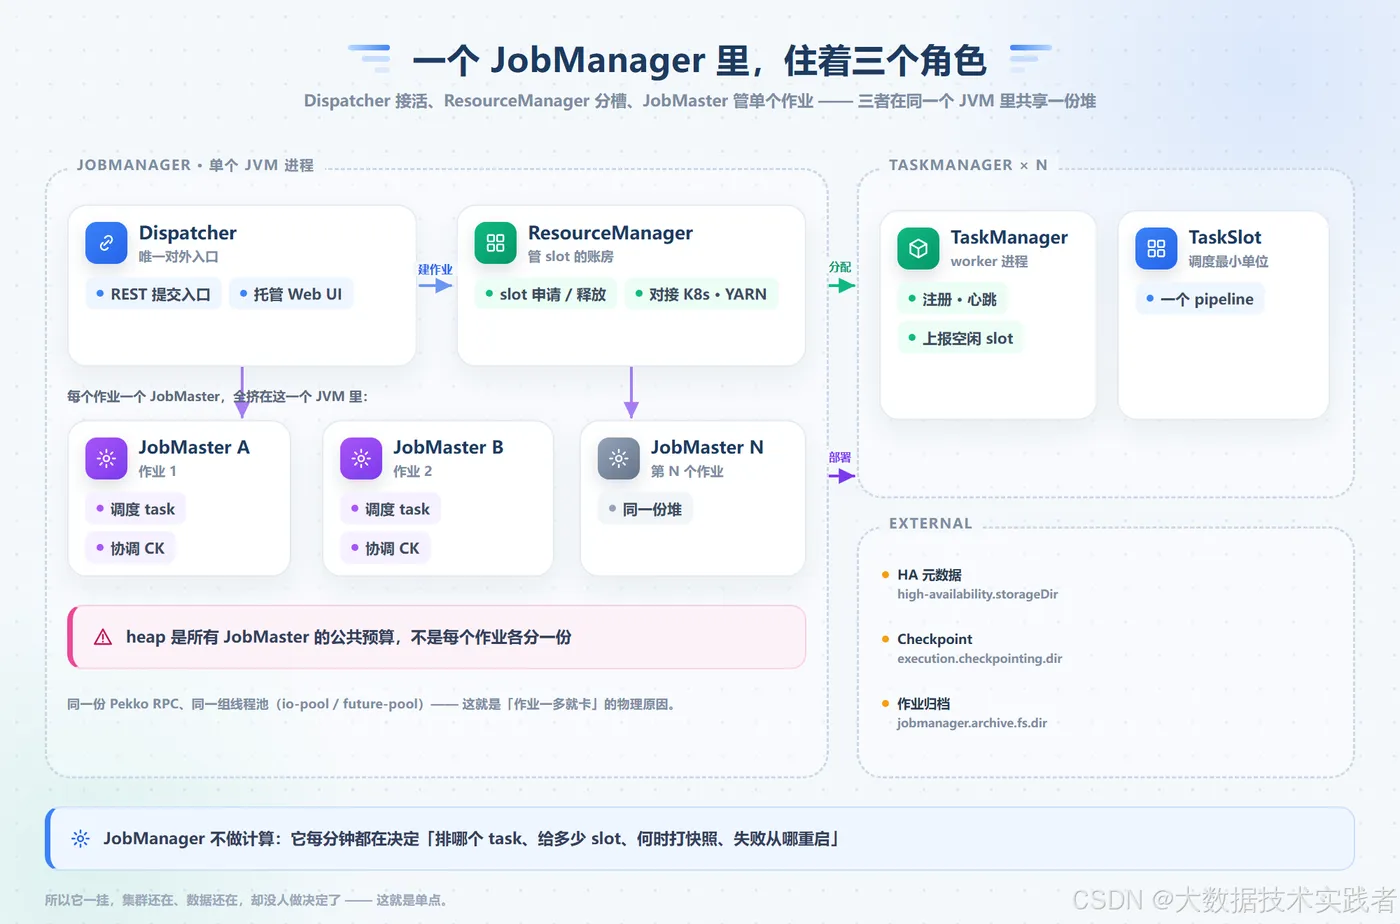
JobManager 不是一个人在战斗,它是一个 JVM 进程里的三个组件:
Dispatcher:唯一的对外入口。 提供 REST 接口接收作业提交、托管 Web UI,并为每个提交的作业拉起一个 JobMaster。你平时在 8081 端口看到的那个页面,就是它提供的。
ResourceManager:管 slot 的账房先生。 它管理 Flink 集群的资源调度单元——task slot。不同资源提供者(Standalone、Kubernetes、YARN)各有自己的实现:K8s 和 YARN 下它能向集群要新的 TaskManager;Standalone 下它只能分配已有 TM 的 slot,要不了新的。
JobMaster:一个作业一个。 每个 JobGraph 对应一个 JobMaster,负责这单个作业的执行:把执行图按 pipeline region 切分、向 ResourceManager 申请 slot、调度 task、协调这个作业的 checkpoint。一个集群同时跑十个作业,就有十个 JobMaster——它们全部挤在同一个 JVM 里,共享一份堆、一套 Pekko RPC、一组线程池。这是后面所有「作业一多就卡」问题的物理根源。
右边是 TaskManager:启动后向 JobManager 注册并汇报空闲 slot(心跳默认 10 秒一次、50 秒超时),JobMaster 把 subtask 部署下去,真正的算子才开始跑。
三、作业跑起来之后,它每秒在决定什么
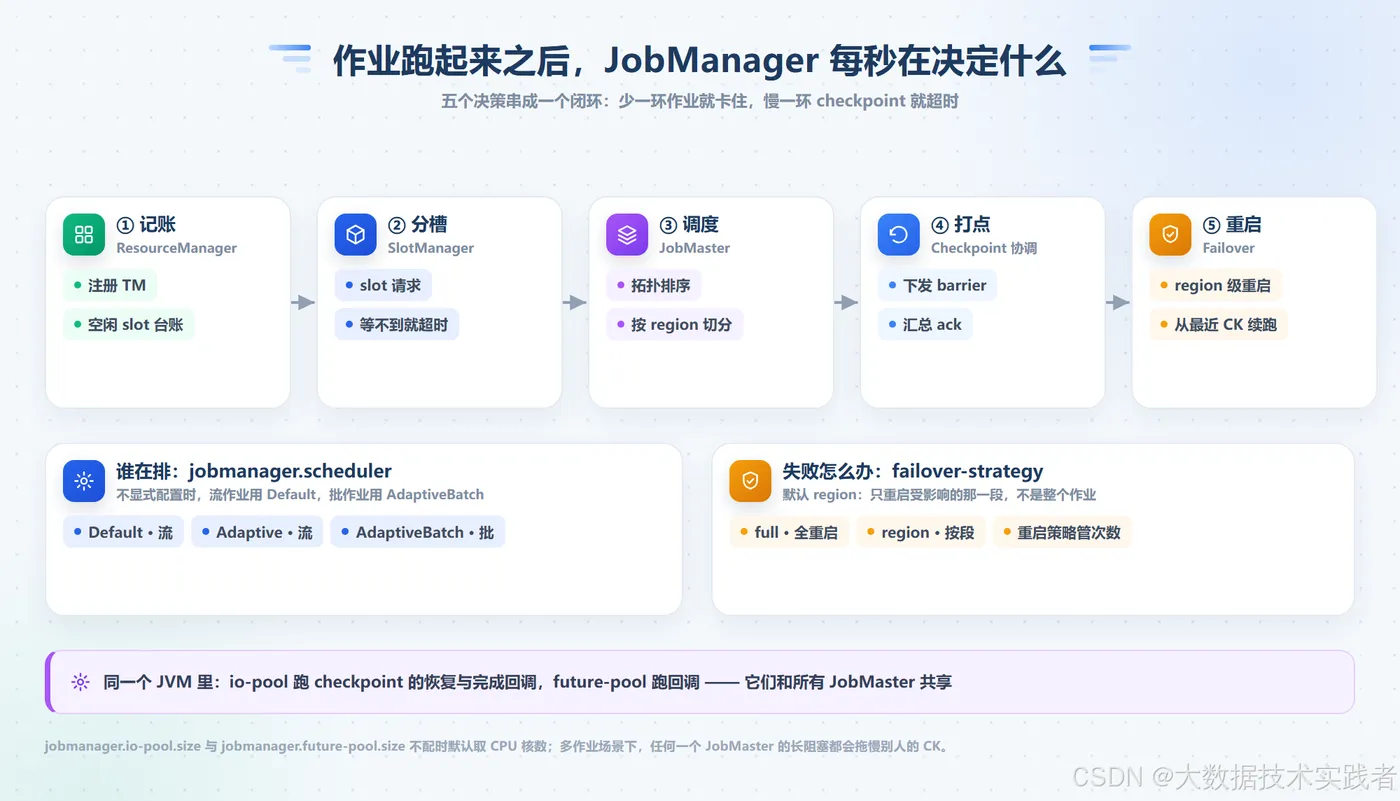
作业的运行期,就是上面五个决策不断循环的过程:
- 记账:ResourceManager 维护所有 TaskManager 的注册信息与空闲 slot 台账;
- 分槽:JobMaster 提出 slot 请求,SlotManager 匹配下发,等不到资源时按
jobmanager.adaptive-scheduler.submission.resource-wait-timeout(默认 5 分钟)超时降级或失败; - 调度:JobMaster 按拓扑顺序把 task 部署到 slot 上;
- 打点:checkpoint 协调器周期性下发 barrier、汇总所有 task 的 ack、把完成回调跑完;
- 重启:task 失败后按 failover 策略决定重启范围。
两个配置决定这套循环的脾气。jobmanager.scheduler:不显式配置时,流作业用 Default 调度器,批作业默认走 AdaptiveBatch(按数据量动态决定并行度)。jobmanager.execution.failover-strategy:默认 region——只重启受失败影响的 pipeline region,而不是整个作业;Streaming 作业里 region 通常就是整条链,批作业则能显著缩小爆炸半径。
还有一个容易被忽略的细节:JobManager 的 io-pool(跑 checkpoint 的恢复与完成)和 future-pool(跑异步回调)默认都取 CPU 核数,且所有 JobMaster 共享。Session 集群里任何作业的 checkpoint 回调变慢,都会拖慢别人——排「CK 突然变慢」时,先看是不是有邻居作业在作妖。
四、checkpoint 的总指挥
JobManager 里的 checkpoint 协调器是精确一次语义的中枢:向 source 注入 barrier、等所有 task 确认、通知完成回调把状态句柄落盘。快照数据本身去哪,由 Checkpoint Storage 决定:
# 不配 checkpoint 目录时,走 JobManagerCheckpointStorage:
# 快照直接存进 JobManager 的堆里,单次默认上限 5 MB
execution.checkpointing.storage: filesystem      # 显式选文件系统存储
execution.checkpointing.dir: s3://bucket/flink/ck/
JobManagerCheckpointStorage 只适合本地调试;生产上必须配文件系统存储,否则快照会跟作业元数据一起挤爆 JobManager 的堆。checkpoint 元数据文件落在哪里、HA 模式下怎么冗余,全部由 JobManager 决定——这也是为什么「JobManager 内存」和「checkpoint 稳定性」经常是同一道题。
五、JobManager 挂了怎么办:一主多备 + 一份账本
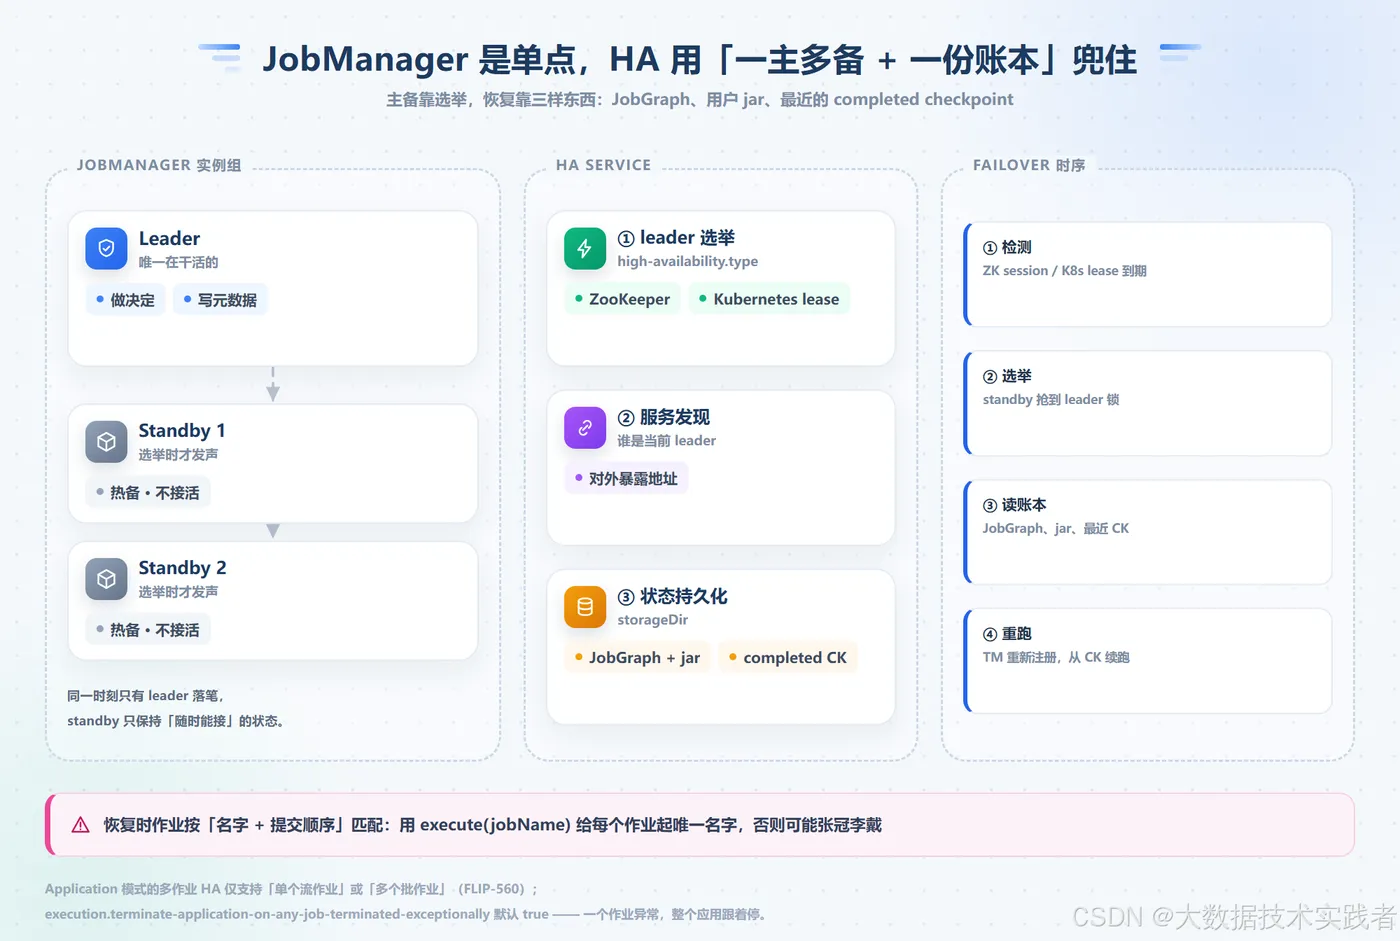
默认一个集群只有一个 JobManager,这就是单点故障(SPOF)。HA 的思路很直接:任何时刻只有一个 leader 在干活,多个 standby 待命;账本放在共享存储上,谁上位谁接着记。
HA 服务封装了三件事:leader 选举(ZooKeeper 或 Kubernetes lease)、服务发现(对外暴露当前 leader 地址)、状态持久化(high-availability.storageDir 里存 JobGraph、用户 jar 和最近的 completed checkpoint)。切换时序是四步:检测(ZK session 或 K8s lease 到期)→ standby 选举上位 → 读账本 → TaskManager 重新注册,从最近 checkpoint 续跑。
high-availability.type: kubernetes          # 或 zookeeper / NONE(默认)
high-availability.cluster-id: /prod-flink   # 集群隔离标识
high-availability.storageDir: s3://bucket/flink/ha/
有两个容易踩的细节。其一,恢复时作业按「名字 + 提交顺序」匹配——HA 恢复要靠名字把新旧作业对上,多作业应用务必用 execute(jobName) 给每个作业起唯一名字,否则可能张冠李戴。其二,2.3 里 Application 概式成了 HA 的一等公民(FLIP-560):session 模式下未完成的 application 会自动重新执行,但 Application 模式的多作业 HA 仅支持「单个流作业」或「多个批作业」的组合,并且 execution.terminate-application-on-any-job-terminated-exceptionally 默认 true——executeAsync 并发跑的多个作业里有一个异常终止,整个应用连同其他作业一起停。
六、它的内存账本:谁在吃掉那几个 G
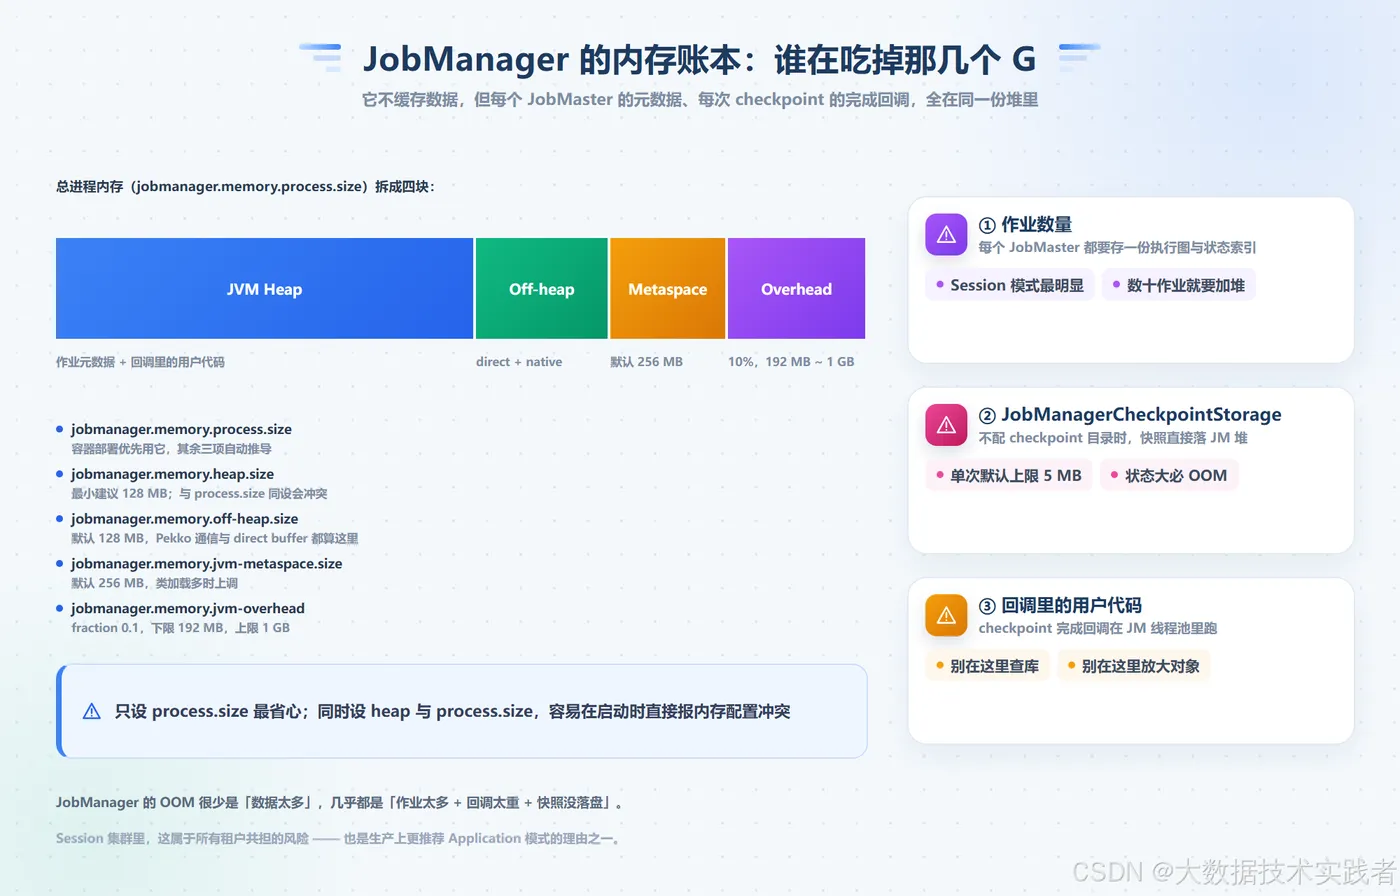
JobManager 不缓存数据,但它有三个稳定的内存消耗源:
- 作业数量 × 元数据。每个 JobMaster 都要持有一份执行图、执行计划和状态索引。Session 集群跑几十个作业,光元数据就很可观;
- JobManagerCheckpointStorage。不配 checkpoint 目录时快照直接进堆,单次默认 5 MB 上限挡不住积少成多;
- 回调里的用户代码。checkpoint 完成回调跑在 JobManager 的线程池里——在这里查库、放大对象、做重 IO,OOM 只是时间问题。
配置上一条原则:容器里只设 jobmanager.memory.process.size,其余(heap、off-heap 默认 128 MB、metaspace 默认 256 MB、overhead 10%)让 Flink 自己切;同时显式设置 heap 和 process.size 会在启动时报内存配置冲突。
七、2.3 的两个新变化
变化一:application 成为一等公民(FLIP-549)。 层级从 cluster → job 变成 cluster → application → job,REST API 新增 /applications/overview、/applications/:applicationid、POST /applications/:applicationid/cancel 等端点,JobResultStore / ApplicationResultStore 负责记录终态结果,归档按 cluster-id 与 application-id 组织。运维视角下,「看一个应用」比「翻一堆 job id」顺手得多。
变化二:调度更聪明、可观测。 批作业默认使用 AdaptiveBatch 调度器;adaptive scheduler 新增扩缩容历史记录(FLIP-495)与 Web UI 的 Rescales 页面(FLIP-487),可回看每次扩缩容的 slot 分配与耗时。配合 2.3 的恢复期间打快照(FLIP-547),JobManager 在反复扩缩容场景下的「失忆」问题基本被填平。
八、五个高频坑
坑一:Session 集群当全家桶。 一个 JobManager 管所有作业,一个邻居作业把堆撑爆,全集群陪葬。多租户场景拆 Session、上 Application 模式。
坑二:多作业没起名字。 HA 恢复按名字匹配,execute() 不带名字的作业恢复后可能对不上号。
坑三:checkpoint 没落盘。 忘配 execution.checkpointing.dir,快照全进 JobManager 堆,作业一大必 OOM。
坑四:把 JobManager 当小角色配资源。 默认 1 GB 出头的进程内存,跑几十个作业的元数据加回调根本不够。Session 集群的 JobManager 内存按「作业数 × 作业复杂度」给,别按「它不干活」给。
坑五:Standalone ResourceManager 当成 K8s 用。 Standalone 下它只能分配已有 slot,要不了新 TM——slot 不够不会自动扩,只会让作业干等。
九、写在最后
JobManager 的全部工作可以压缩成一句话:在正确的时间,把正确的决定写到正确的账本上。 三个组件分工——Dispatcher 管入口、ResourceManager 管槽位、JobMaster 管单个作业;五个决策循环——记账、分槽、调度、打点、重启;一套 HA 兜底——一主多备、账本外置。下一篇看 TaskManager 里 subtask 真正跑起来的样子。
