
前两天和朋友聊本体论,有个朋友抱怨说,老板让他给自己负责的系统梳理本体,累坏了,效率太低!
我笑而不语,都 2026 年了,咋遇到活还是先想着自己干呢?
也听到有人吐槽,现在网上很多本体论相关文章太“务虚”,不够“落地”。
这篇文章先简单聊聊本体的概念,以及它和几个常见概念的区别,再分享一种高效梳理老系统本体的方法。
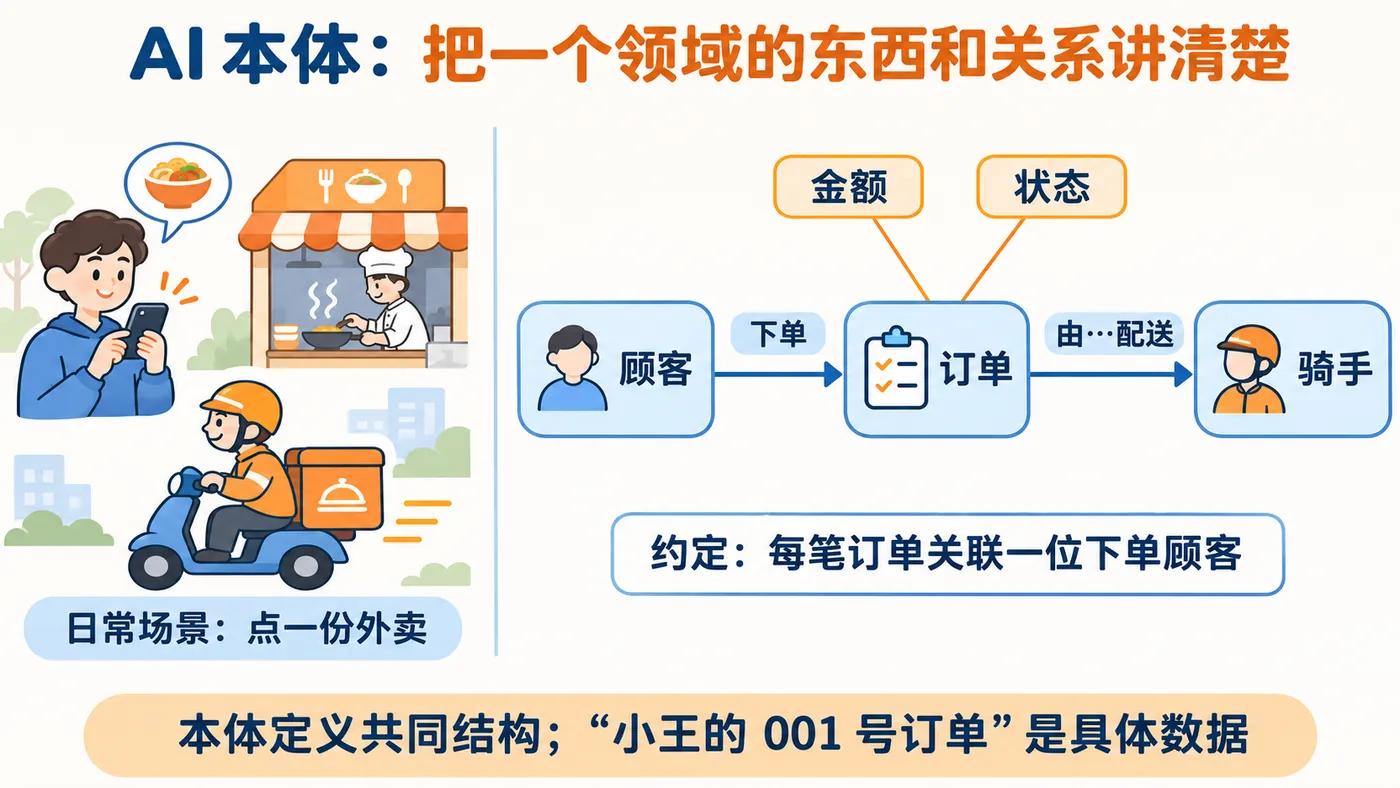
点外卖是一个业务场景,本体就是对这个场景进行结构化建模:定义顾客、订单、商家、骑手等对象,它们的属性(如订单金额、状态)、关系(如下单、接单、配送)及约束,让 AI 能按统一的业务含义处理具体订单。
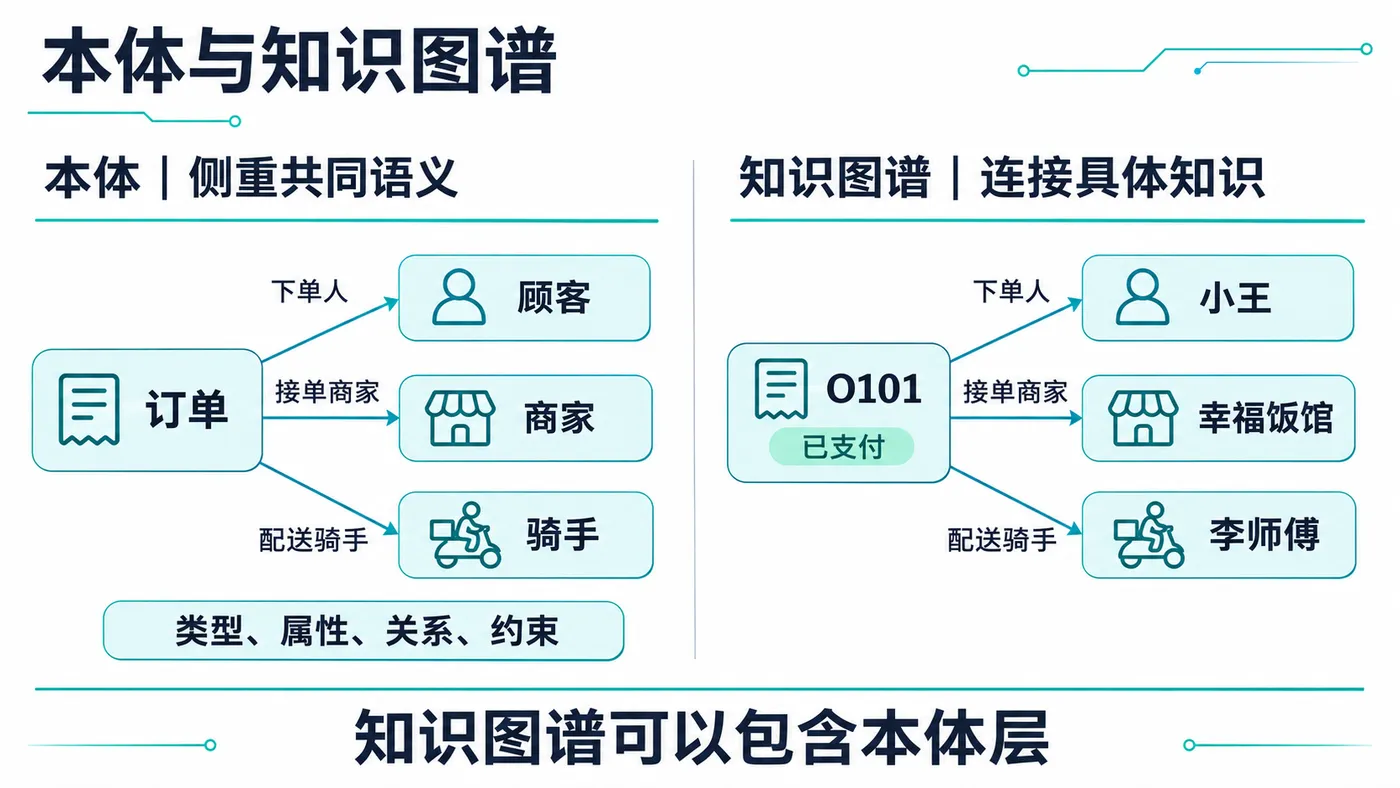
本体和知识图谱很像,但本体侧重定义“这些东西是什么意思、怎样关联”;知识图谱侧重把“具体有哪些东西、它们有什么关系”连接起来。两者通常配合使用。
拿点外卖来说,本体定义“订单”“顾客”“商家”“骑手”分别是什么,订单与下单人、接单商家、配送骑手有什么关系;知识图谱则可以记录“小王下了订单 O101,由幸福饭馆接单,李师傅配送”,再把这些具体对象连接起来。
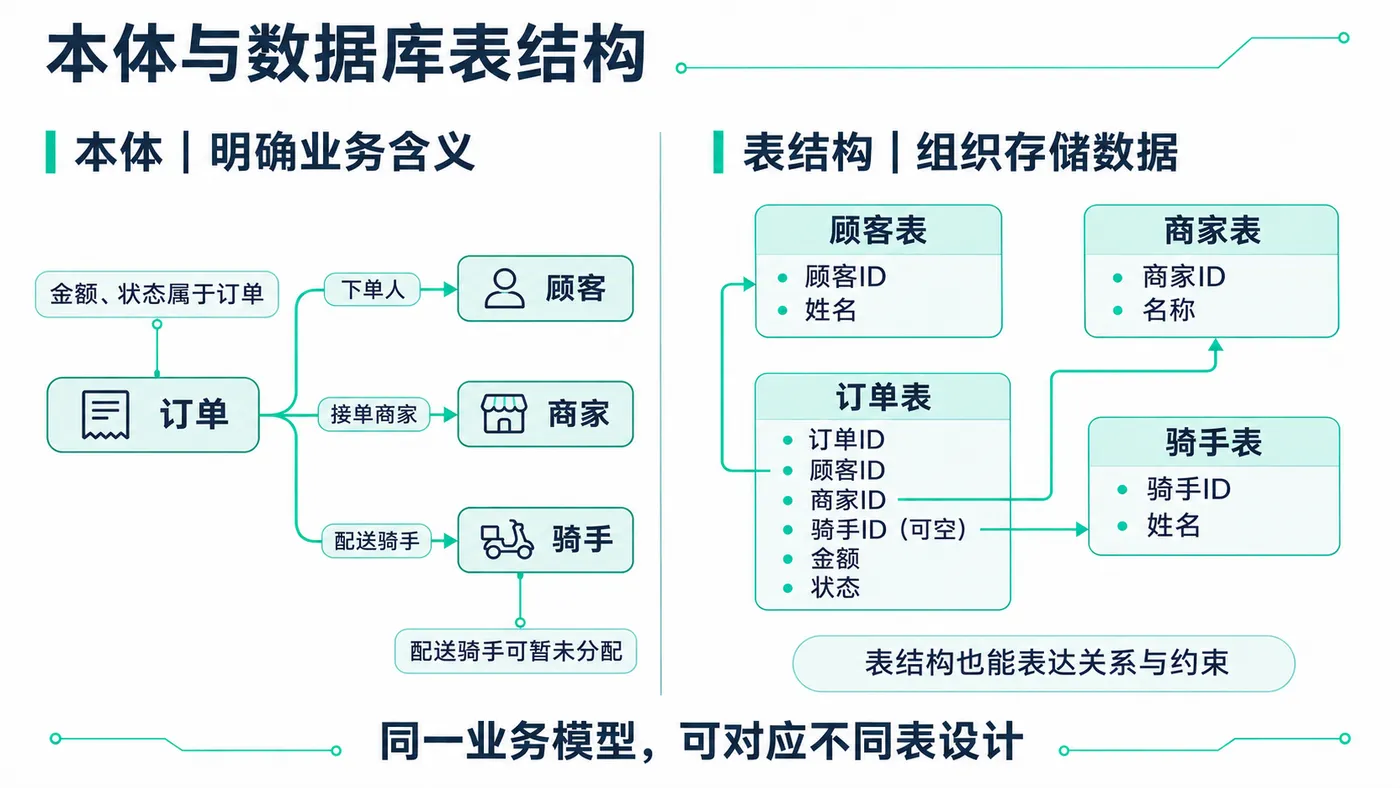
本体和表结构确实很像:设计良好的表结构,本身就包含了不少业务建模。本体更强调“大家共同采用什么业务含义”,表结构更直接规定“这套数据库怎样组织和约束数据”。
还是点外卖:本体说明“金额和状态属于订单”“订单关联下单顾客和接单商家”“订单在分配骑手前,可以没有配送骑手”;表结构则把它们落成顾客表、商家表、骑手表、订单表,以及订单表中的金额、状态和关联 ID 等字段。同一套业务含义,也可以采用不同的表设计。
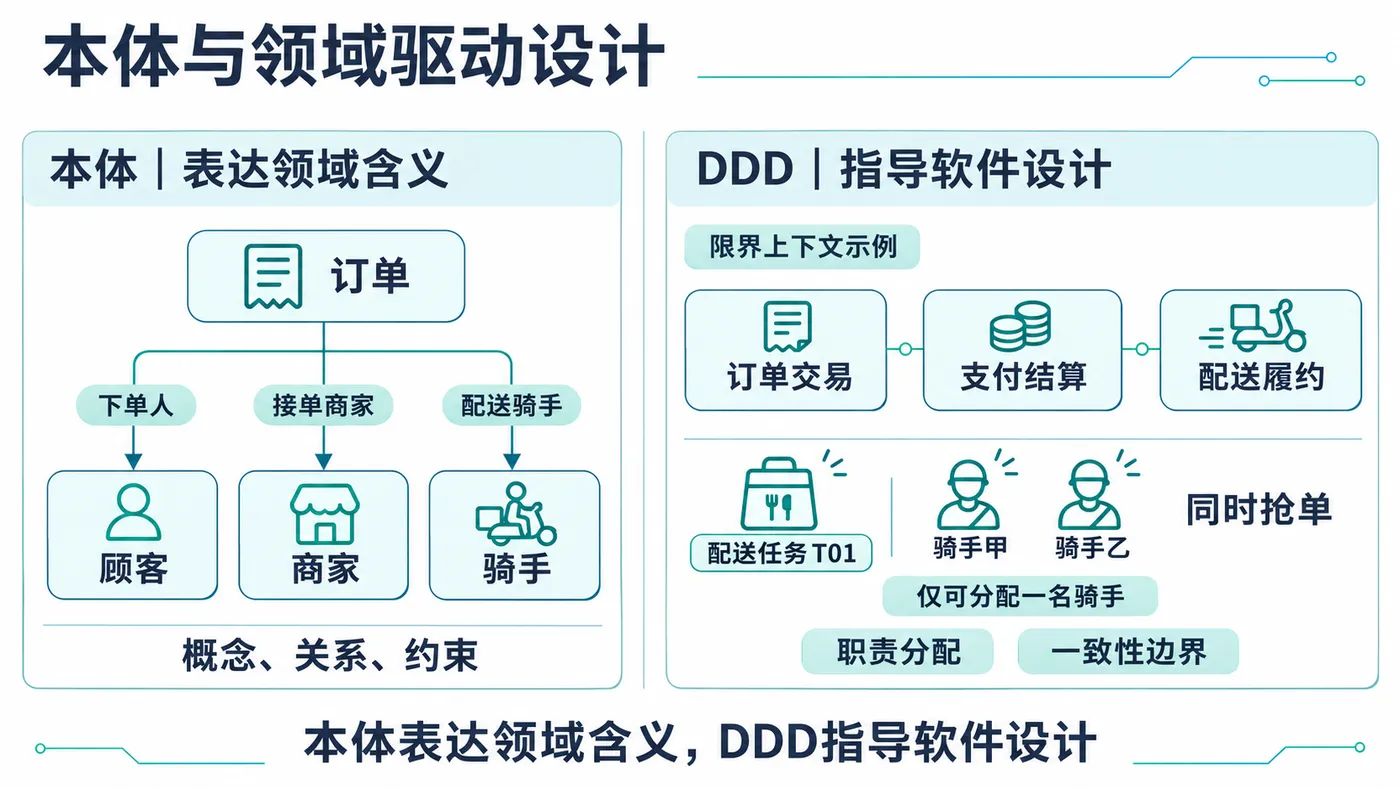
本体与领域驱动设计也有相似之处。本体主要是一套表达业务含义的模型;DDD(领域驱动设计)是一套围绕业务模型设计软件的方法。两者都会梳理概念,但解决的问题范围不同。
继续用点外卖对照:
| 比较 | 本体侧重 | DDD 侧重 |
|---|---|---|
| 核心问题 | 业务中的事物分别是什么、怎样关联 | 如何围绕这些业务概念组织软件 |
| 点外卖例子 | 顾客、订单、商家、骑手的含义与关系 | 订单交易、支付结算、配送履约怎样划分职责,各自维护什么规则 |
| 常见产物 | 类型、属性、关系、语义约束 | 统一语言、限界上下文、领域对象、聚合等设计 |
比如,两名骑手同时抢同一个配送任务,本体可以表达“一个配送任务同一时刻最多分配给一名骑手”这条约束;DDD 则帮助设计由哪个领域对象维护这条规则、哪些状态需要一起更新,以及配送与订单、支付之间怎样协作。具体的并发控制仍要靠程序实现。
所以,做外卖软件时,DDD 可以指导职责、行为和边界设计;本体可以帮助这些系统及 Agent 共享、解释业务含义。 两者能够结合,也可以按需要分别使用。
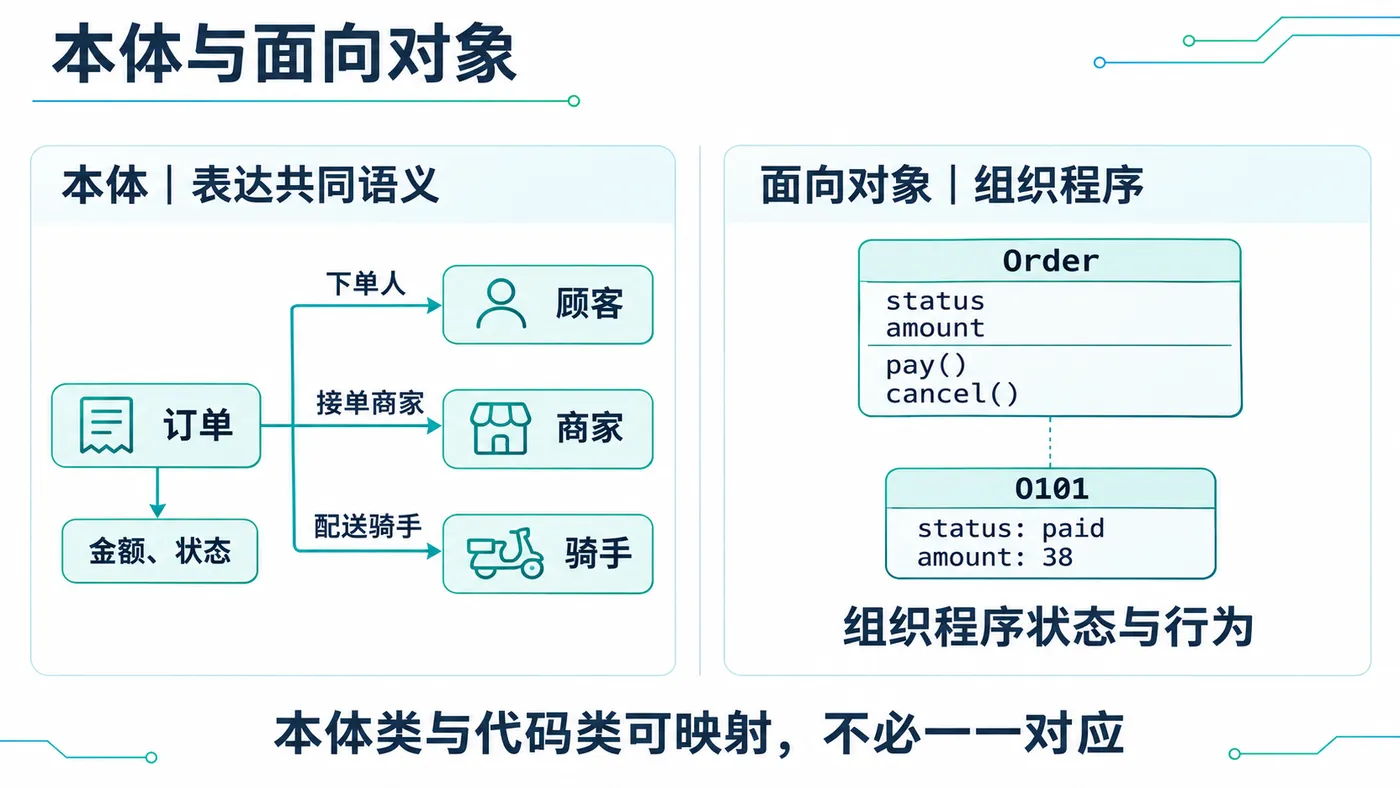
本体与面向对象思想也有相似之处。本体侧重表达“业务世界里的东西是什么、怎样关联”;面向对象侧重组织“程序中的对象保存什么状态、执行什么行为”。它们都能描述业务,但本体是一种知识模型,面向对象是一种编程范式。
比如,本体描述订单与顾客、商家、骑手的关系,以及订单金额、状态的含义;面向对象设计则可以定义一个 Order 类,用 status、amount 保存状态和金额,用 pay()、cancel() 组织支付、取消等行为。具体订单 O101 可以是这个类的一个实例,金额为 38 元,状态为已支付。
本体中的“订单”和代码里的 Order 可以建立映射,但不必一一对应;一个业务概念在程序中也可能由多个对象协作实现。
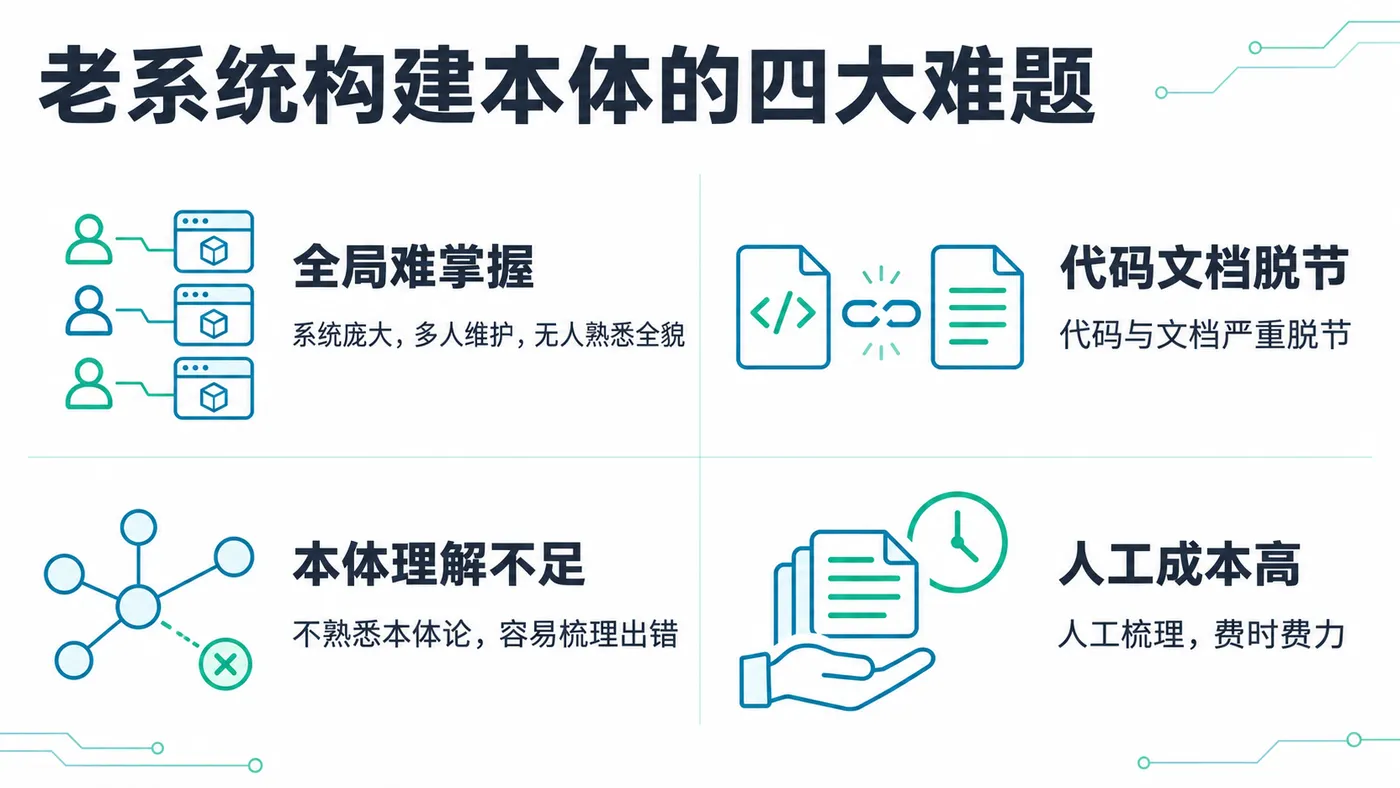
现在想给老系统梳理本体,往往会遇到几个问题:
- 系统太大,由多人维护,没有一个人熟悉所有模块。
- 代码和文档严重脱节。
- 负责的同学对本体论也不太熟悉,容易梳理出错。
- 靠人手动整理,费时费力。
那,该怎么办呢?
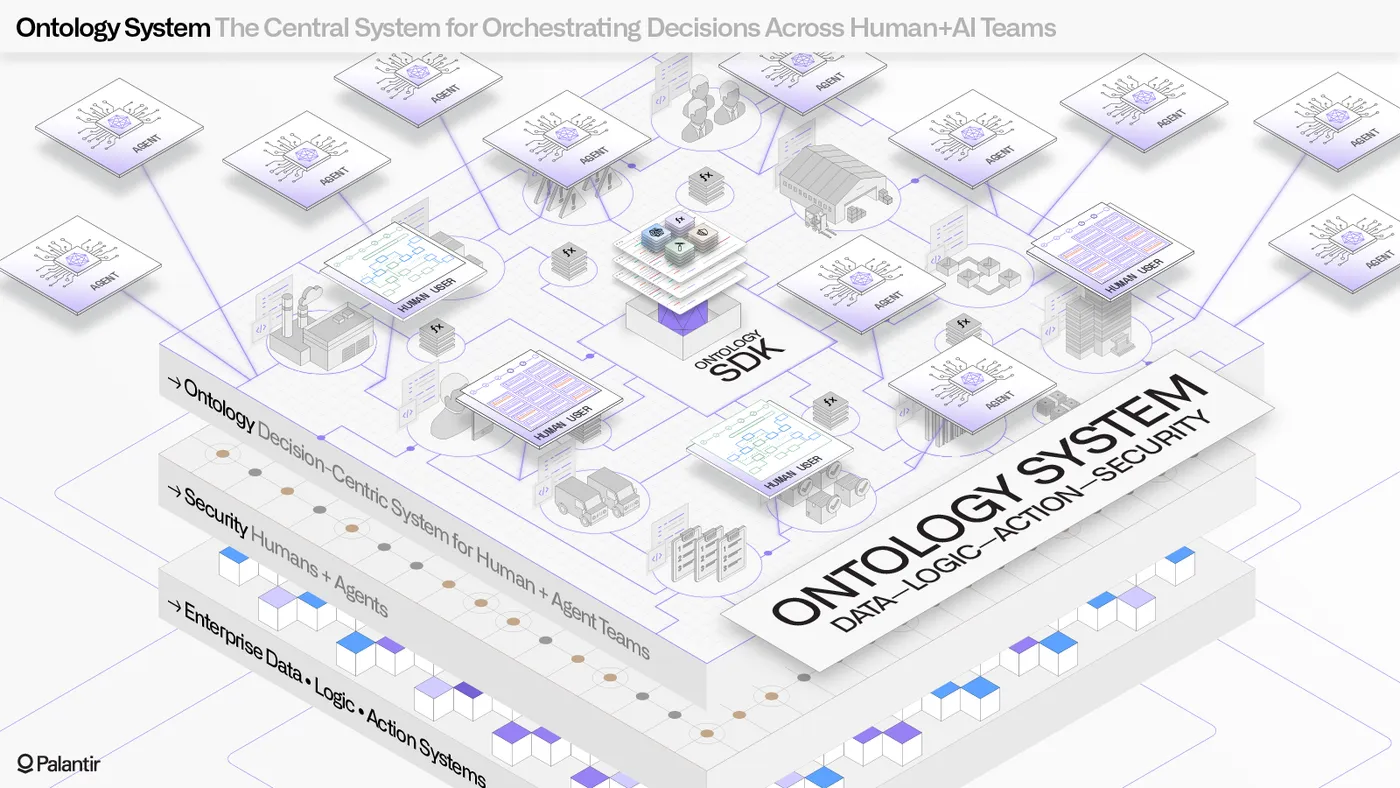
之前我在《不能被转成 Skill 的最佳实践,都只是过眼云烟》里就推荐过:把最佳实践封装成技能,让 Agent 帮我们干活。
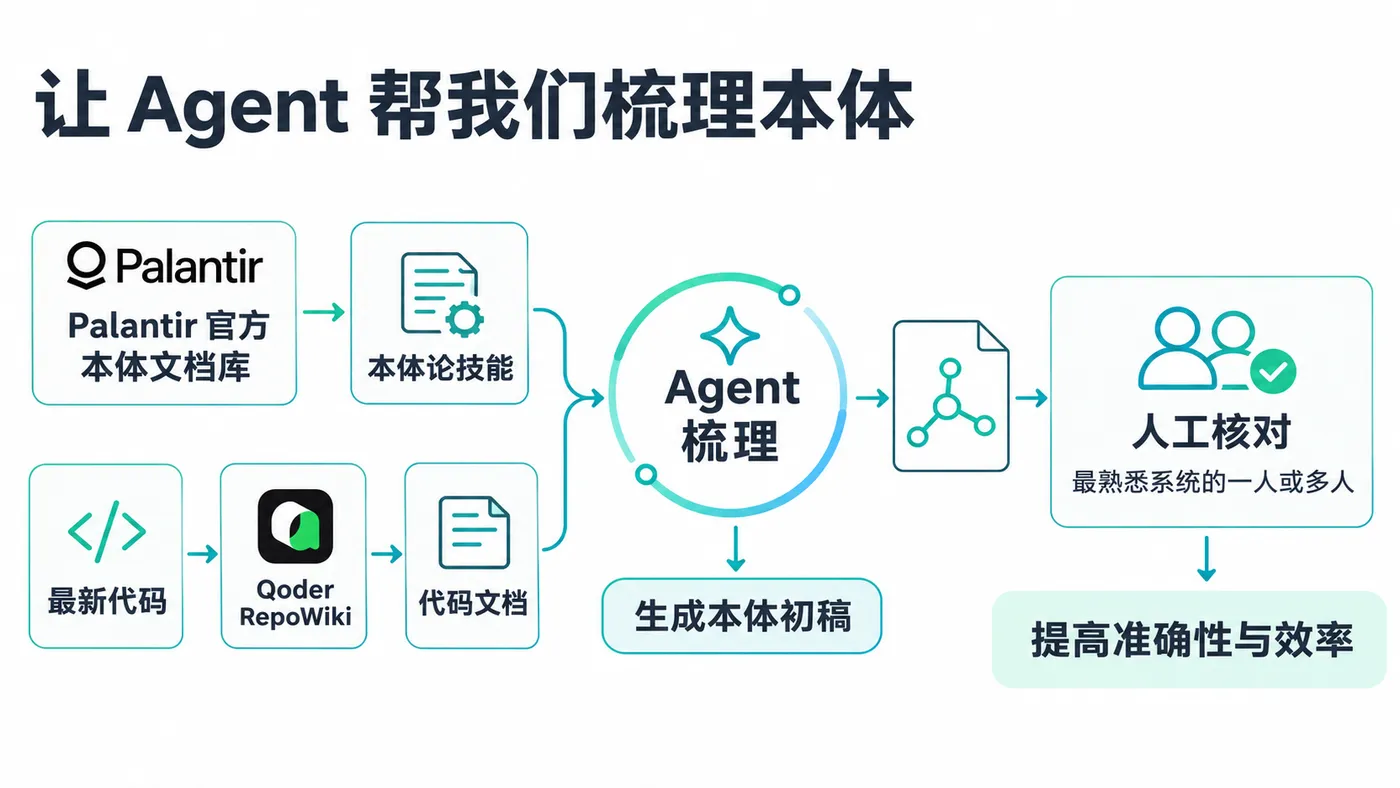
所以,我先把 Palantir 官方的本体文档整理成技能,让 Agent 参考这些文档,帮我们梳理本体。
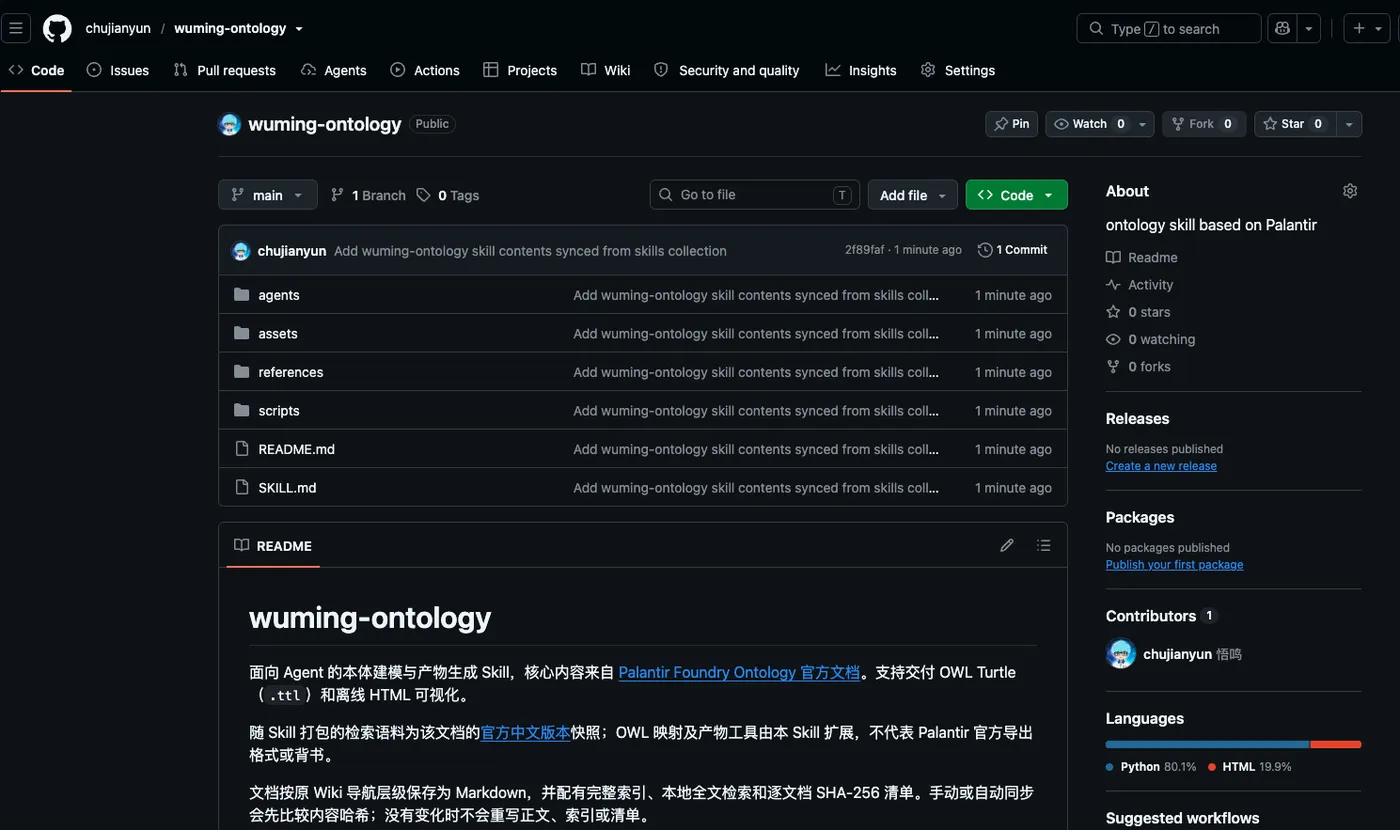
我也在此基础上做了优化和修改,开源在 GitHub 仓库中:chujianyun/wuming-ontology。
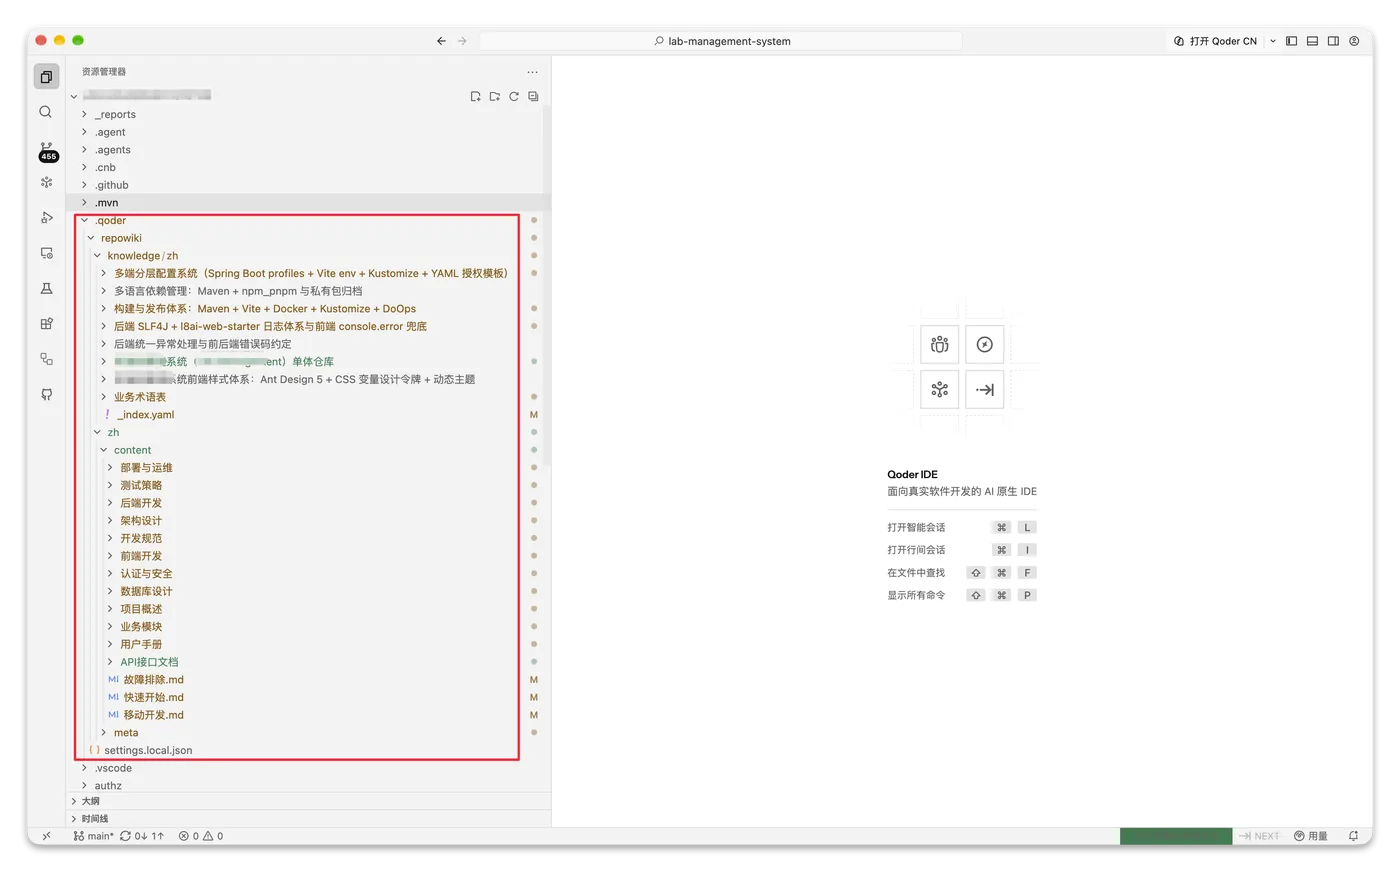
接着,通过 Qoder 的 RepoWiki 梳理现有代码,生成系统文档。
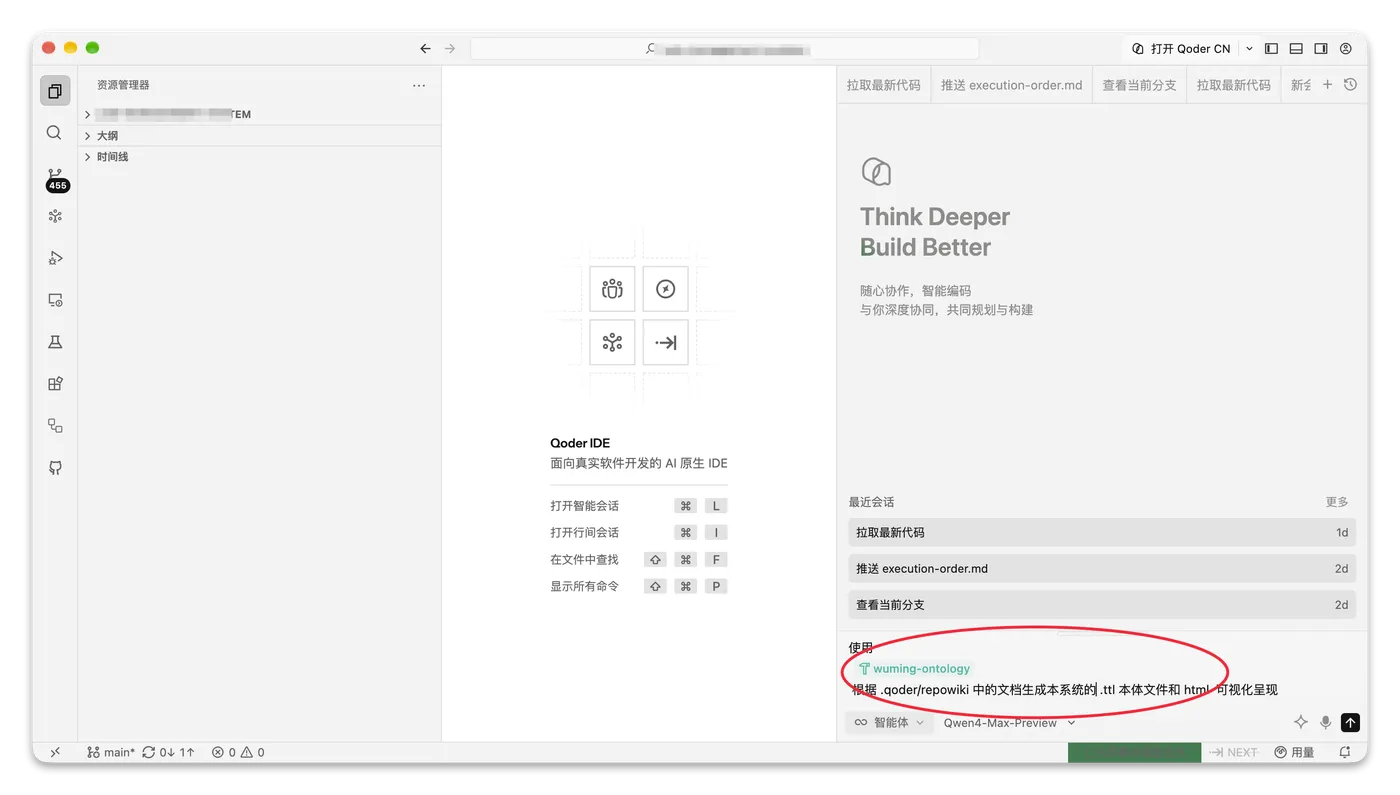
然后,让 Agent 结合本体论技能和 RepoWiki 文档,生成本体文件。
参考提示词:
使用 /wuming-ontology,根据 .qoder/repowiki 中的文档,生成本系统的 .ttl 本体文件和 HTML 可视化页面。
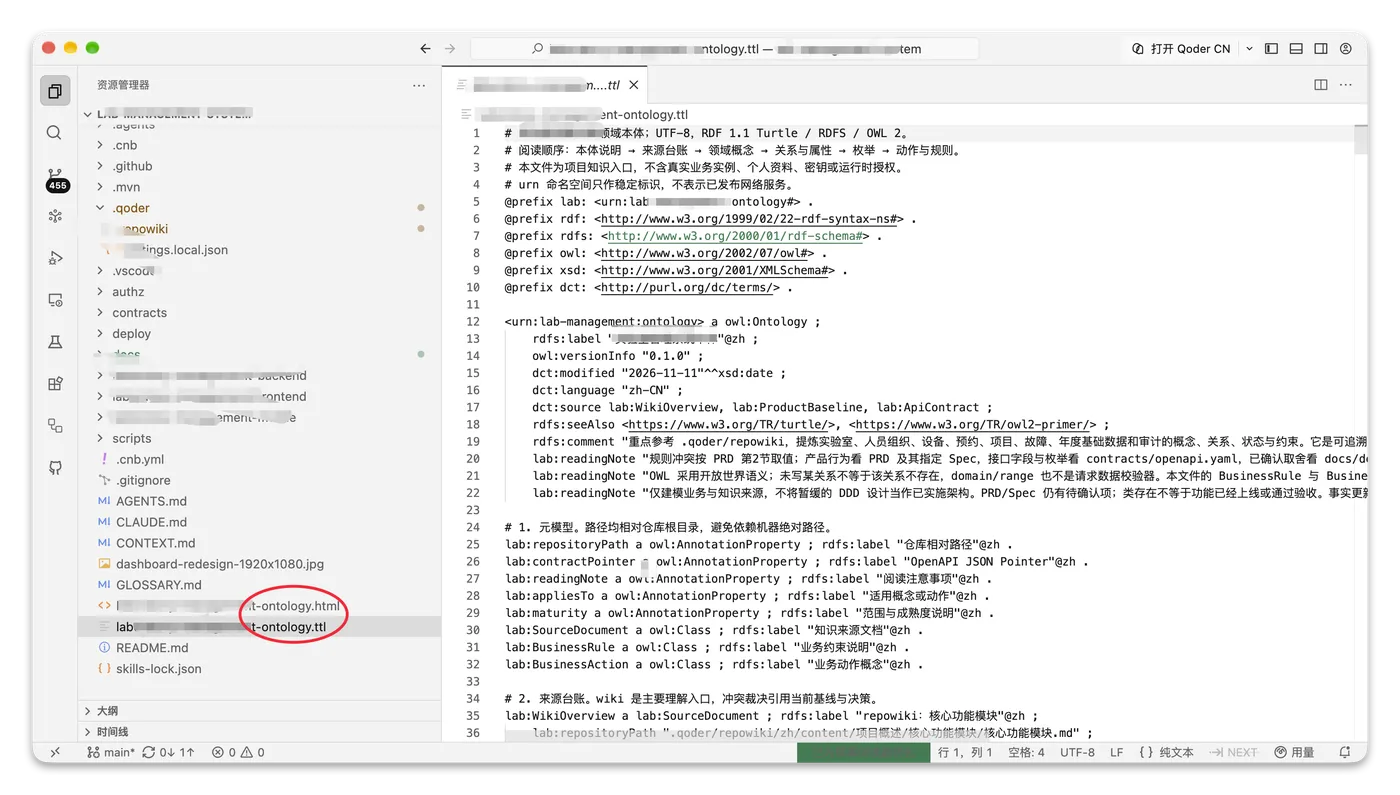
生成的 .ttl 文件,可以用 Protégé 打开和编辑。
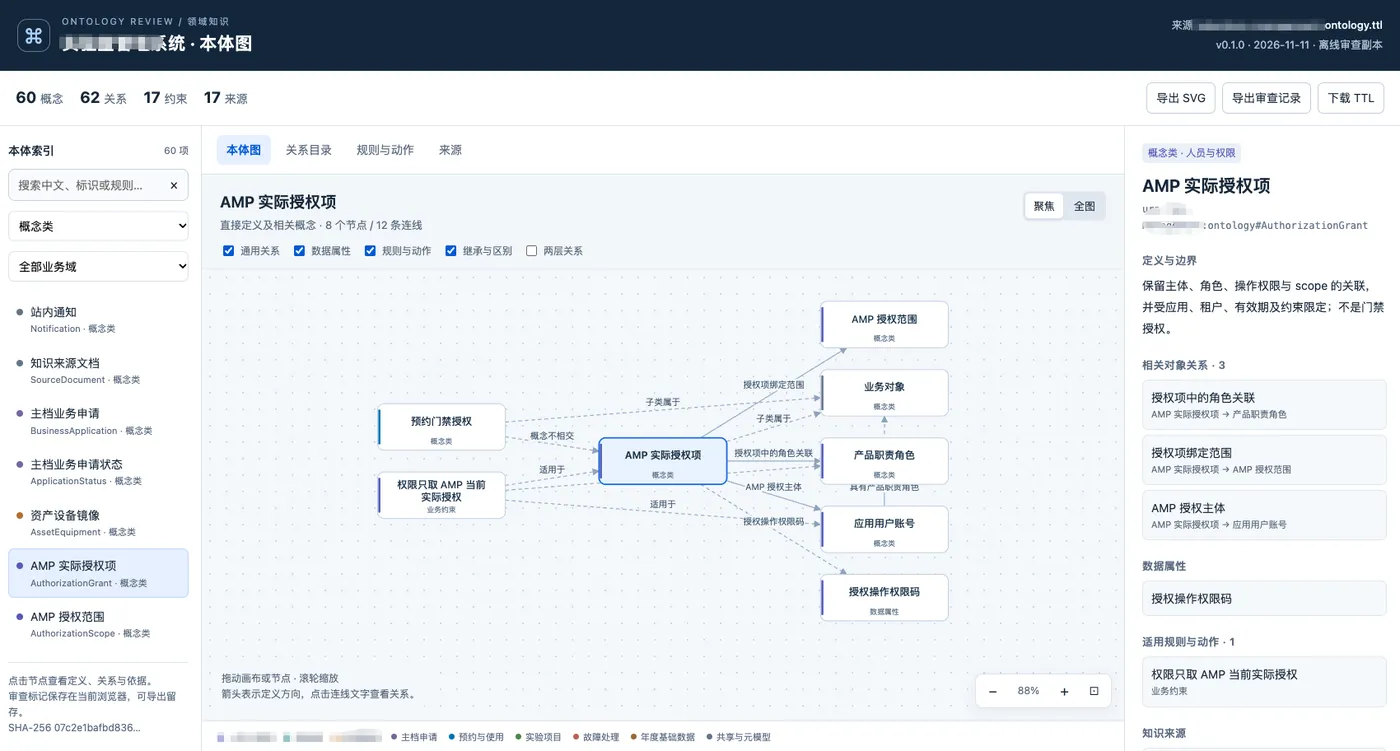
也可以直接打开技能生成的 HTML 页面,查看可视化结果。
最后,再请一位或几位熟悉系统的人核对本体,修正遗漏和误判。让 Agent 先整理、人再核对,有助于提高梳理效率和准确性。
至于最终用什么方式存储本体,简单就直接 .ttl 存储让 Agent 读就好了,可以根据实际情况选择,例如 Jena TDB2。
如果你也在梳理本体,暂时没有更好的办法,可以试试这套流程。对这个 Skill 有改进想法,也欢迎提交 PR,一起维护。
参考资料:
- Taxonomy vs. ontology vs. knowledge graph: What’s the difference?
- Qdrant: Payload
- Neo4j: Patterns
