上一篇《中文短文本相似度实测:字符 n-gram 的 n 该取几?》末尾留了个尾巴:把 embedding 余弦加进那张表,做三方对比。这篇是去接这件事的。
先把进度说清楚。字面侧我重做了一套 60 对样本,下面每个数都是脚本跑出来的,跑法在文末;语义侧给的是能直接跑的代码,没有跑数——这台机器上没有百炼的 Key,我不编数字。你填上 Key 跑一遍,会得到同一张表的第三行,列格式已经对齐。
一、换一套样本,先看尺子会不会翻
上一篇用的是 28 对,n=1 时 Dice 的可分性 0.1705。那套样本是边写边凑的,同义句挑得偏整齐。
这次重做 60 对:copy 10、same 20、partial 15、diff 15。四条判据不变——copy 组全为 1.0 是实现自检,区分度看 same 与 diff 的均值差,可分性看 same 的下沿与 diff 的上沿之间有没有空隙,空隙大于 0,才存在一个固定阈值把两类完全分开。
换样本不是为了数字好看,正好相反:我想看同一把尺子换一批句子会不会翻。
二、60 对的字面侧,四行结果
指标        n     copy    same partial    diff    区分度    可分性
jaccard     1   1.0000  0.2952  0.1204  0.0121   0.2831   0.0000
dice        1   1.0000  0.4409  0.2050  0.0231   0.4177   0.0000
jaccard     2   1.0000  0.1121  0.0452  0.0000   0.1121   0.0000
dice        2   1.0000  0.1929  0.0821  0.0000   0.1929   0.0000
两项和上一篇对得上:n 从 1 加到 2,区分度腰斩(Dice 0.4177 掉到 0.1929);同一个 n 下,Dice 高于 Jaccard,原因是 Dice 的分母比并集小,短文本上天然更宽松。
第三项不对。可分性四行全是 0.0000,上一篇在 n=1 时还有 0.1102 和 0.1705,这次是 0。
三、撞在 0.1000:阈值画不出来的地方
可分性为 0,不等于所有样本都分不开。它只说明一件事:存在一个同义样本,分数不高于某个无关样本。把边界上的两只挑出来就清楚了。

same 组垫底的一对,0.1000:
A 这段代码没有第三方依赖
B 这份脚本只用标准库
人读这两句是同义,换词换得干净。字面只重合一个“这”字,Dice(n=1) 是 2×1÷(11+9)=0.1000。
diff 组顶到上沿的一对,也是 0.1000:
A 人工问、脚本算,别自动抓
B 这周末打算去大鹏看海
这一对毫无关系,只碰巧共用了一个“算”字。
一个真同义,一个真无关,撞在同一个数上。阈值定 0.10,同义那对被判成不同;定 0.09,无关那对被判成相同。没有一个数能同时满足——这就是可分性 0 的具体含义,不是分数低,是这条线上没有空隙。
n 加到 2 也没救,只是换了个撞车点:那一对同义句连“这”都不算数了,跌到 0.0000;而 n=2 时 diff 组的上沿同样是 0.0000。撞车从 0.1 挪到 0,空隙还是 0。
四、另一个方向:反义句
字面尺子的失效不止“换词”一个方向。三组反义句,Dice(n=1) 分别算出来是:
0.9524  这个方案可行,下周上线/这个方案不可行,下周不上线
0.9231  这批货可以退/这批货不可以退
0.9091  他同意涨薪/他不同意涨薪
只多一个“不”字,字面重合度九成以上,意思完全相反。
这类句子在业务里不稀罕:能退与不能退、有货与没货、含税与不含税、可以改与不能改。字面分在这里不是不准,是方向错了——它测的是措辞重合,两个几乎一样的句子,措辞当然重合。
五、把语义分接进来,三段代码
语义侧要做的只有三件事:取向量、算余弦、把模型名和维度一起存进记录。调用走 OpenAI 兼容接口,标准库就够,不用装 SDK。
import json, os, urllib.request
EMB_URL = "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings"
def embed(texts, model="text-embedding-v4", dim=1024, batch=10, cache=None):
    key = os.environ.get("DASHSCOPE_API_KEY", "")
    cache = cache if cache is not None else {
   }
    todo = [t for t in dict.fromkeys(texts) if t not in cache]   # 去重,同句只算一次
    for i in range(0, len(todo), batch):
        body = json.dumps({
   "model": model, "input": todo[i:i + batch],
                           "dimensions": dim, "encoding_format": "float"}).encode()
        req = urllib.request.Request(EMB_URL, data=body, method="POST", headers={

            "Authorization": "Bearer " + key, "Content-Type": "application/json"})
        with urllib.request.urlopen(req, timeout=60) as r:
            data = json.loads(r.read().decode("utf-8"))
        for item in data["data"]:
            cache[todo[i + item["index"]]] = item["embedding"]
    return cache
三个细节别省。
一是 batch。 一次十条,60 对共 120 句,最多 12 次请求。
二是缓存。 字典按文本做键,同一句只算一次,重跑不加成本。样本多了以后这一条决定你能不能天天跑。
三是元数据。 model 和 dimensions 必须写进每条记录。换模型版本、改向量维度之后,旧分数和新分数不在同一个空间里,混着算就是假趋势。
余弦就是点积除以模长:
import math
def cosine(va, vb):
    dot = sum(x * y for x, y in zip(va, vb))
    na = math.sqrt(sum(x * x for x in va))
    nb = math.sqrt(sum(y * y for y in vb))
    return dot / (na * nb) if na and nb else 0.0
跑法:
export DASHSCOPE_API_KEY=sk-xxxx
python sim_vs_emb.py --embed --out out
summary.txt 会多出一行 embedding 的区分度与可分性,pairs_quadrant.csv 会多一列语义分,逐对并排。这一行我这边是空的,你跑完就有。模型名和维度以百炼控制台当天可用的为准,改了要同步写进元数据。
六、四个象限:哪些样本才值得上语义尺子
两列分数到手,每一对样本就落进四个格子里。
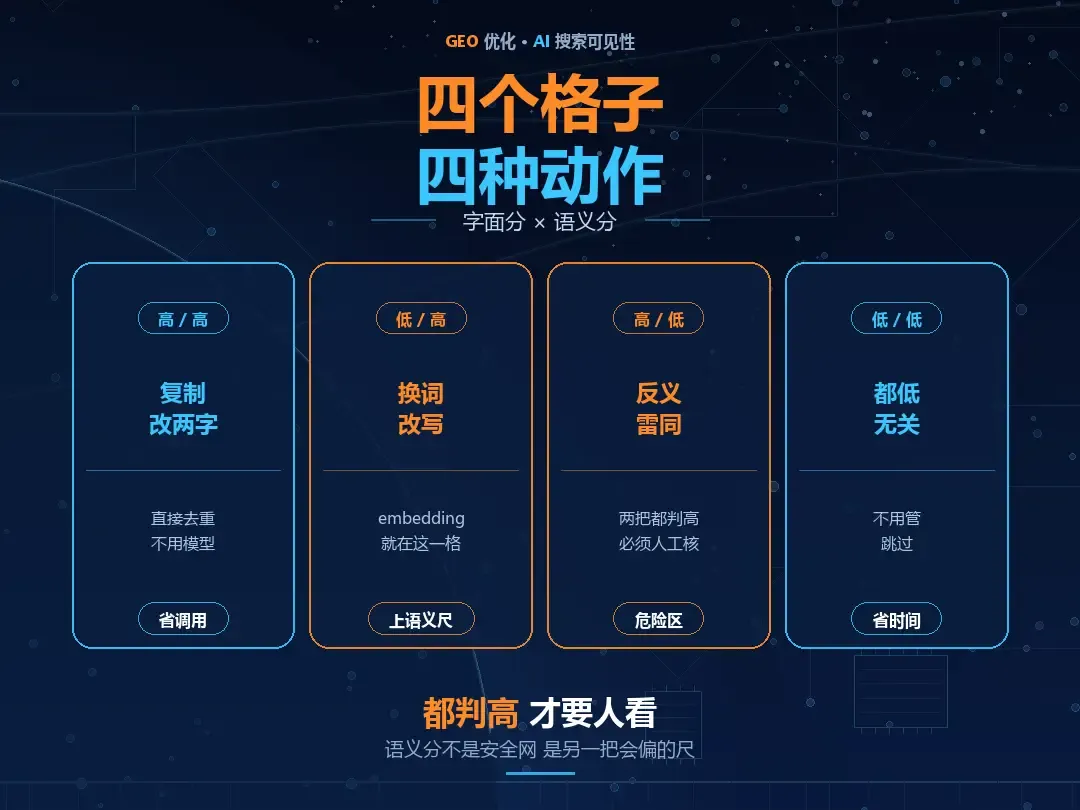
高 高 复制、改一两个字的样本。直接去重,不用模型。
低 高 换词改写的样本。这正是 embedding 的位置。
高 低 反义、术语雷同。危险区,必须人工兜。
低 低 无关样本。不用管。
第二格是上语义尺子的理由:同义改写天生不重合,字面分抓不到,语义分能抓到。
第三格是上语义尺子之后要额外提防的。反义句在向量空间里并不会自动分开——同一话题、同样的实体、同样的动作,只差一个否定,余弦往往还很高。语义分不是字面分的保险,它是另一把会偏的尺子,偏的方向恰好相反。
所以读完这四格,动作不是“哪个分高信哪个”,而是先看每个样本落在哪一格。两把尺子都判高的那一格,才是要人去核对的。
七、阈值只能在自己的语料上定
拿到表之后,三件事按顺序做。
一,用 copy 组锚上限。 全部 1.0 才算实现没写错。任何一个不是 1,先去查归一化、查切分、查有没有把全角半角混着处理,别急着调阈值。
二,用 diff 组定下限。 你的语料里无关样本的上界是多少,阈值必须高过它。别人的 0.8 没有意义:语料、模型、维度、归一化规则,任何一个不同,分布就变。
三,看 same 与 partial 之间有没有间隔。 间隔小于 0.05,把阈值卡在中间等于赌博,这时候宁可把这一档全部转人工,也不要硬定一个数出来。
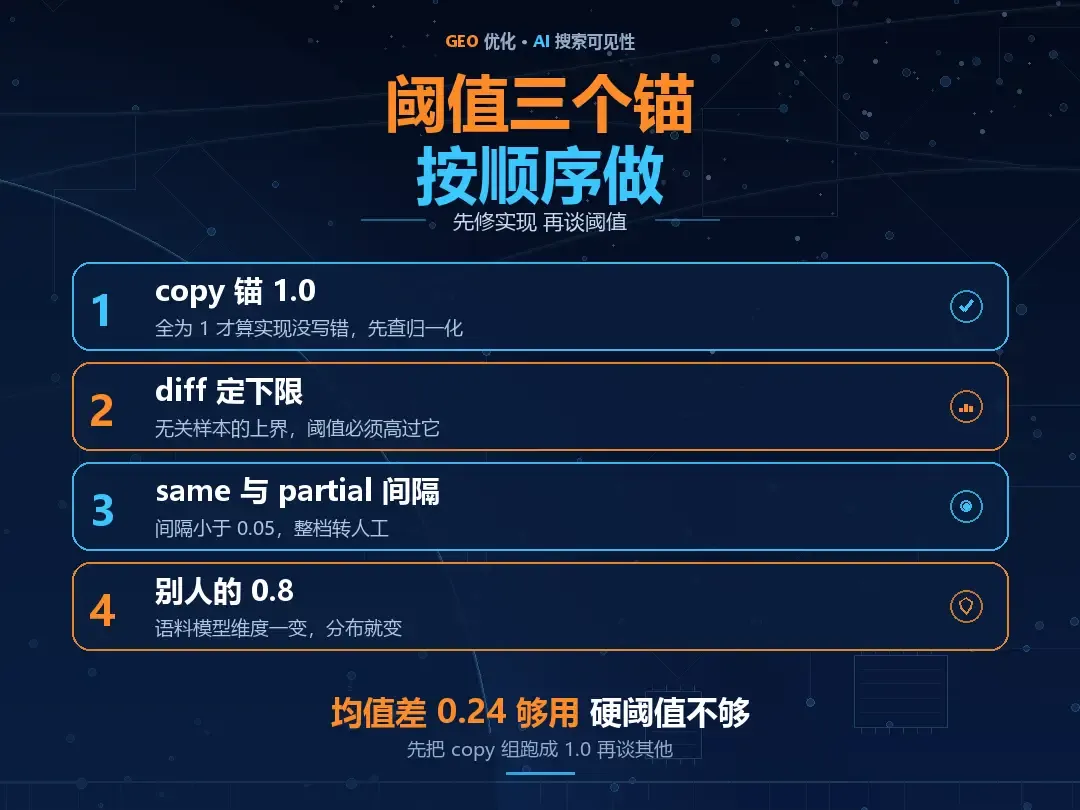
这次的数据里,same 与 partial 的均值差是 0.4409 减 0.2050,约 0.24,间隔是够的;真正卡死的是 same 的下沿与 diff 的上沿,两边都停在 0.1000。所以这套语料可以按均值排序做事,但不能指望一个硬阈值做全自动判定。
八、三条边界
模型版本会切断可比性。 百炼的 embedding 模型换版本、改维度,向量就不在同一个空间。历史数据想留着比,就得把 model 与 dimensions 当成数据的一部分存下来,跟时间戳一个级别。这一点和上一篇说 n-gram 的口径要先定死,是同一个道理。
短文本有天花板。 20 字以内的句子,embedding 也吃不满语义。缩写、方言、行业黑话——打样、翻台、走量、走单——掉分很常见。字面分在这些词上反而稳,因为字是实的。
相似不等于可替代。 分数只回答“像不像”,回答不了“能不能换着用”。反义句就是硬证据:0.9524 的那一对,一个字都不能互换。做去重、做聚合、做候选召回,用分数没问题;做“这条能不能替那条发出去”的判断,分数只能当线索。
九、小结
字面分的天花板不在参数上,在它测的东西上:它测措辞重合,而同义改写天生不重合。60 对样本里,同义下沿 0.1000 与无关上沿 0.1000 撞在一处,阈值画不出来。换 n、换 Jaccard 与 Dice,都只是把撞车点挪个位置。
embedding 补的是这一维,代价是另一维:它会把反义判得像。所以两把尺子要并排看,落到四个格子里再决定动作,而不是挑一个分数当答案。
这篇的字面侧是真跑的,语义侧留了代码。真跑出来那天,我会把表补全,包括我在第三格里猜错的地方。
附录:常见问题
问:没有百炼的 Key 能跑吗?
答:能跑一半。不加 --embed 只跑字面侧,内置 60 对,几秒钟出表。语义侧换成其他厂商的 embedding 接口也行,把 URL、模型名、维度三处改掉,其余不动。
问:那为什么不干脆只用 embedding,省掉字面分?
答:反义句和术语雷同这两类,字面分抓得住,embedding 容易糊过去。而且字面分便宜、可解释,能直接指出是哪几个字重合,排查问题靠它。
问:60 对够用吗?
答:够看方向,不够做显著性判断。四组各十几对,均值算得稳,边界样本会随样本量变——0.1000 那一对就是典型。要定生产阈值,至少几百对,而且得是你自己行业的语料。
让认真做事的人被看见
作者:GEO优化阿文
用 Python 做生成式引擎(GEO)检索实测,十二年实体门店运营经验。