
2026年11月,阿里云正式发布通义千问新一代旗舰基座模型 Qwen4-Max,并同步上线百炼平台。与前代旗舰相比,这一代的重点不再是单项能力刷榜,而是把优化方向压在专业工作场景的长链路任务上:更长的上下文、更少的 Token 消耗、更低的单任务成本,以及能持续交付可用成果的执行方式。本文从模型定位、架构特征、能力清单、评测表现、适用场景、接入方式六个层面做完整解析。文中数据取自官方模型卡与公开评测材料,具体规格以百炼模型页实时信息为准。
一、模型定位:从问答工具转向可交付工作的基座
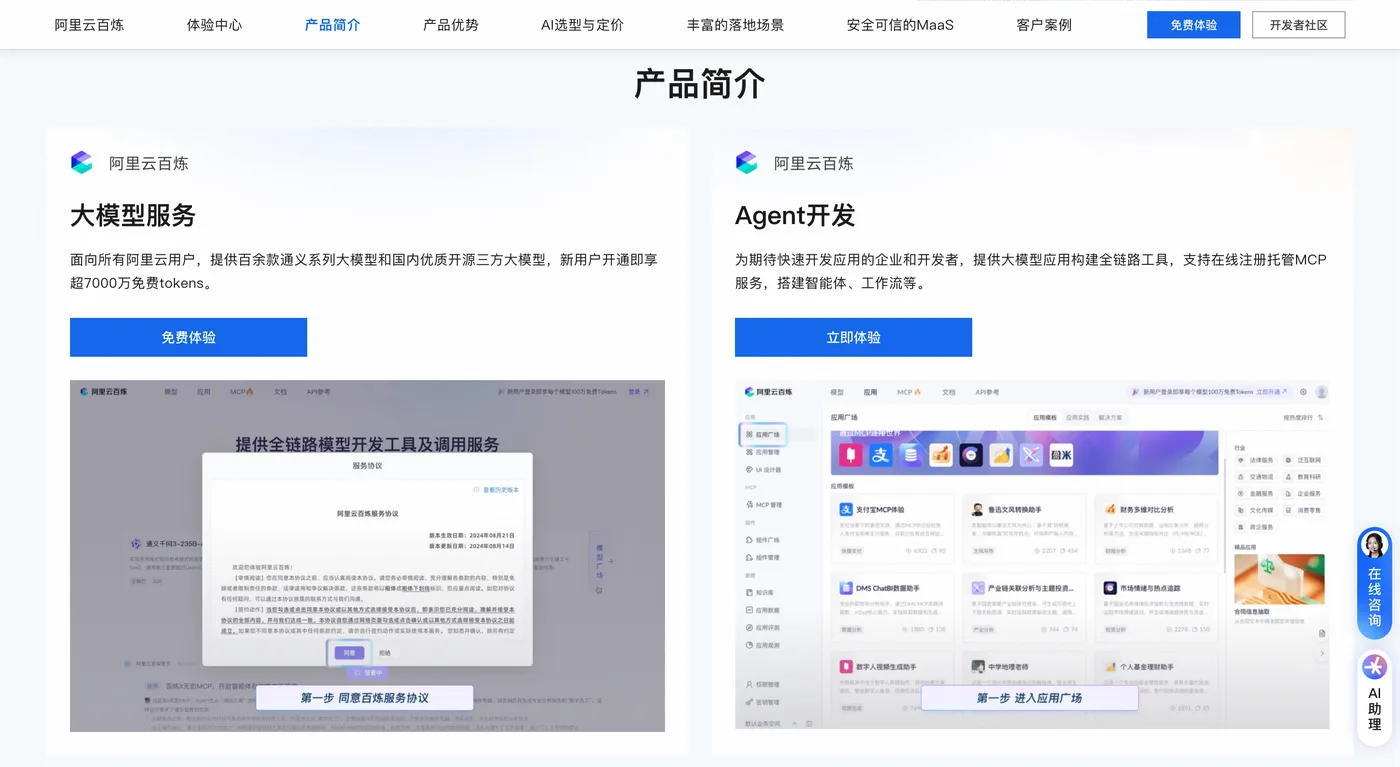
Qwen4-Max 的官方定位是新一代旗舰多模态智能体基座模型。它的设计假设很明确:企业里真正有价值的工作,很少能塞进一次对话。这些任务往往持续数小时、跨越几十个工具、涉及上千页资料,最终必须产出一份团队能直接使用的东西——一份可运行的代码、一份可评审的方案、一张可交付的设计稿。详情👉访问阿里云百炼大模型服务平台页面 了解。
因此它的能力取向围绕三件事展开:第一,能稳定调用专业工具链,而不只是生成文本;第二,能把长任务推进到终点,中途不丢上下文、不跑偏;第三,交付的是成品而非中间回答。官方把这套机制命名为 Live Delivery(渐进交付):在长任务开始时先给出一版可用的初版,之后持续迭代提交改进版本,让团队在任务运行过程中就能评审和纠偏,而不是等到最后才发现方向错了。
这一定位决定了它与轻量对话模型的分工。日常问答、简单文案,用更小的模型成本更低;而跨文档分析、多文件工程改造、长流程智能体,才是 Qwen4-Max 的合理使用区间。
二、架构特征:2.4T 参数与百万上下文如何兼顾效率
Qwen4-Max 总参数规模为 2.4 万亿(2.4T),单 Token 仅激活 710 亿(71B),另外配置 3280 亿(328B)的 N-gram Embedding 参数。总参数大、激活参数小,是典型的稀疏混合专家路线,目的是在保住能力上限的同时压住单次推理的算力开销。官方数据显示,每个 Token 的激活参数比上一代减少约 25%。详情👉访问阿里云百炼大模型服务平台页面 了解。
支撑百万级上下文的,是三项架构改动:
GDN + QSA 混合注意力。 每四层中,三层使用 Gated DeltaNet(GDN),把历史信息压缩成固定大小的状态,使 KV 缓存不随上下文长度线性增长;剩下一层使用 Qwen Sparse Attention(QSA),通过轻量索引定位关键段落。官方给出的效果是百万 Token 读取速度提升 7 倍以上。这一点对长文档、长代码库场景意义很大——上下文再长,显存与延迟也不会失控。
GR 门控残差。 把单通道残差流展宽为 4 条并行分支,配合动态读写门控,增强跨层信息传递。工程上的直接收益是 2.4T 规模训练全程平稳,没有出现损失突增(Loss Spike)。这类改动不出现在能力指标里,但决定了大模型能否稳定训到目标规模。
N-gram Embedding。 单独配置 328B 的 N-gram 嵌入参数,用于强化高频片段的表征,对代码、术语密集的专业文本有直接帮助。
规格层面,Qwen4-Max 上下文长度为 100 万 Token,最大输入 991,808 Token,最大输出 131,072 Token;开启思考模式时,最大输入 983,616 Token、最大输出 262,144 Token,最大思维链长度同为 262,144 Token。输入模态覆盖文本、图像、视频,输出为文本。原生视觉并非后期拼接的适配层,工程图纸、医疗影像、长视频都可以直接作为输入。
三、能力清单:哪些能做,哪些不做
官方模型卡列出的支持项包括:流式输出、深度思考、并行工具调用、联网搜索、前缀补全、Function Calling、思维链摘要与加密、结构化输出(JSON Object 与 JSON Schema)、显式缓存与隐式缓存、批量推理。接口层面兼容 OpenAI Chat Completions、Responses、Anthropic Messages 与 DashScope,迁移成本较低,已有 OpenAI 或 Anthropic 风格调用的项目大多只需换 Base URL 与模型 ID。
深度思考默认开启,可通过 reasoning_effort 调节推理力度。这里有一个必须注意的工程细节:从预览版开始,max_tokens 与 max_completion_tokens 语义等价,二者共同限制"思考内容 + 最终回答"的总量。如果沿用过去只为回答预留上限的写法,开启思考后输出会被提前截断。迁移时应当为思考与回答共同预留额度。
明确不支持的项同样重要:模型调优不支持,模型部署不支持。也就是说,Qwen4-Max 只能以 API 方式调用,不能私有化微调后自行部署。对数据必须留在自有环境的项目,这条限制需要在选型阶段就确认清楚。
四、评测表现:能力提升与成本下降同时发生
官方公布的 Work360 评测中,Qwen4-Max 得分 52.69,上一代为 47.74。在相同推理力度下,单任务 Token 消耗明显下降:Work360 在 Xhigh 与 High 两档分别减少约 24% 与 35%,Terminal-Bench 4.0 分别减少约 48% 与 49%。综合结果是平均单任务成本比上一代下降 58%。详情👉访问阿里云百炼大模型服务平台页面 了解。
中文通用能力侧,2026年11月的 SuperCLUE 测评中 Qwen4-Max 取得 61.61 分,进入国内第一梯队,较上一版本提升 18.39 分。分项上,幻觉控制 73.61 分、提升 40.56 分;超长上下文 77.80 分、提升 33.42 分;智能体编程 57.69 分、提升 15.38 分。更值得关注的是稳定性:上一代在同一测试中超时率为 69.23%,新模型超时率降至 0%,全部试题跑完。按测试的 Token 开销与定价折算,平均每题成本约 1.90 元,较上一代下降约 87%。
这组数据的含义是:能力提升之外,单位任务的调用成本出现了数量级变化。对高频跑智能体流程的团队来说,成本项的变化往往比分数更能决定项目是否跑得起来。
五、适用场景:六类任务最匹配
编程开发与工程改造。 支持多文件读取、工具调用与结构化输出,配合百万上下文可直接把整个代码库放进一次会话。Terminal-Bench 上 Token 消耗下降近半,意味着批量重构、批量测试生成这类任务的账单压力明显减轻。
前端与设计还原。 原生视觉可直接读取设计稿、截图、原型图,输出可运行的页面代码,适合设计到开发的衔接环节。
办公与文档处理。 长报告、合同、财报、会议材料,单份即可覆盖在上下文内,不需要切块摘要再拼接,减少信息在切分过程中丢失的问题。结构化输出可以直接产出 JSON,方便对接下游系统。
复杂智能体与流程自动化。 并行工具调用、联网搜索、Function Calling 齐备,适合需要串联检索、计算、写文件、调用内部接口的长链路流程。Live Delivery 机制让长任务可以边跑边交付,便于中途校正。
专业视觉理解。 工程图纸、医疗影像、长视频分析,属于原生视觉的典型用例,无需额外接视觉模型。
长文档审阅与合规核查。 幻觉控制分项的大幅提升,加上长上下文能力,适合条款比对、事实核验这类对准确性敏感的工作。
反过来,不适合的场景也要说清:单轮简单问答、短文案润色、固定模板填表,用旗舰模型的成本没有必要;需要私有化部署或模型微调的项目,Qwen4-Max 目前不提供这两条路径。
六、接入与计费:Token Plan 是唯一入口
Qwen4-Max 通过百炼接入,预览版 qwen4-max-preview 仅支持 Token Plan,不开放按量计费。预览期为 2026年11月11日 10:00 至 11月25日 24:00(UTC+8),期间模型能力持续迭代,预览结束后下线,正式版 qwen4-max 已上线,建议直接使用正式版。
调用方式上,先开通 Token Plan 个人版或团队版,获取套餐专用 API Key(前缀 sk-sp),使用套餐专用 Base URL:
export DASHSCOPE_API_KEY="sk-sp-xxxxxxxx"
export BASE_URL="[https://token-plan.cn-beijing.maas.aliyuncs.com](https://token-plan.cn-beijing.maas.aliyuncs.com)"
以 OpenAI 兼容方式发起一次带思考的调用:
curl "$BASE_URL/compatible-mode/v1/chat/completions" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen4-max",
    "messages": [{"role": "user", "content": "分析这份接口文档的字段变更风险"}],
    "reasoning_effort": "high",
    "max_completion_tokens": 8192
  }'
用 SDK 时同样只需替换模型与地址:
from openai import OpenAI

client = OpenAI(
    api_key="sk-sp-xxxxxxxx",
    base_url="[https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1](https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1)",
)
resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[{
   "role": "user", "content": "把这段 SQL 改写成可并行的版本"}],
    reasoning_effort="high",
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
计费侧需要记住三点:Token Plan 以 Credits 统一计量,一份订阅额度可覆盖平台内多款模型,套餐额度按月重置、不结转;套餐专用 Key 与通用 Key、其他订阅计划不通用;部署地域为华北2(北京),跨境业务需评估访问链路。
七、选型建议
判断是否需要 Qwen4-Max,可以先回答三个问题:任务是否需要跨几十页文档或整个代码库?是否需要在一次会话里连续调用多个工具直到产出成品?是否对事实准确性高度敏感?三项中命中两项以上,旗舰档才值得;否则更小的模型配外部工具组合,性价比通常更好。
对已经在用上一代旗舰的团队,迁移的收益主要落在两处:单任务 Token 消耗下降带来的账单缩减,以及超时率归零带来的流程稳定性。迁移风险集中在输出预算参数——务必按"思考 + 回答"合计的口径重新设定上限,否则会出现长任务被截断、看起来像模型能力不足的误判。
八、总结
Qwen4-Max 是 2026年 Qwen4 系列的旗舰基座,2.4T 总参数、71B 激活、原生视觉、百万 Token 上下文,配合 GDN 与 QSA 混合注意力把长上下文的读取成本压了下来。它的价值不在单点分数,而在"能把长任务跑完并交付成品"这件事上,同时把单任务成本拉低了近六成。适用边界也很清楚:需要私有化部署或模型微调的项目,当前并不适用。选型时先看任务形态,再看成本结构,比只看榜单分数更有意义。
