专注于 Infra 层的 AI Agent 技能平台——龙蜥社区 SkillHub 已收到数百个技能,当前陆续上线中。我们每周也会收到一些技能的最佳实践分享,本期给大家推荐的是壁仞科技贡献的《Biren Driver Management Tools》Skill ,他们将整套壁仞科技驱动运维能力封装为标准化AI技能,对接 SUPACODE™、Claude Code 等 AI Agent。本文结合一线落地踩坑经验、标准化调试流程,聊聊 AI 技能如何重塑 GPU 运维工作流。以下是他们的实战分享:
一次 GPU Hang,改变了我的排障方式
这次排障是我印象最深的一单,也是我真正确信“AI 技能改变了我的工作方式”的转折点。
那是一个周二晚上,在实验平台上的回归任务突然卡死:任务进程不退出、不报错,GPU 上的 context 清不掉,kill -9 之后进程还挂在 D 状态。放在以前,我的第一反应是翻聊天记录、找上次遇到类似问题的老同事,或者凭记忆敲一堆命令碰运气。这次我直接打开 Claude Code,对它说:“当前平台疑似 GPU hang,任务进程无法退出。按标准流程排查,给我每一步的命令、输出和结论。”
有意思的是,Agent 上手第一条命令就踩了个小坑——按技能文档里的写法敲 brsmi gpu list,brsmi 直接报错“argument not expected”。这恰恰是静态文档和 AI 技能的本质区别:Agent 并没有卡住,而是立刻读了一遍 brsmi -h,发现我们这套 GPU Driver 2.0.0 用的是顶层参数风格,自动把命令改写成了 brsmi -L,后面全程再没错过。这种“先看版本、再适配命令”的行为,以前只有老运维才会做。
命令零散、流程因人而异,经验如何沉淀
智算与芯片验证集群中,壁仞科技 GPU 环境预检、SVI 切分、硬件故障定位、DCGM 监控是常态化工作。过去运维人员需要记忆大量 brsmi、br-dcgmi 命令,故障排查流程因人而异、经验难以沉淀。
这套 AI Skill 如何统一 GPU 调试流程
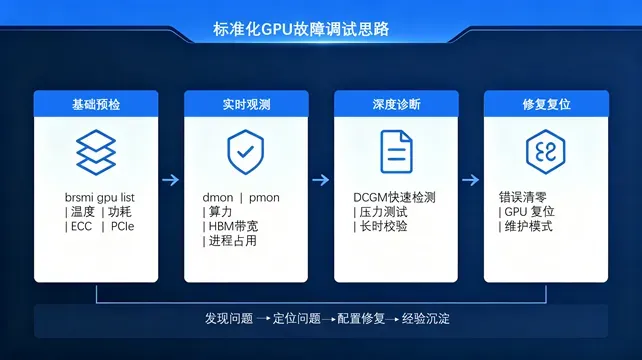
以往故障排查依赖个人经验,操作碎片化。借助这套技能,我们沉淀统一四层排查流程,新人也可以标准化定位问题:
基础快速预检(1 分钟)
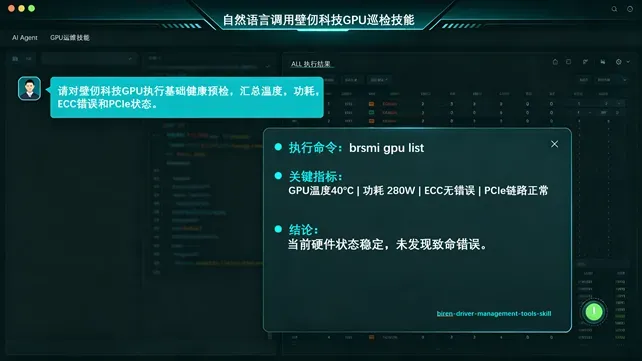
一键执行 brsmi gpu list,批量采集温度、功耗、显存、PCIe 状态、ECC 报错,快速区分软件环境问题还是硬件异常。
实时动态指标观测
利用 dmon/pmon 持续采样算力、HBM 带宽、进程占用,定位算力波动、任务卡顿诱因。
DCGM 分级深度诊断
根据故障等级选择快速检测、压力测试、长时间内存校验,自动输出结构化诊断报告。
环境复位与配置修复
支持 SVI 多实例切分、错误计数清零、GPU 硬件复位、维护模式隔离,形成“发现问题-定位根因-修复复位”闭环。
回到那次 GPU Hang,完整排查记录如下
第一步:1 分钟预检,先判断“软硬”
【实机采集】设备枚举:
$brsmi-LGPU0,BusId:00000000:00:00.0-GPUHW[0]BIRENGPU(UUID:GPU-00000000000),PhysicalSlot:4复制
设备还在枚举,说明 KMD 没有完全失联——这是个好消息,至少不需要先走“重启大法”,接着批量采集关键指标。
【故障还原】故障时点查询:
$brsmi--query-gpu=index,name,temperature.gpu,power.usage,memory.used,utilization.gpu--format=csvindex,name,temperature.gpu[C],power.usage[W],memory.used[MiB],utilization.gpu[%]0,BIRENGPU,0C,0.00W,151552MiB,N/A%复制
参数解读(这也是 Agent 当场给我解释的):
- temperature.gpu0C/power.usage0.00W:在验证平台上这是正常现象——仿真环境没有真实的温功耗传感器,读数恒为 0。新人到这一步经常误判“传感器坏了”,这是我们踩过的坑;
- memory.used151552MiB:显存几乎占满,说明 Hang 掉的仿真任务 context 还残留在设备上;
- utilization.gpuN/A:关键异常信号。正常状态下哪怕是空闲也应返回数值,N/A意味着 KMD 对计算队列的查询已经超时,驱动层大概率 Hang了。
到这里,软件环境问题基本排除,方向转向硬件/固件层。
第二步:查 XID 错误码和 PCIe 链路健康
【实机采集】本机当前状态(干净基线,供对比):
$ brsmi xidGPU 0: BIREN GPU (UUID: 00000000000) No Xid Found.复制
【故障还原】故障当晚的输出:
$ brsmi xidGPU 0: BIREN GPU (UUID: 00000000000)XID 79 : GPU channel error, KMD worker timeout detected at 2026/10/14 21:47:33复制
XID 是驱动记录的硬件/驱动级错误事件,KMD worker timeout 直接印证了驱动 Hang 的判断,继续查 PCIe 错误计数。
【故障时 PCIe 故障统计】:
$ brsmi pci -i 0 -gErrCntGPU 0: BIREN GPU (UUID: 00000000000) REPLAY_COUNTER: 33 REPLAY_ROLLOVER_COUNTER: 0 L0_TO_RECOVERY_COUNTER: 147 CORRECTABLE_ERRORS: 56 NAKS_RECEIVED: 0 RECEIVER_ERROR: 4 BAD_TLP: 12 NON_FATAL_ERROR: 0 FATAL_ERROR: 2复制
参数解读:
- L0_TO_RECOVERY_COUNTER:147:链路从正常工作态(L0)进入Recovery状态的次数。健康链路这个值长期为 0——作为对照,我事后在修复的同型号机器上采样,这个计数是 0。147 意味着链路在反复重训练,信号质量或链路两端状态有问题;
- REPLAY_COUNTER:33/BAD_TLP:12:数据包重传和坏TLP(事务层包)计数,与链路频繁 Recovery 互相印证——链路在丢包、重传,才会走到Recovery;
- FATAL_ERROR:2:出现了 2 次不可修复的 PCIe 致命错误。这是硬伤,不是偶发抖动;
- ECC那边(ecc.errors.uncorrected.volatile.total)查出来是0,显存没有问题——矛盾点集中收窄到链路和固件侧。
顺带一提:这个字段名也是 Agent 自己查 brsmi--help-query-gpu 对齐出来的。不同驱动版本的查询字段写法不一样(老文档里的 ecc.error.double 在 2.0.0 里已经叫 ecc.errors.uncorrected.volatile.total),Agent 每次都会先读 help 再组命令,这个细节让我很放心。
第三步:dmon持续观测,确认故障是“进行中”还是“过去时”
【实机采集】本机健康基线的 dmon 真实输出(能看到列头格式):
$ brsmi dmon -s pucvmet -d 2 -c 3 -o DT # Date Time gpu pwr gtemp mtemp ... sbecc dbecc pci rxpci txpci 20261020 14:59:47 0 0 0 0 ... 0 0 0 0 0 20261020 14:59:50 0 0 0 0 ... 0 0 0 0 0 20261020 14:59:52 0 0 0 0 ... 0 0 0 0 0复制
【故障还原】故障当晚我用同样的参数盯着观测:
$ brsmi dmon -s pucvmet -d 2 -c 10 -o DT -f /var/log/gpu_check/dmon_gpu0_20261014.log复制
-s pucvmet 表示采集功耗温度(p)、利用率(u)、频率(c)、违例(v)、显存(m)、ECC/PCIe 重传(e)、PCIe 吞吐(t);-d 2 -c 10 是 2 秒采样 10 次;-o DT 带日期时间戳;-f 落盘留档,供事后回溯。观测期间 sbecc / dbecc / pci errs 三列没有继续增长,L0_TO_RECOVERY 也不再攀升——说明链路故障是一次性事件,当前处于 Hang 残留状态,而不是持续恶化的硬件损坏。这一步帮我们排除了“显卡快坏了、赶紧下线换卡”的误操作路线,避免了不必要的服务器下线。
第四步:DCGM 分级诊断,锁定根因
brsmi 只能读“静止”的错误计数,要确认硬件当前是否真的还能正常承压,得靠 DCGM 做受控压力检测。br-dcgmi 部署在我们的诊断节点上,启动中型诊断(约 2 分钟):
【故障还原】(诊断节点原始输出节选):
$ br-dcgmi diag -r 2 -vRunning diagnostics at level 2 (Medium)GPU 0 (UUID: GPU-78403353736) Hardware Class : BIREN GPU Hardware Model : N/A GPU Performance State : P0 SVI Mode : Disabled Test: PCIe Bandwidth Result: PASS (12.4 GB/s) Test: PCIe Error Check Result: FAIL Error: Detected 2 fatal PCIe errors. Link recovery count 147. Test: Memory Short Result: PASS Test: SPC Stress Result: WARN - clock throttling observed during SVI context switch Overall Result: FAIL (2 errors, 1 warning)复制
诊断报告里两条线索:一是 PCIe 致命错误确认为真(和 brsmi 读到的 FATAL_ERROR: 2 完全对上);二是 SPC 压力测试在 SVI 上下文切换时观察到时钟异常 WARN。这个 WARN 单看毫不起眼,但和 XID 79 的发生时序一拼——Hang 发生在验证任务异常退出、触发 SVI 状态切换的瞬间——链路就通了,再看当前配置。
【实机采集】配置查询(本机采集,字段名与故障机一致):
$brsmi --query-gpu=index,kmd_version,pstate,persistence_mode,compute_mode,svi.mode.current,svi.mode.pending --format=csvindex, kmd_version, pstate, persistence_mode, compute_mode, svi.mode.current, svi.mode.pending0, 2.0.0, P0, Enabled, Default, Disabled, Disabled复制
根因结论:这批验证平台的固件与 KMD 2.0.0 在某些 SVI 状态切换路径上存在兼容缺陷——验证任务异常退出时触发了一次异常的 SVI 上下文切换,导致 PCIe 链路进入致命错误状态、KMD worker 超时 Hang。此前另一套验证环境升级固件后同款问题消失,反向印证了这一判断。
第五步:复位与验证,形成闭环
确认根因后,修复动作三步走:
# 清零PCIe错误计数,便于观察是否复发$ sudo brsmi pci -i 0 -cErrCnt# GPU硬件复位,释放残留context$ sudo brsmi -r -i 0复制
复位后重新预检验证(【故障还原】修复后):
$ brsmi --query-gpu=index,name,temperature.gpu,power.usage,memory.used,utilization.gpu --format=csvindex, name, temperature.gpu [C], power.usage [W], memory.used [MiB], utilization.gpu [%]0, BIREN GPU, 0 C, 0.00 W, 144 MiB, N/A %复制
memory.used 从 151552 MiB 回落到 144 MiB(驱动保留的基本占用),残留 context 已释放。重跑回归任务,通过。当晚持续观察 brsmi pci -i 0 -gErrCnt,FATAL_ERROR 保持 0,问题闭环。
【实机采集】我写这篇稿子时,又在同型号的健康机器上完整复验了一遍这套流程,当前基线全绿,可以直接当对比样板:
$ brsmi --query-gpu=index,ecc.errors.uncorrected.volatile.total,pcie.link.gen.current,pcie.link.width.current,memory.total --format=csvindex, ecc.errors.uncorrected.volatile.total, pcie.link.gen.current, pcie.link.width.current, memory.total [MiB]0, 0, 5, 16x, 32000 MiB$ brsmi pci -i 0 -gErrCnt | grep -E "FATAL|RECOVERY" L0_TO_RECOVERY_COUNTER: 0 FATAL_ERROR: 0复制
这次排障,让我看到了什么变化
这次排障全程约 3 分钟便定位到根因,而按照我过去翻聊天记录、逐条手敲命令、对照手册查字段含义的方式,同类问题平均需要 20~40 分钟,还得看运气。不过,最让我印象深刻的并不是“命令跑得快”,而是 Agent 会对每一行输出给出参数解读,从“L0_TO_RECOVERY 147 意味着什么”到“为什么验证平台温度读 0 是正常的”,让过去只存在于老运维脑子里的经验变得随取随用。更实际的是,面对不同驱动版本的字段和语法差异,例如 driver_version与kmd_version、brsmi gpu list 与 brsmi -L,Agent 会读取 brsmi -h 和 --help-query-gpu,适配当前版本后再组装命令。
这次技能文档中的子命令写法与实机 KMD 2.0.0 不一致,ECC 字段名也对不上,Agent 却能全程自动纠偏,无须人工干预,这是纯静态文档难以提供的体验。同时,“预检→动态观测→分级诊断→复位验证”的排障逻辑被固化在技能文档中,新人沿着这套流程也能完成定位与验证。
让经验从“人”身上迁移到可复用的“资产”中,正是我认为这套技能最大的价值,也是推荐使用 AI 技能而非死记文档的核心原因。
引入 AI 技能后,运维效率如何提升
降低学习门槛,摆脱命令记忆负担
brsmi、br-dcgmi 指令繁多、参数复杂。借助 AI Skill,自然语言下达需求即可自动组装命令,新人上手周期大幅缩短。
故障排查耗时大幅压缩
传统模式单次 GPU 故障排查 20~40 分钟;使用技能自动化汇总各项指标,3 分钟输出完整诊断信息,极大释放人力。
运维经验代码化、标准化沉淀
排障流程、适配方案固化在 Skill 文档中,不再依赖少数资深人员,避免知识流失。
无缝对接自研 SUPACODE™平台
与 fullstack 环境部署、GPU 驱动诊断能力深度联动,部署前自动预检硬件与驱动兼容性,统一多种平台的诊断逻辑。
易于融入自动化集群巡检
支持 CSV、JSON 结构化输出,可对接定时巡检、CI 自动化测试流水线,提前拦截硬件异常。
多套环境部署,我们踩过哪些坑
在多套环境部署使用过程中,我们整理了以下高频问题及解决方案:
技能路径配置错误,Agent无法加载
技能存放目录需要遵循客户端规范:SUPACODE™放置~/.supacode/skills/,Claude Code 使用~/.claude/skills/。随意解压至自定义目录会导致扫描失效。
✅ 建议使用标准化解压脚本,部署完成重启Agent验证可用性。
unzip biren-driver-management-tools-skill.zip -d ~/.claude/skills/复制
硬件修改类操作缺少 root 权限
SVI 模式切换、GPU 复位、功耗配置等操作需要 sudo 权限。普通用户直接调用会执行失败。
✅ 使用时补充提示:涉及硬件配置变更,自动使用 sudo 执行。
br-dcgmd守护进程未启动,深度诊断失效
br-dcgmi 依赖后台守护进程,服务器重启后不会自动拉起,精细化功耗、长时压力诊断无法执行。
✅ 运维流程增加前置检查,配置开机自启 br-dcgmd。
多版本驱动并存,工具二进制冲突
集群环境存在多套驱动版本,PATH 环境变量容易命中旧版 brsmi,造成信息读取异常。
✅ 通过环境变量锁定最新工具目录,规避版本不兼容问题。
监控日志目录权限不足,指标丢失
默认/tmp 目录定时清理,不适合长期保存巡检数据。
✅ 统一规划持久化日志目录,提前分配读写权限。
想试试这套技能?从一句自然语言指令开始
使用这套 AI 技能,不必先记住一长串命令和参数。将技能加载到 AI Agent 后,你可以直接用自然语言描述需求,从基础巡检、持续监控到深度诊断,按实际场景调用相应能力。
日常巡检时,可以说:“对集群内所有壁仞科技 GPU 执行基础健康预检,汇总温度、功耗和 ECC 错误信息,输出报表。”如果遇到算力波动或任务卡顿,可以进一步提出:“对指定 GPU 持续监控 5 分钟,采集算力、HBM 带宽与 PCIe 链路指标。”需要深入检查时,则可以说:“启动 DCGM 中型诊断,检查显存与 PCIe 链路稳定性。”
配置查询和故障回溯也可以这样开展。例如:“查询当前 GPU 的 SVI 切分模式,如需调整为 1 切 2 模式,请给出操作命令。”或者:“收集 GPU 全套运行日志,导出用于故障回溯。”把需求说清楚,让 Agent 调用技能组织相应命令,正是这套工具融入日常运维的直接方式。
还想和社区一起补上哪些能力?
Biren Driver Management Tools Skill 解决了 GPU 运维命令零散、流程不统一、经验难以传承的痛点,把传统人工排查升级为 AI 辅助自动化诊断,适配 AI 智算集群与芯片验证平台大规模运维场景。
后续我们将持续沉淀典型故障分析逻辑,打通告警推送,并将该技能作为团队标准化运维入门工具,统一操作规范。
相关链接:
Biren Driver Management Tools Skill:
https://skillhub.openanolis.cn/skill/biren-driver-management-tools-skill
龙蜥社区 Skillhub 官网链接:
https://skillhub.openanolis.cn
龙蜥社区 Skill 征集活动——「Skill 创造营」上线以来响应热烈。截至目前,龙蜥 SkillHub 已收到覆盖安全、系统运维、AI 推理、数据库等多个领域,一个面向 Infra 的 AI 技能生态正在加速成型。「Skill 创造营」持续征集中,诚挚欢迎每一位开发者提交你的 Skill 与最佳实践。如果你有感兴趣的方向或者关于 SkillHub 的问题,欢迎通过下方链接反馈给我们。
SkillHub 用户需求收集链接:
https://alidocs.dingtalk.com/notable/share/form/v014jKqm0b74KdjLnw1_f22ghuX_M7AJs3D