🔥填问卷有礼!
你希望 AI 帮你解决哪些开发难题?龙蜥社区正在收集开发者对 AI 能力的真实需求,社区将为做出精彩回答的小伙伴寄送一份社区精美礼品,感谢你的认真参与和真诚分享!
Agent 给异构补丁记了本 SBOM
资质评审,问「你们到底改了什么?」
安全审计,问「这条 CVE 修复的来历是什么?」
兼容性认证,问「哪些改动和架构强相关?依据呢?」
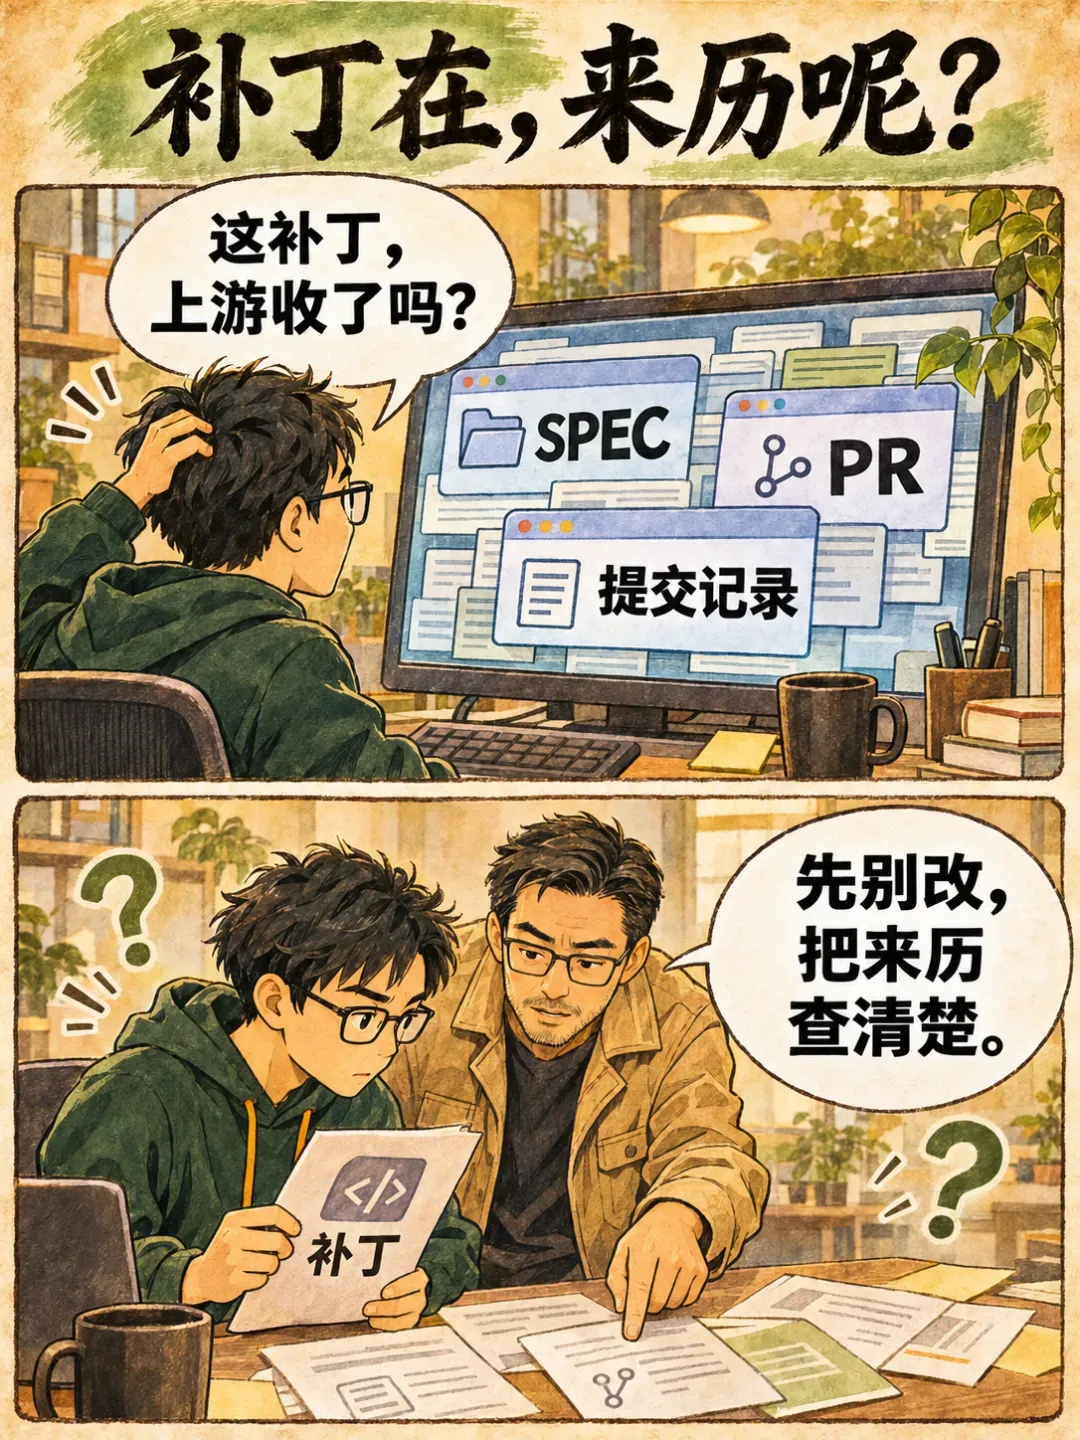
周一早上,老葛把这三个问题甩给了小安——都不是他自己出的题,是外面飞进来的。发行版用得越广,要支撑的指令集架构就越多:x86、ARM 之外,riscv64、loongarch64 都排着队要适配。架构越多,为特定架构修改的补丁——异构补丁——就越多,「每条补丁从哪来、是否可控」也被问得越勤:行业客户要供应链说明,安全审计要修复来历,兼容性认证要异构改动的证据。两千多条异构补丁里,哪些是上游同步、哪些是自己兜底——这本 SBOM(Software Bill of Materials,软件物料清单)账盘不清楚,供应链可控就是空话;它已经不是加分项,而是必答题。
三个问题看起来是三道题,其实是同一道题。小安先试了最朴素的办法:人肉盘。
小安的异构考古现场
盘到的第一条,链断得最直接:PR 描述只有一行——「同步上游,修复构建」——没有 commit 号,没有镜像地址。小安不好意思抱怨:当年这一行足够评审人做判断、点合并;只是没人想到,这一行三年后还要被人读懂。
一行描述当年没写错,它只是只回答了当年的问题。
第二条看着最让人放心:描述写得很规范——上游 commit 号、作者、测试记录一样不缺。小安刚松口气,对着仓库里的补丁文件一核:两次 rebase 之后补丁被重新生成,描述里的 SHA 在上游哪个镜像都对不上了;再顺着描述里的镜像地址找过去,仓库三年前搬了家,旧地址只回一个干净的 404。描述没有撒谎,它只是过期了。
线索到此中断。小安安慰自己:个例,一定是个例。第三条连上游引用都没有——不是当年没人写,而是这条本来就是自研;而审计最想挖出来的,恰恰就是这一类。
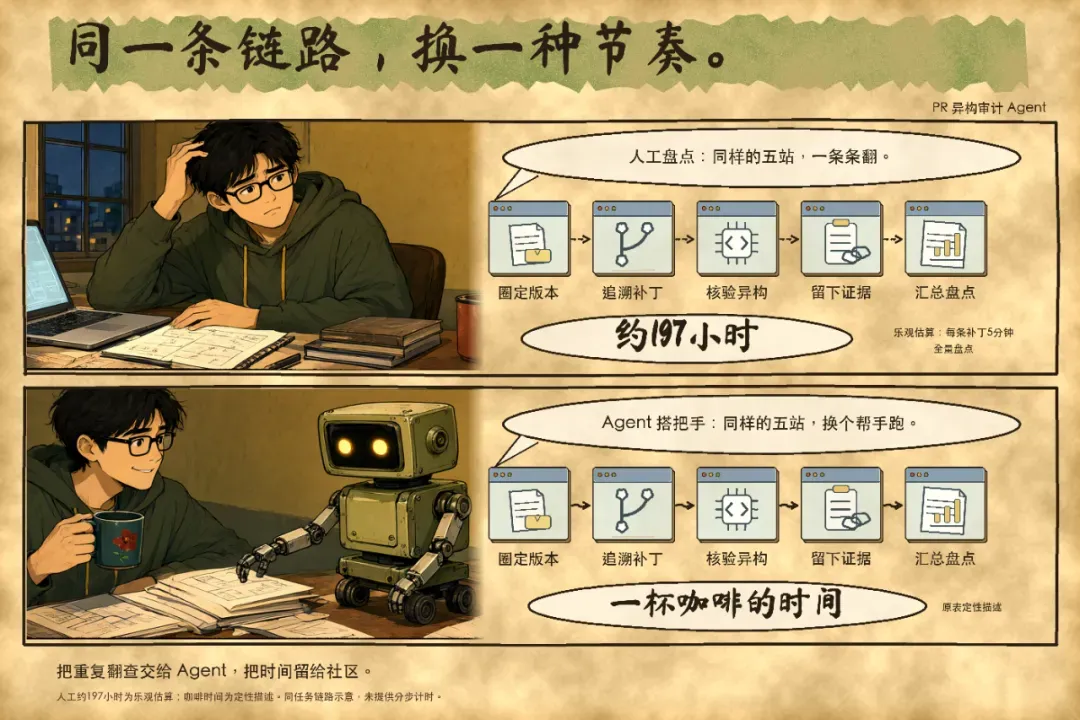
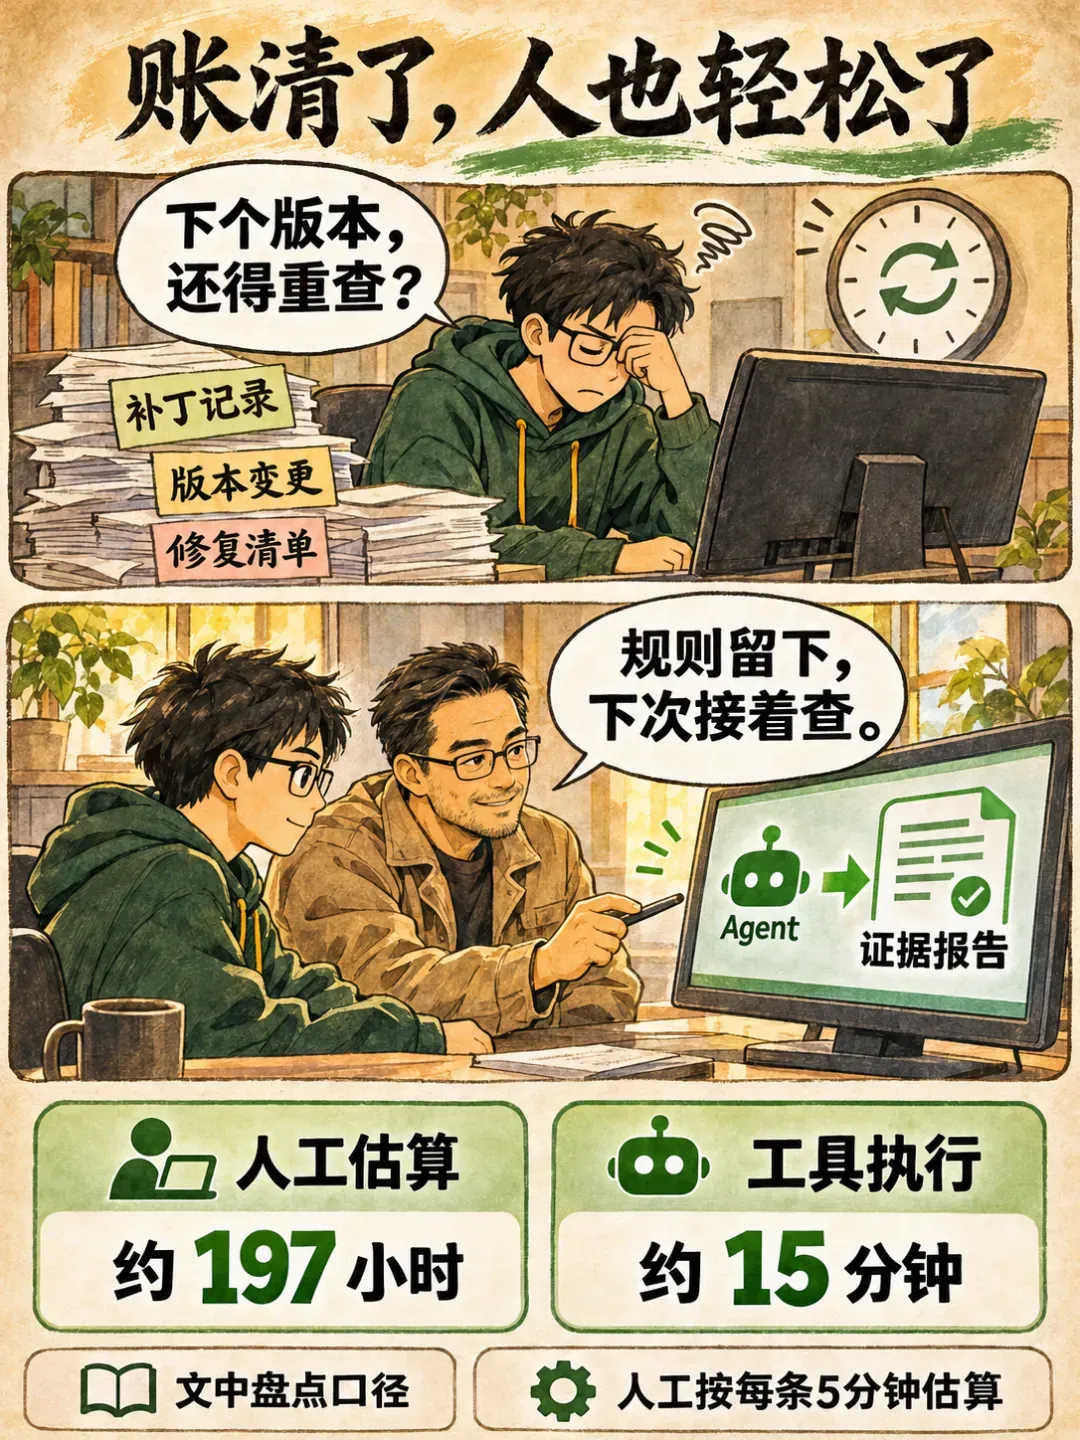
三天后小安报上来一个数:两千多条补丁,按每条五分钟的乐观估计,全量盘一遍要两百个小时——折合二十五个工作日,大约从桂花飘香盘到落叶扫完。而且盘完也不算完:认证要抽检,抽检要证据链,表后面挂不上证据,一条就回到解放前。
老葛听完,说了句维护工具链这些年的心得:「这事不该人来做——标准是死的,为什么不让 Agent 来跑?」
这样的账靠人力攒不出来。三天盘下来的结论只有一条:规则不难,难在执行——而且不是难一次,是每申一次资质、每接一次审计,就得把两百个小时重新烧一遍。好在攒账这件事本身,正适合交给 Agent 来做。
难在哪儿
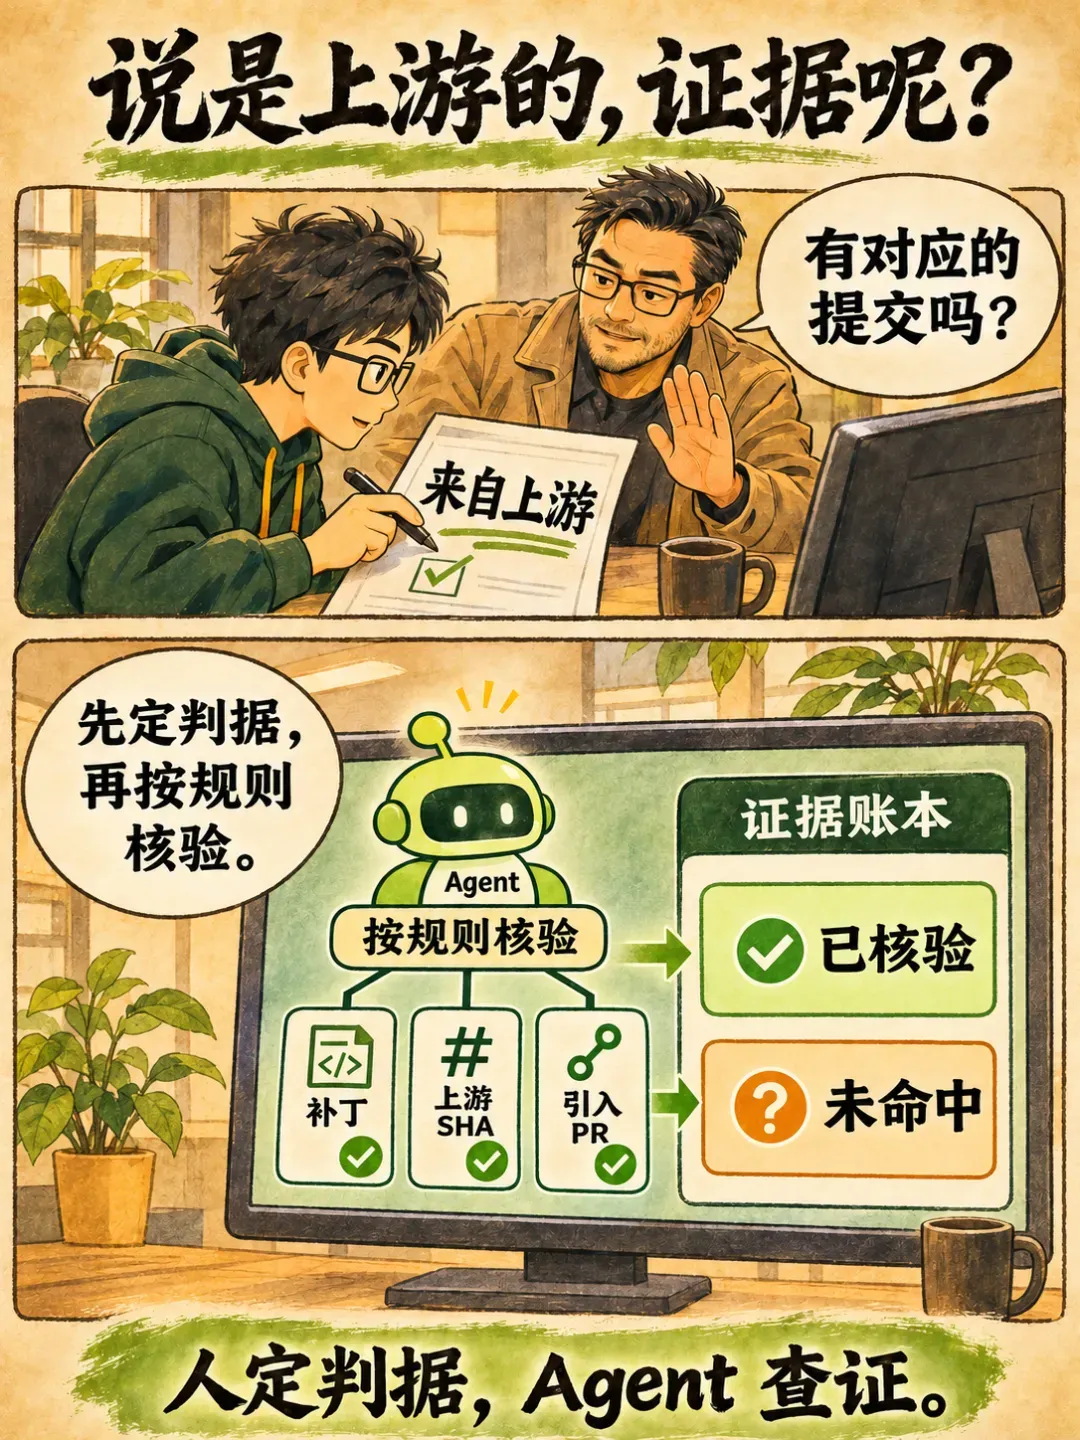
为什么每次都得重新烧一遍?缺口其实早就在那里:补丁进了打包仓库,来源信息却留在 PR 描述、提交说明和工程师的记忆里,从来没有一份系统性的记录。想知道「这条硬件相关的补丁是上游的,还是我们自己兜底」,只能重新考古——而考古现场,就是小安盘了三天才发现的那条断链。
老葛那句「判定标准是死的」,指的是规则层面:什么算架构相关补丁、来源怎么认定,这些判据写得下来。难的是下面三件事。
第一,证据链长,每一环都可能断。「上游仓库里对得上 commit」这条规则只有一句话,执行起来是一条链路:补丁文件 → 引入它的 PR → 提交作者与时间 → 上游镜像 → SHA 核验。链路上每一环都会断:有的描述只有一行,连 commit 号都没留;有的描述很规范,SHA 却经两次 rebase 后对不上任何镜像;有的上游镜像地址早已 404;有的包压根没有可靠的上游镜像。规则是死的,取证据的路是活的,两千多条补丁每条走的路都不一样。
第二,不能抽样。 异构补丁里自研的不到百分之一——但盘账的目的恰恰是把这少数几条找出来。抽样盘账等于没盘:漏掉一条自研补丁,大版本升级时就爆一条。两千多条,一条都不能跳过。
第三,两千多次判定要不走样。 同一条补丁,周一判的和周五判的不一样,这个人判的和那个人判的又不一样——不是不认真,是面对几百条模糊地带(改一个宏算不算架构相关?路径带 arch 字样算不算?),人的判断天然会漂移。结论要能用,前提是第两千条的判定标准和第一条完全一致。
三件事的共同点:规则不难,难在执行——链路长、要全量、要一致。人做不到的,恰好是机器最不在乎的。
三个难点,三个对策
PR 异构审计 Agent 的设计就是对着上面三个难点来的。
链路长,就把每个断点的去向写死。 补丁 → PR → 作者 → 镜像 → SHA 这条链路,每断一环都有明确的落点:描述只有一行或 SHA 过期,就从补丁正文和文件清单反查;镜像核不上或压根没有,就记自研或如实报「核验不可达」,不猜、不放宽——证据到哪一步,结论就写到哪一步。
不能抽样,就全量逐条过。 两千多条补丁每条都走完整的判定链路,没有「先查重点包」的捷径。链路自身可续:中断了从断点接着跑,已核验的部分不重复请求。人做不到的「一条都不跳过」,对机器只是循环次数。
要不走样,就让判据离开人。 所有判断标准写进 JSON 规则文件,由脚本解释执行;AI 只负责调度,不做即兴判断。周一判的和周五判的一致,这个人判的和那个人判的一致,今天跑和下个月跑还是一致。判据要改,改数据文件、重跑一遍,新旧结论可对照。
方案落到工程上,就是一份谁都能复核的清单:每条补丁的判定结论后面挂着证据链接,能点开核对的才算数。
算给拍板的人看
这笔账值得摆到桌面上:
人肉盘账 |
Agent 盘账 |
|
覆盖范围 |
重点包抽样,长尾靠运气 |
两千多条全量,一条不跳 |
耗时 |
约 200 小时(二十五个工作日) |
全量重跑一遍,无人值守(实测耗时见图中对照) |
一致性 |
因人而异、因周而异 |
判据版本化,第 1 条和第 2000 条同一把尺子 |
证据链 |
表后面挂不上,抽检即回炉 |
每条结论挂证据链接,点开可核 |
复用成本 |
每审一次重烧一次 |
重跑一遍,账永远对着最新代码 |
更要紧的是风险边界:AI 不做判断,只执行判断。 口径是否经得起推敲、证据链是否完整,仍然完全由人负责;判据要变,改规则文件、重跑、新旧对照——整个过程可控、可审计、可回滚。
而且这不是一本一次性的账。补丁审计只是第一本:CVE 影响面盘点、许可证合规梳理、架构相关改动清单——凡是「规则写得下来、证据核得实、要全量重复跑」的活,都是同一套打法。一次把判断固化下来,此后次次复用。
尾声
这次实践让小安和老葛确认了一件事:AI Agent 在研发基础设施里的正确位置,不是替人做判断,而是把人已经想清楚的判断固化下来,然后不断地执行。判断口径是否经得起推敲、证据链是否完整,仍然完全由人负责——AI 只是把这两件事从「每次盘点都要重新做一遍」变成了「做过一次,此后次次复用」。
下一步,这份清单会接进版本发布流程,每个版本自动生成硬件支持清单与来源审计。
又一个周一早上,评审会上第四次被问到「你们到底改了什么」。这次老葛没有组织专项盘点,而是点了一次报表导出。
小安在心里默默补了一句:这次,描述可以过期,镜像可以搬家,账不会过期——它永远在那里,永远对着最新代码重跑出来。
Agent 异构数据统计快速体验
上手三步,注意哦,现在都是免费使用:
1、打开 SysAgent 终端页面(复制链接至浏览器打开):https://alinux.console.aliyun.com/sysom-ai/ops-assistant
2、登录阿里云账号。
3、输入一句话任务:使用发行版专家完成以下任务:使用 anolis-expert MCP 工具(不要检查本地的 playbook,直接查看 MCP 描述,根据描述下发任务)完成以下任务:给我列出所有 Anolis 23 的异构指令集(riscv64、loongarch64 等)对应补丁的开源情况、提交者信息等,最终给我一个汇总的报告。
Anolis OS 27 Monorepo 已正式开源,仓库地址:https://gitee.com/anolis/anolis27-monorepo
仓库部分功能需配合 PengLAI MCP 能力,该能力处于邀测阶段,请加入下方「邀测答疑钉钉群」申请(钉钉群号:190415001609)。