一句话定位:这不是"哪家模型更便宜",而是"你说降了六成,这个六成是怎么算出来的"——载体是一次任务的完整链路,对象是从 tokens 到费用的四步换算。同样的核对可迁移到客服工单的单均成本、批量导出的单位耗时、接口重试带来的额外调用量核算。
摘要
2026 年 11 月,两个价格叙事撞在一起:Anthropic 的 Claude Fable 5.2 从每百万 token 10/50 美元降到 8/40 美元(降 20%),阿里巴巴的 Qwen4-Max 发布材料称单个任务平均费用从 26.58 元降到 11.16 元(降 58%)。这两组数字量的不是同一个东西——一个是单价,一个是作业成本。本文把从 tokens 到"单任务费用"的四步换算摊开,并给出测试团队可以立刻核对的三件事。
两份发布材料,同一周,都讲"更便宜"。
Anthropic 的说法是单价:每百万 token 输入 8 美元、输出 40 美元,比上一代的 10/50 便宜 20%。
阿里巴巴的说法是作业:Qwen4-Max 在 Work360 评测里,单个任务的平均费用从 26.58 元降到 11.16 元,降幅 58%。
两个数都来自厂商自报,都写得挺具体。但它们不能互相比较——一个是"每单位消耗多少钱",一个是"完成一件事平均花多少钱"。
单价降 20%,账单可能一分没少
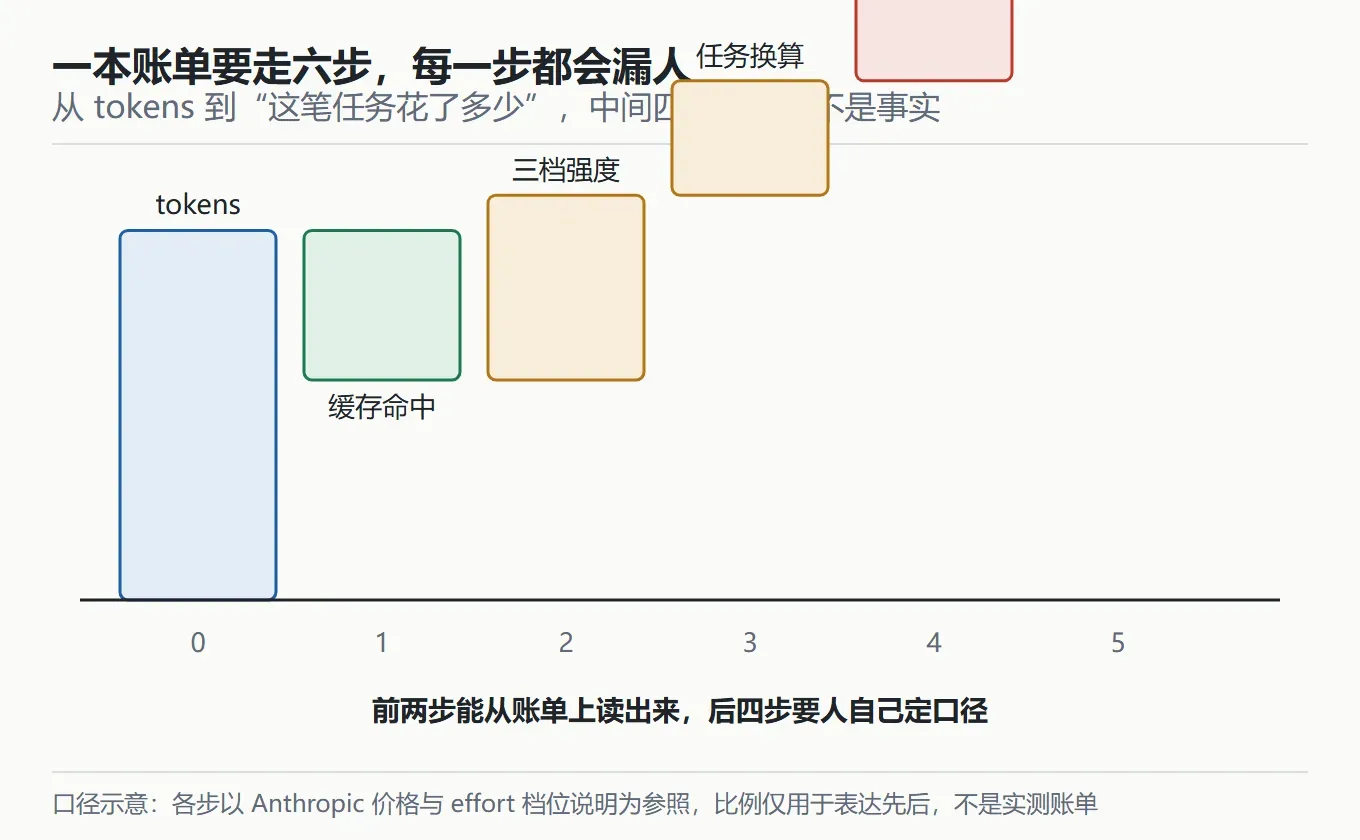
从 tokens 到一个任务的费用,中间至少有四步是估算:
第一步,缓存命中率。 命中缓存与未命中的价格差好几倍。Anthropic 的 8/40 是标准价,缓存读写另有计价;Qwen4-Max 的发布材料里,缓存命中价被单独拿出来说(每百万 tokens 低至 0.5 元)。同一套 prompt,命中率从 60% 掉到 30%,账单会明显变。
第二步,推理强度档位。 Fable 5.2 有 low、medium、high、xhigh、max 多档,官方自己的说明里就写:FrontierCode 2.0 在 High 档是 45.3%,Xhigh 档是 49.1%,费用各不同。上代对比时用的是哪一档,直接决定"提升了多少"。
第三步,任务怎么算一次。 一次会话算一个任务,还是一轮对话算一个任务,还是一份交付物算一个任务?Anthropic 的 fast 模式是价格翻倍换 2.5 倍速度(16/80 美元),如果把它算进单任务成本,结论会转向。
第四步,失败与重试。 重试是额外调用,但不产生额外成果。这部分计入还是剔除,口径一变,"单任务费用"就变了。
四步都不难理解,难的是它们很少被写出来。于是"降了 58%"变成一个不可复查的结论。
质量指标和账单指标,只在一个地方重叠
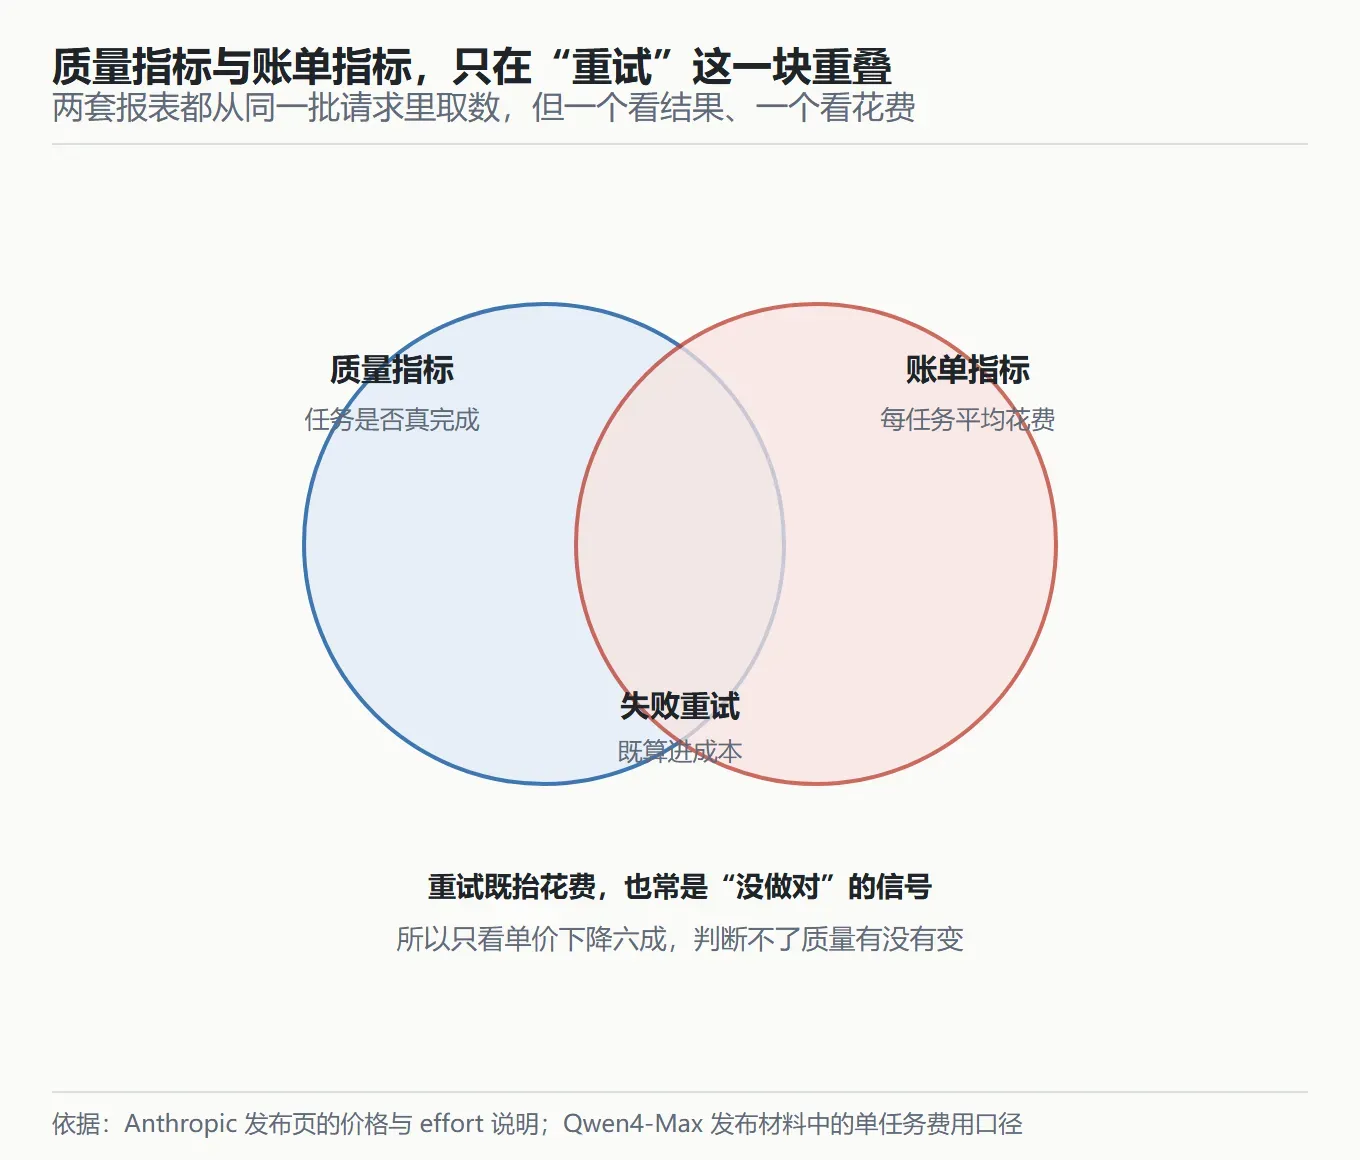
我认为这是最值得测试团队记住的一张图:两个报表的唯一交集是重试。
重试既抬高账单,又常常意味着"第一次没做对"。也就是说,如果你想同时看质量和成本,最省事的一个指标就是重试率——它天然是双份信息。
但现实里,成本报表通常由财务侧出,质量报表由测试侧出,中间的重试没有归属。这就是"降价了但体验变差了"这类故事的常见成因:两边都在变好,交集没人看。
Qwen4 那个 58% 值不值得抄
值得,但要抄它的写法,不要只抄数字。
阿里巴巴发布材料里的 58% 是这样定义的:在 Work360 这个自家构建的评测集(721 个细分领域的"全场景建模体系")里,同一批任务的平均费用从 26.58 元降到 11.16 元。
三个限定词很关键:自家评测集、同一批任务、平均费用。这三条合起来,让这个数字有界——它说的是"在这 721 个领域里,任务的平均花费变了多少",不是说"你的账单会降 58%"。
另外两个数字可以对照:官方说 Qwen4-Max 每个 token 只激活 71B 参数(2.4T 总参数),比上一代同规模少 25%;Xhigh 与 High 两档的 token 消耗分别比前代减少约 24% 和 35%,Terminal-Bench 4.0 上分别减少约 48% 和 49%。这些是"消耗"口径,不是"费用"口径——它们能解释降价来自哪里,但不能直接换算成钱。
档位本身也是一条金字塔
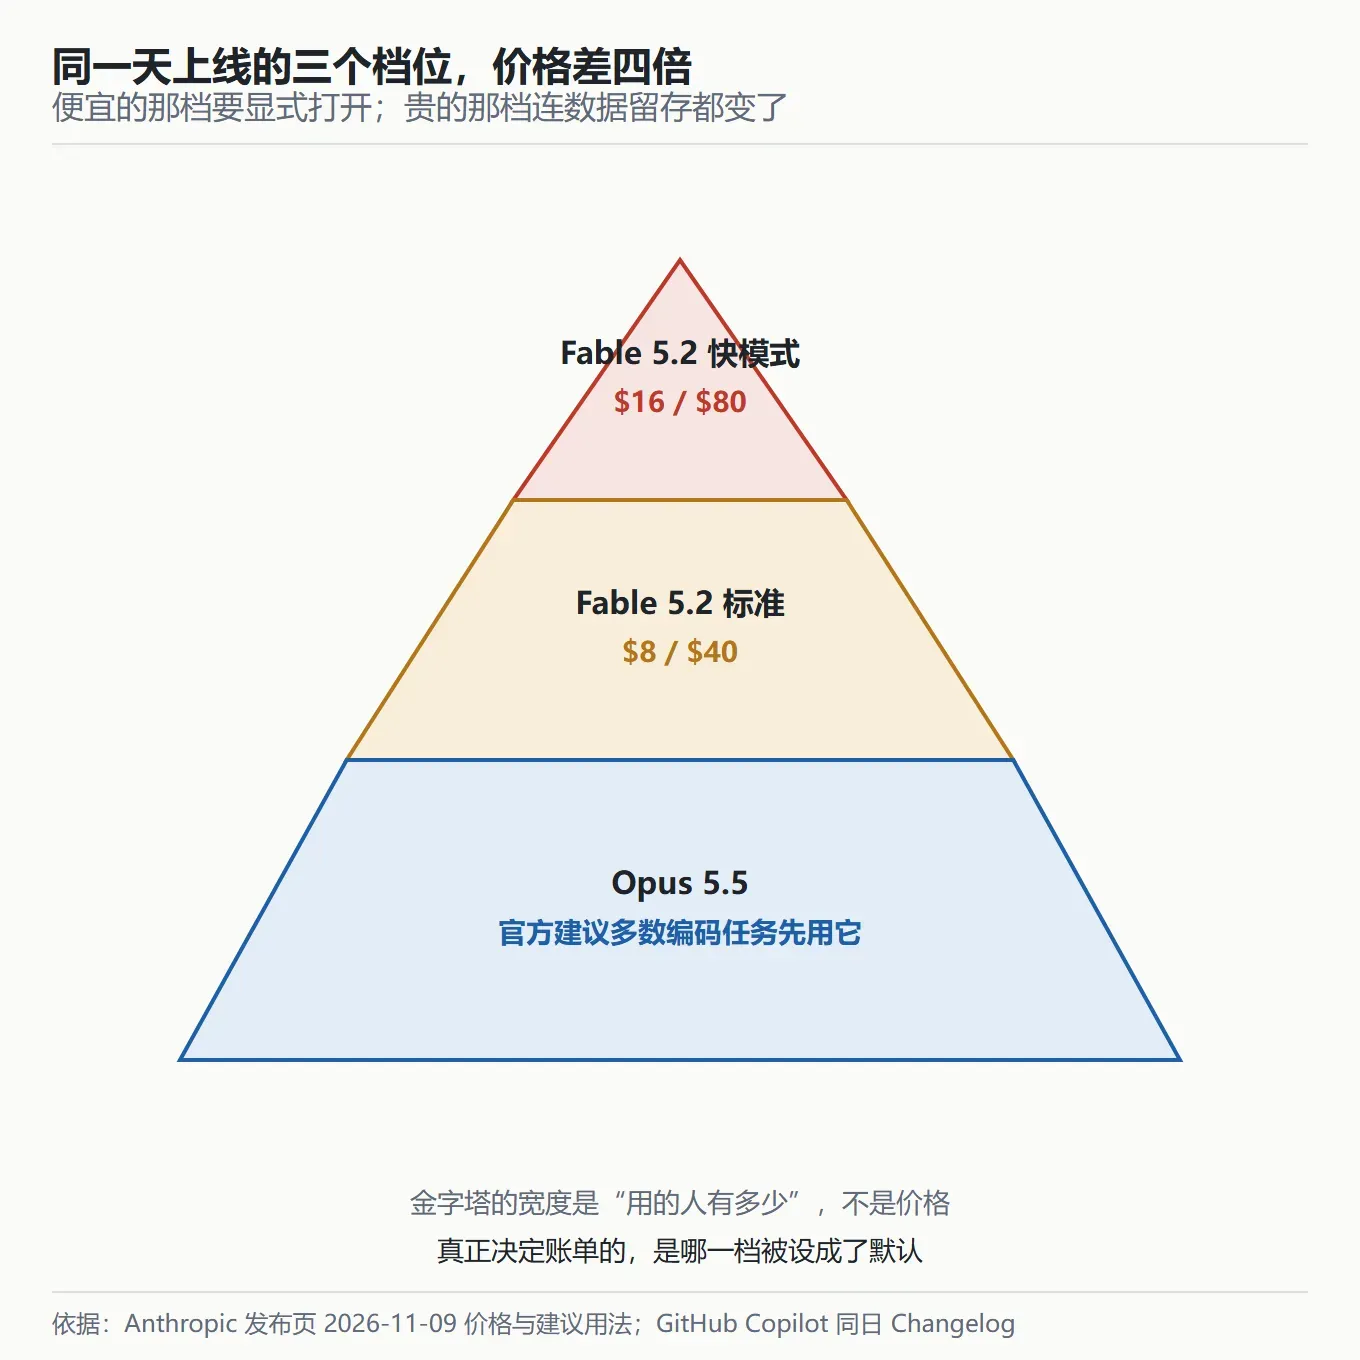
这张图想说的是:三档同时存在,账单价差四倍。Fable 5.2 标准档 $8/$40,快模式 $16/$80(价格翻倍换最多 2.5 倍速度);而官方在发布页里专门写了一句"多数编码与知识任务建议先用 Opus 5.5",Claude Code 里它就是默认选项。
于是成本问题变成了一个配置问题:不是"哪个模型便宜",而是"默认档位设在哪一档"。很多团队上线时把默认设在高档位,跑一段时间再问为什么账单比预期高——答案就在这张金字塔的宽度上。
三件可以立刻做的核对
第一,把档位写进对比表。任何"X 比 Y 强多少"的结论,都要带 effort 档位。官方材料里 Fable 5.2 的 49.1% 是 Xhigh,对比的 Opus 5.5 是 45.5%(不同档),这种细节一旦漏掉,对比就失去意义。
第二,给重试单独设一栏。报表里加"平均重试次数",它与账单和质量都相关,是最便宜的交叉指标。
第三,区分"厂商自报"与"我方实测"。厂商的单任务费用是在自家任务集上算的,与你的任务分布不同。要让结论站得住,用你自己的一批真实任务重算一遍——哪怕只有 50 条。
一个容易被漏掉的分母:谁在付 fast 模式的钱
Fable 5.2 的 fast 模式是 $16/$80,价格翻倍,速度最多 2.5 倍。它只在 Claude Code、Claude Platform、Google Cloud 上的 Claude 模型、Microsoft Foundry 上线。
这类"加钱换速度"的开关,在成本核算里经常被忘记——因为它默认是关的,但一旦有人开了它做压测或跑长任务,账单会出现一个解释不了的高峰。测试团队如果负责跑回归,很可能正是那个开开关的人。
我的做法是把它写进测试配置说明:哪些场景允许开 fast,开了要单独记账。这样"降价两成"的结论才不会被一个开关推翻。
一个具体例子:同一句结论的两种写法
写法一:新模型单任务成本比上一代低 58%。
写法二:在 Work360 的 721 个细分领域任务上,用同一套提示与同一档推理强度跑完,单个任务的平均费用从前代的 26.58 元降到 11.16 元(降 58%);该口径不含重试成本,也未计入缓存命中率变化。
两种写法说的是同一件事,能做的事完全不同。第一种可以进宣传页,第二种才能进决策会——因为它把可复查的三件事都写出来了:任务集、档位、剔除项。
我建议团队内部的成本结论一律用第二种写法,哪怕它长、哪怕它不好念。原因很实际:这类数字一旦被用在预算审批上,第一次被追问"怎么算的"时如果答不上来,后面所有结论都会被怀疑。
落地检查表
| 检查项 | 常见疏漏 | 修正动作 |
|---|---|---|
| 档位 | 对比时两端用了不同 effort | 在表头写清档位,不同档不许放同一列 |
| 缓存 | 只报标准价,不报命中率 | 加一列缓存命中率,或注明按 0 命中估算 |
| 任务单位 | "一次调用""一次会话""一个交付物"混用 | 在报表脚注定义一次任务 |
| 重试 | 计入成本但不计入分子 | 单列重试次数与重试费用 |
| 属性 | 厂商自报与我方实测并列 | 每个数字带属性标签 |
这张表我自己在用,最常被漏的是第一行和最后一行。
顺带看一眼"发布周的额度":它也是成本的一部分
Fable 5.2 发布当周,官方给符合条件的付费订阅额外送额度:一次性 1—3 次 Fable 使用重置,Pro 与 Team 标准席位可把每周用量上限的最多 50% 用在 Fable 上。GitHub 那边同日宣布 Fable 5.2 在 Copilot 正式可用,但对 Business 与 Enterprise 是默认关闭、需管理员在设置里打开策略,且打开这个策略意味着同意数据留存条款。
这两件事放一起看,是一套典型的企业侧成本结构:能用多少,不完全由单价决定,还由额度窗口与策略开关决定。
做成本模型时,这一层经常被当作"外部条件"跳过。但真实账单里,它可能是最大的变量——换模型之前先确认额度,比算清楚单价省事也更有效。
为什么这属于质量报告,而不是采购报告
有人会问:成本账不是财务做的吗,测试写它做什么。
理由是:单价是可以核对的,作业成本不能。单价写在价目表上,谁都能查;"完成一个任务花了多少"取决于任务集、档位、重试、缓存,这些参数散落在研发流程里,只有参与研发的人知道。
这也是为什么"降价"经常在业务侧失效:采购按单价买了便宜的模型,研发按原来的档位跑,重试率上去了,缓存命中率下来了,账单没降。中间这一段,没人负责。
测试团队正好站在这一段中间——它既知道任务长什么样,也看得到失败与重试。把这段算清楚,是件顺手的事。
顺带说一句价格之外的隐性成本
部署和维护知识库、搭建评测集、给每个失败样本做归因——这些成本不会出现在 token 账单里,但它们决定了一个模型在你的场景里能不能用起来。
厂商材料给出的往往是门槛最低的那部分(价格、速度、榜单),避开的是最难被量化的那部分(接入成本、维护成本、迁移成本)。做质量预算时,两边都要算。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。