这不是"Copilot 审查准不准",而是"一条审查任务该花多少力气,由谁决定、被什么上限约束、事后怎么证明这个决定是对的"——载体是一个待合并的 PR,对象是审查深度这一关。同样的方法可迁移到接口契约检查、回归用例分层、灰度发布放量档位、第三方回调验签的校验强度。
摘要
GitHub 在 2026 年 11 月 17 日的 Changelog 里给 Copilot 代码审查加了三个东西:Adaptive(让 Copilot 按每个 PR 的复杂度和风险自己选 Lite、Balanced、Max 三档审查力度)、跨仓库上下文(公开预览,只对公开仓库)、以及审查中的密钥检测(公开预览)。同一次更新里,Azure Repos 的 Copilot 审查转为正式可用。这三件事看起来是功能清单,其实回答的是同一个问题:审查这件事该花多少力气才算合适。本文拆三档力度的实际约束条件——它能选到多高、由谁设上限、默认是什么、选了什么会不会显示出来——并给出四条可以直接验证的用例。
这个功能到底在替代什么,值得先看清楚。
Changelog 的原话是:今天,得有人在设置里、或者在发起审查时决定每个 PR 需要什么级别的审查力度。"A documentation update may only need Lite, while a change to authentication logic benefits from Max."
一个文档更新的 PR 和一个认证逻辑的 PR,摆在同一条队列里,用同一套力气去审。前者浪费,后者不够。
Adaptive 做的事情就是把这个判断交出去:Copilot 看每个 PR 的复杂度和风险,然后选 Lite、Balanced 或 Max 来审。每次审查都会显示 Adaptive 选的是哪一档。
配置入口有两处:单个 PR 可以在 Reviewers 栏里选 Adaptive;也可以把它设成个人、仓库、组织或企业级别的默认审查力度。Balanced 仍然是默认值。
一个容易被读错的"上限"
Adaptive 最有意思的地方不是它会选档,是它不能越过一条线。
原文写:Adaptive 永远不会选高于你的企业、组织或仓库设定的最大审查力度级别。Changelog 里还专门加了一个提示框,重复了这条规则——最大审查力度决定了 Adaptive 能从中选哪些档。
这句话把一个看起来"全自动"的功能变回了"受控"的功能。Adaptive 有权在你允许的范围内选择,但没有权扩大这个范围。
把它画出来看更清楚:三档力度叠成台阶,上面压着一块横梁,横梁的高低由管理员设定。
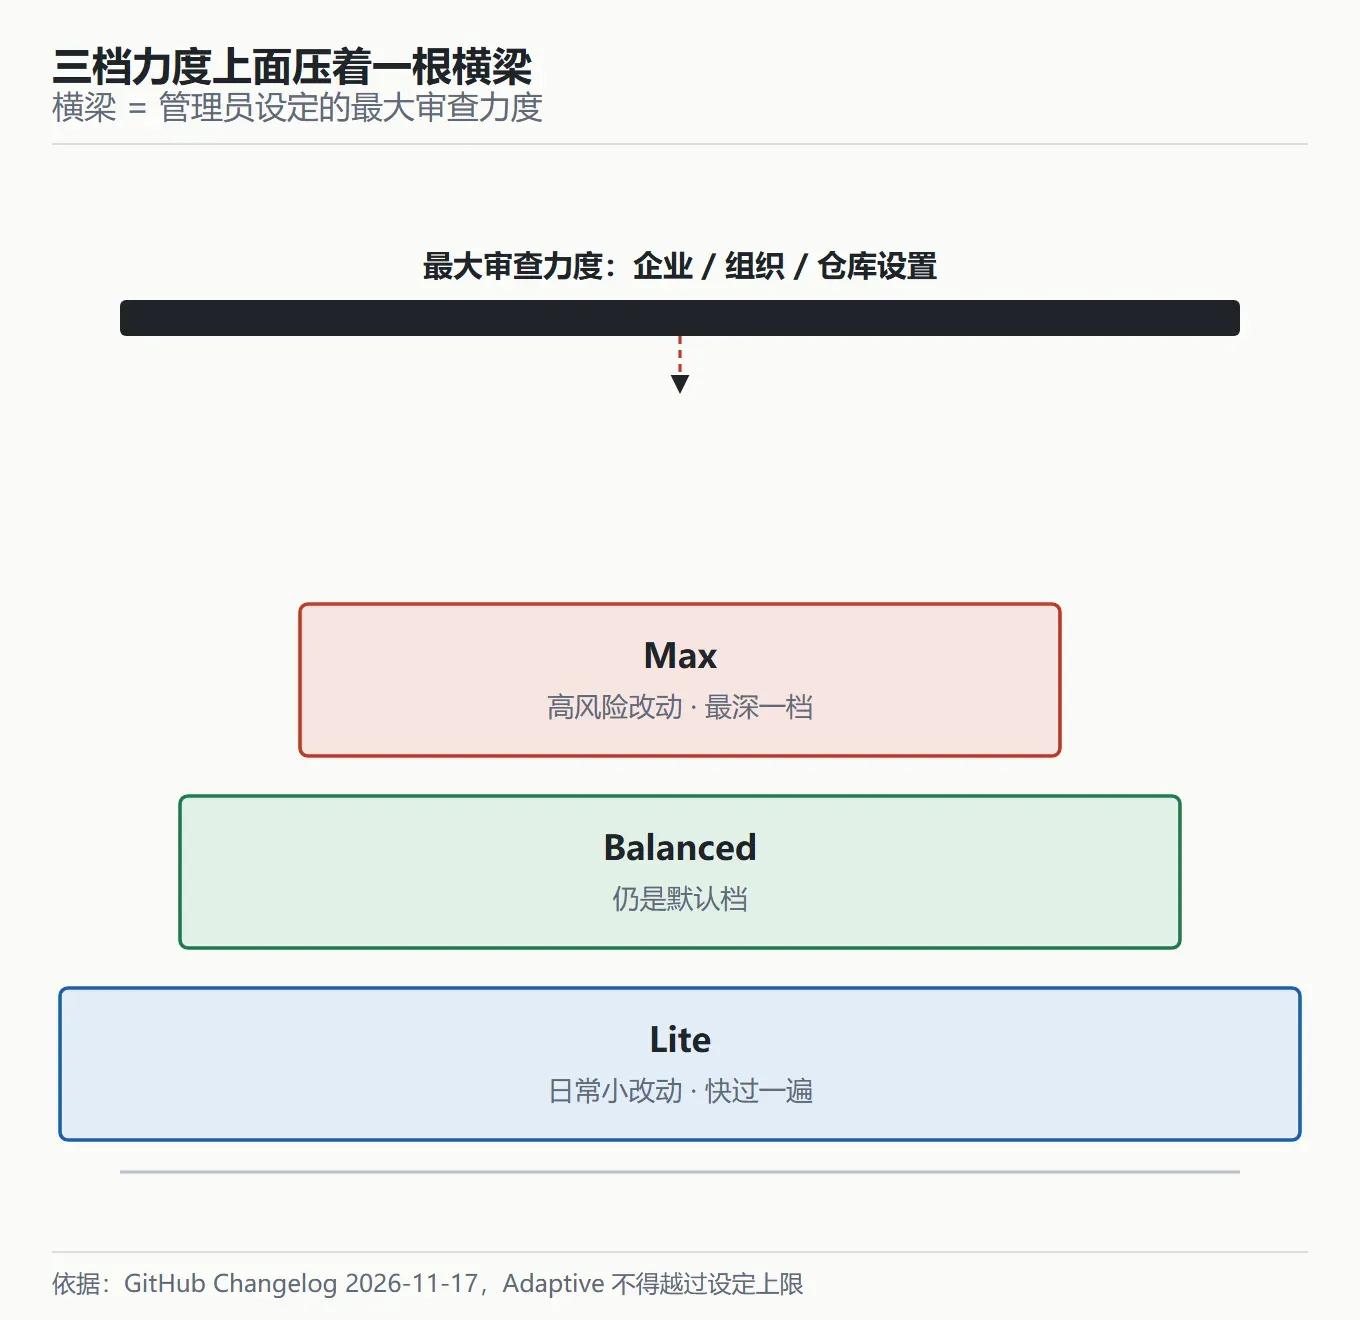
这块横梁的位置,决定了这个功能对团队到底是省力还是加负担。横梁设在 Max,Adaptive 能在三档里自由选;横梁设在 Lite,Adaptive 就只能在最低档里待着——这种情况下,把一个认证逻辑的改动交给它,它也只能用 Lite 审。
所以第一件要确认的事不是"它选得准不准",而是我们这条横梁现在设在哪。
还有两件同批上线的事
跨仓库上下文:Copilot 代码审查可以在审查时读取相关的公开仓库,找到其他仓库里依赖你这次改动的代码,也能找到其他仓库里的文档、自定义指令和 skill 作为上下文。状态是公开预览,范围限定在公开仓库。
这个限定很关键。大多数企业内部仓库不公开,所以这条能力对你的内部多仓库依赖基本没帮助——但它对开源项目或公开组件库的贡献流程是实打实的。
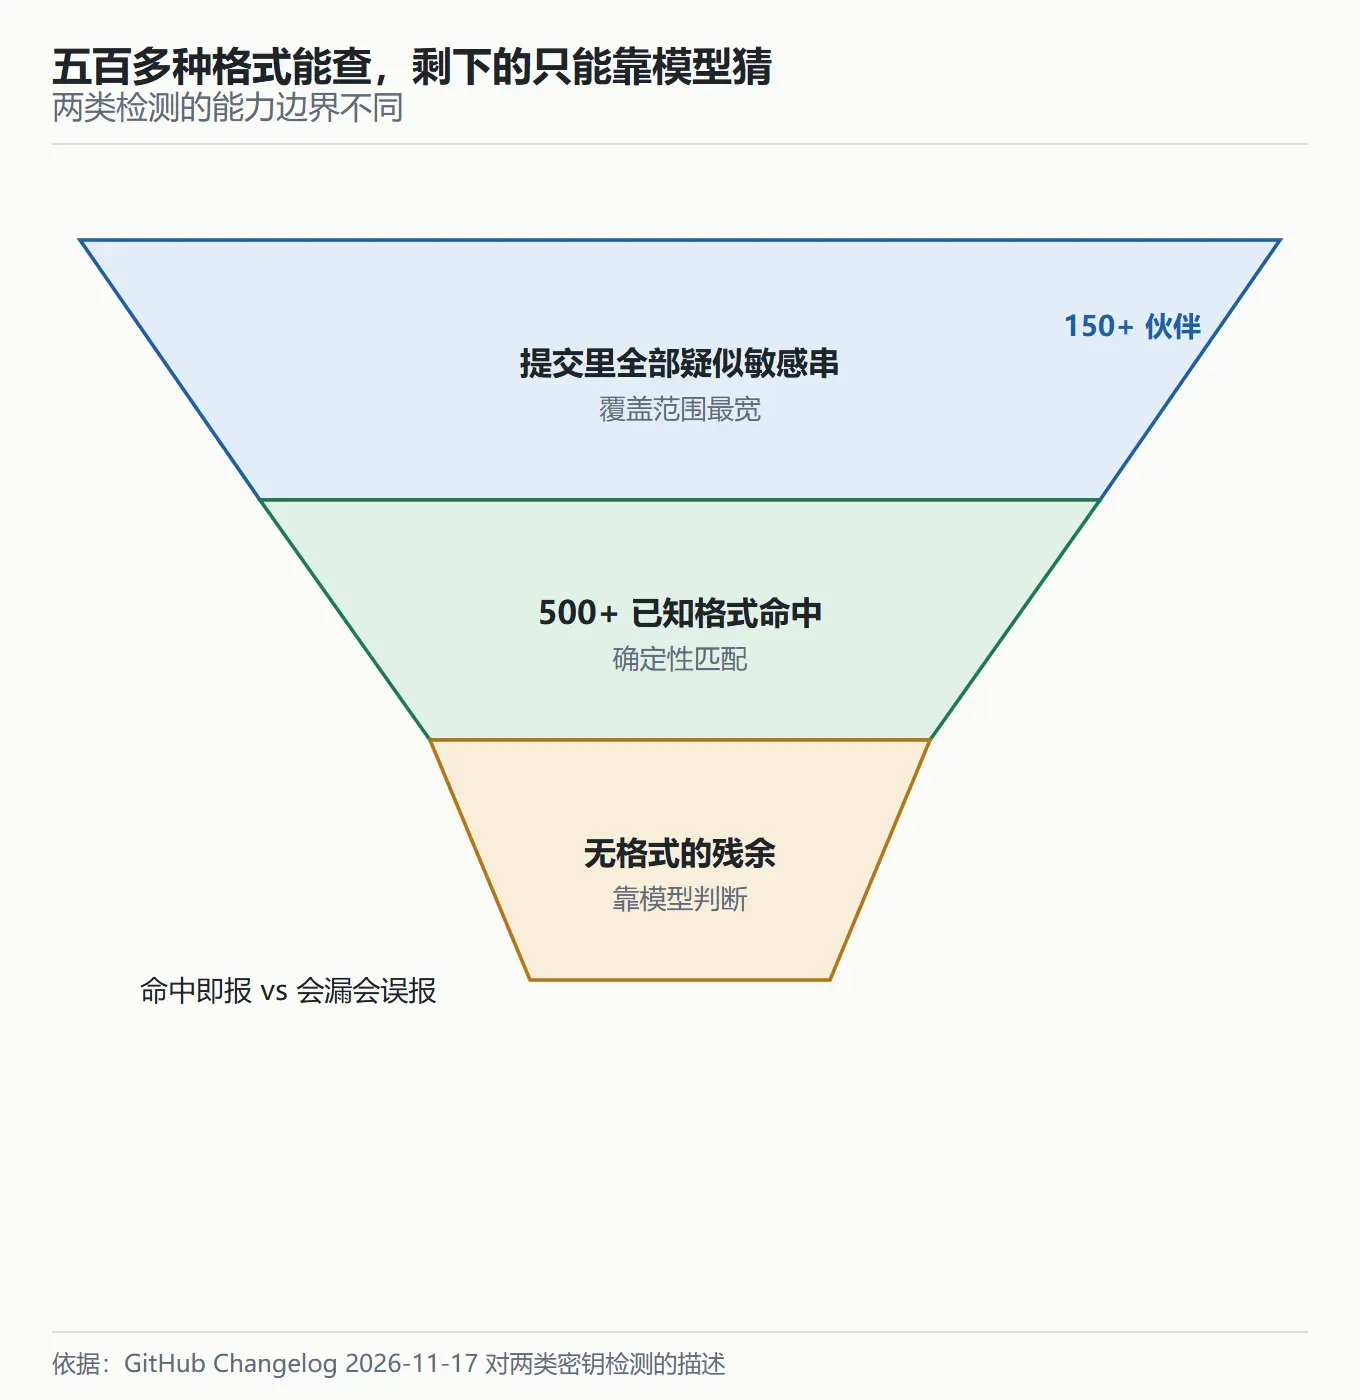
审查中的密钥检测:用两类方式工作。一类是确定性匹配,覆盖 500 多种密钥格式,这些检测器是 GitHub 通过密钥扫描合作计划、与 150 多家技术伙伴共建的;另一类是 AI/ML 检测,用 LLM 和 GitHub 专门为密钥训练的模型,去找没有可识别格式的凭证。
要开它,得进仓库或组织设置里,选 Copilot,再选 Code review。
这两件事放一起有一个共同点:它们都在缩小"有没有被看到过"这个盲区。跨仓库上下文缩小的是"改动影响到的地方",密钥检测缩小的是"长得不像密钥的密钥"。
用测试的视角重新问一遍
功能说明读完了,接下来是测试工程师的提问方式。下面四个问题,对应四条可以直接跑的用例。
问题一|档位选择在改动的真实风险上成立吗。 构造一组对照:同一个仓库里,一个只改文档注释的 PR,一个改认证中间件的 PR,一个同时改配置和依赖版本的 PR。看 Adaptive 分别落到哪一档,以及同一类 PR 重复提交多次是否稳定落到同一档。第三条比前两条重要——如果不稳定,说明它每次看的"复杂度"信号是飘的,那么把这套机制接进门禁就会产生随机的审查强度。
问题二|上限是被遵守,还是被绕过。 把仓库的最大审查力度设成 Lite,然后提交一个明显高风险(改认证、改加密库、动 CI 配置)的改动,确认审查是否仍停在 Lite,以及界面上显示的档位是不是 Lite。再把这套设置和"单 PR 选 Adaptive"叠加,看单 PR 的选择会不会突破仓库级上限。
问题三|"Balanced 仍是默认"这句话在迁移后是否还成立。 这是个典型的回归点。老用户的仓库本来就有一个默认力度,新功能上线后这个值有没有被改;新仓库的默认值是不是 Balanced。两个测试对象,两种预期。
问题四|密钥检测的覆盖边界写在哪。 那 500 多种格式是确定性检测,会命中;没有格式的凭证靠 AI/ML 模型判断,会有漏也会有误报。要测的是三件事:常见的测试夹具(假的 AWS key、假的连接串)会不会被误报;真实的低熵密码(比如 password123 写在测试文件里)会不会被漏;以及检测出来的结果会不会阻止合并——按这篇 Changelog 的写法,它是在审查评论里指出来的,所以答案大概率是不会自动拦,需要人看。
一个被三条功能同时指向的东西
这三条功能加在一起,指向同一件事:审查这件事情正在从"一次固定动作"变成"一组可配置的强度参数"。
这对测试团队有两个实际影响。
第一,审查的确定性下降了。同一个改动,因为档位不同、上下文不同(跨仓库读不读得到)、密钥检测开没开,得到的意见数量会不一样。以后不再能说"过了 Copilot 审查就没问题",只能说"在什么配置下过了审查"。
第二,审查结果开始需要被记录。如果团队要证明"这个 PR 被认真审过",需要的证据越来越多:用的哪一档、为什么是这一档、有没有跨仓库上下文、密钥检测开没开。这些信息现在的可见性各不相同——档位在每次审查里显示,配置在设置页,历史则要靠审计日志自己拼。
我的建议很简单:在把这类功能接进门禁之前,先做一次"力度基线"的盘点。把仓库里所有 PR 按改动类型分一遍(文档、配置、业务逻辑、认证与权限、依赖升级),为每类定一个最低审查档位,然后去设置里确认这条线有没有被 Adaptive 的横梁压住。这件事做完,Adaptive 才是帮你省力的;不做,它只是在替你做决定。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。