
一个后端开发者的独立建站记录 · 站点:lcanvs.com
我是写后端的,前端水平大概就是“能看懂 JSX,但从零搭一个 React 项目会当场去世”。今年年初想给自己做个壁纸站,也顺便试试,在 AI 的帮助下,一个纯后端能不能独立交付一个完整的网站。
这篇不是“AI 改变世界”,是我自己踩坑的记录:怎么用 AI 写前端、用 Python 写采集,把 1267 张 4K/8K 壁纸做成一个能搜索、能筛选、能统计下载的静态站。
先把结果摆出来
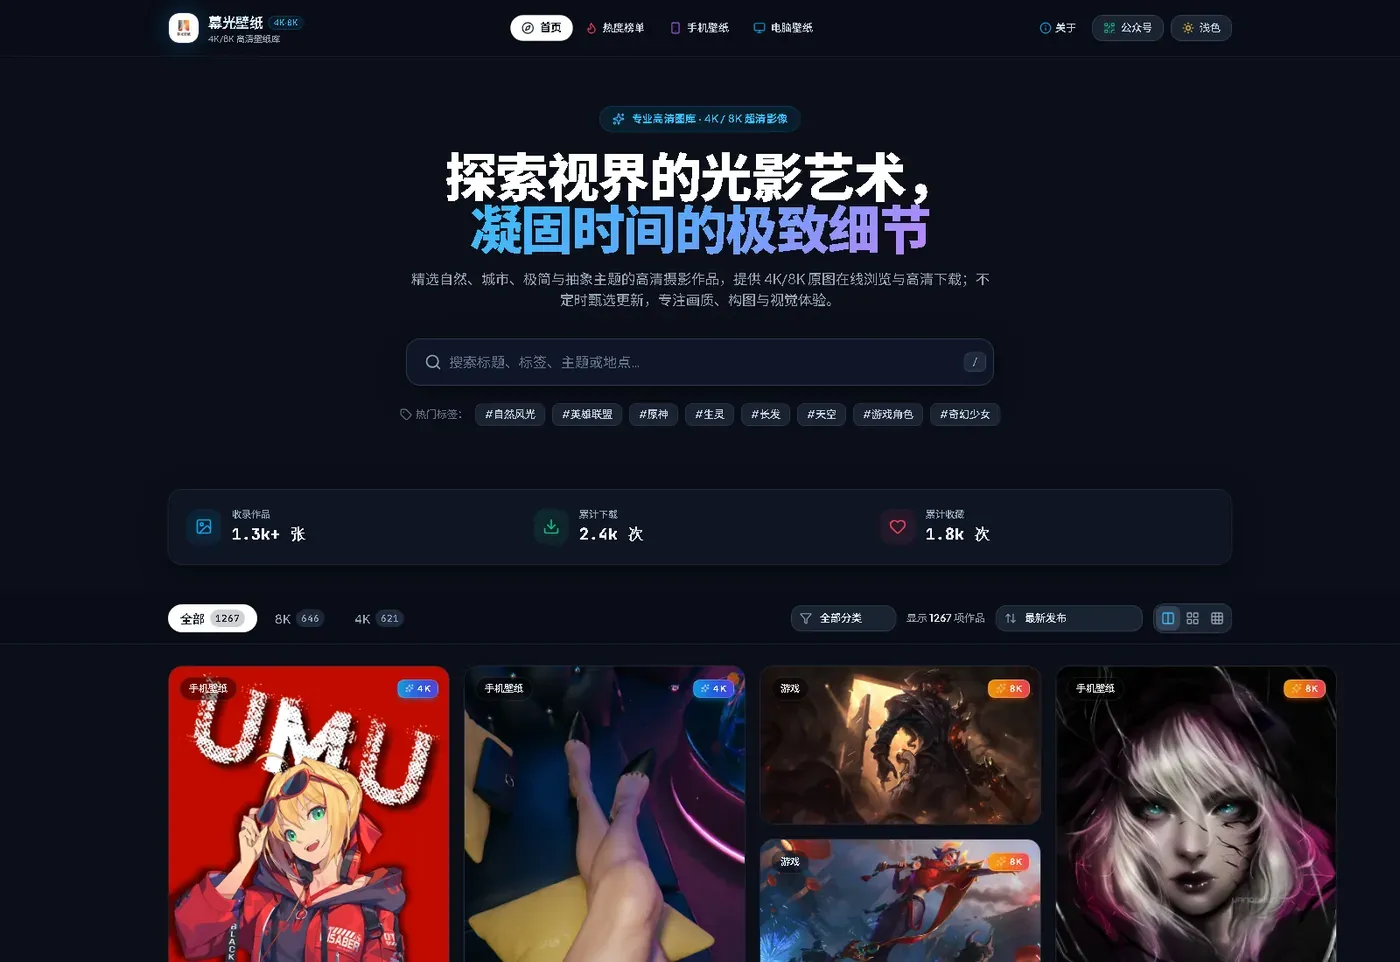
现在的 lcanvs.com:
- 1267 张 4K/8K 壁纸,电脑端 833 张、手机端 434 张,其中 8K 646 张;
- 可以按分辨率、分类、标签筛选,也能直接搜关键词;
- 每张图有独立的静态详情页,不用登录就能下原图;
- 热度榜、更新日志、24 个标签页;
- 全站下载和收藏统计,没接第三方统计脚本;
- 手机端自适应,没做 App。
首页:
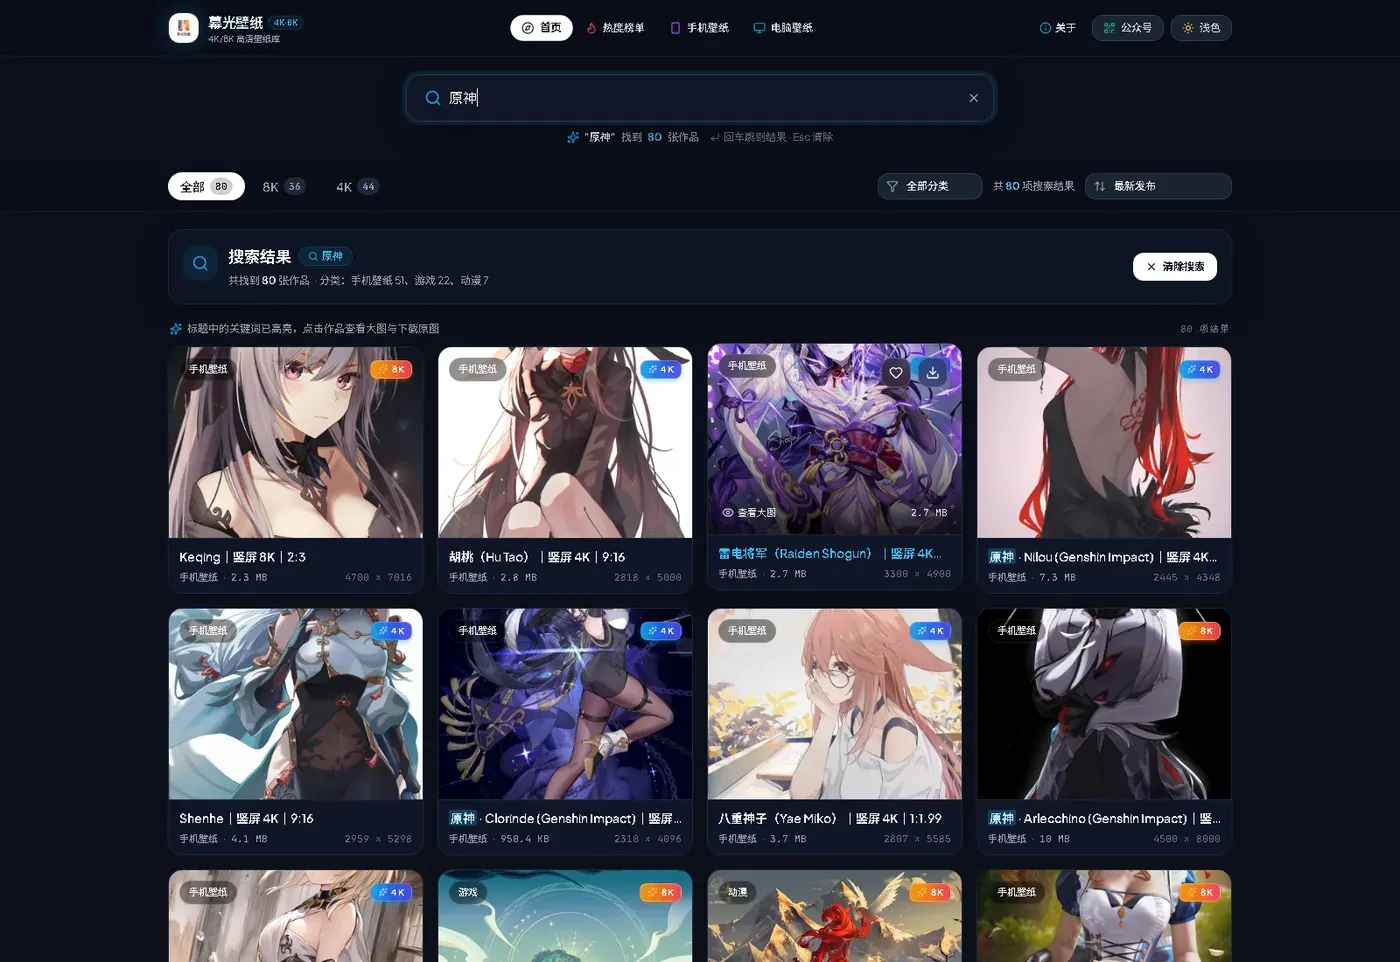
搜“原神”,出来 80 张,纯前端过滤:
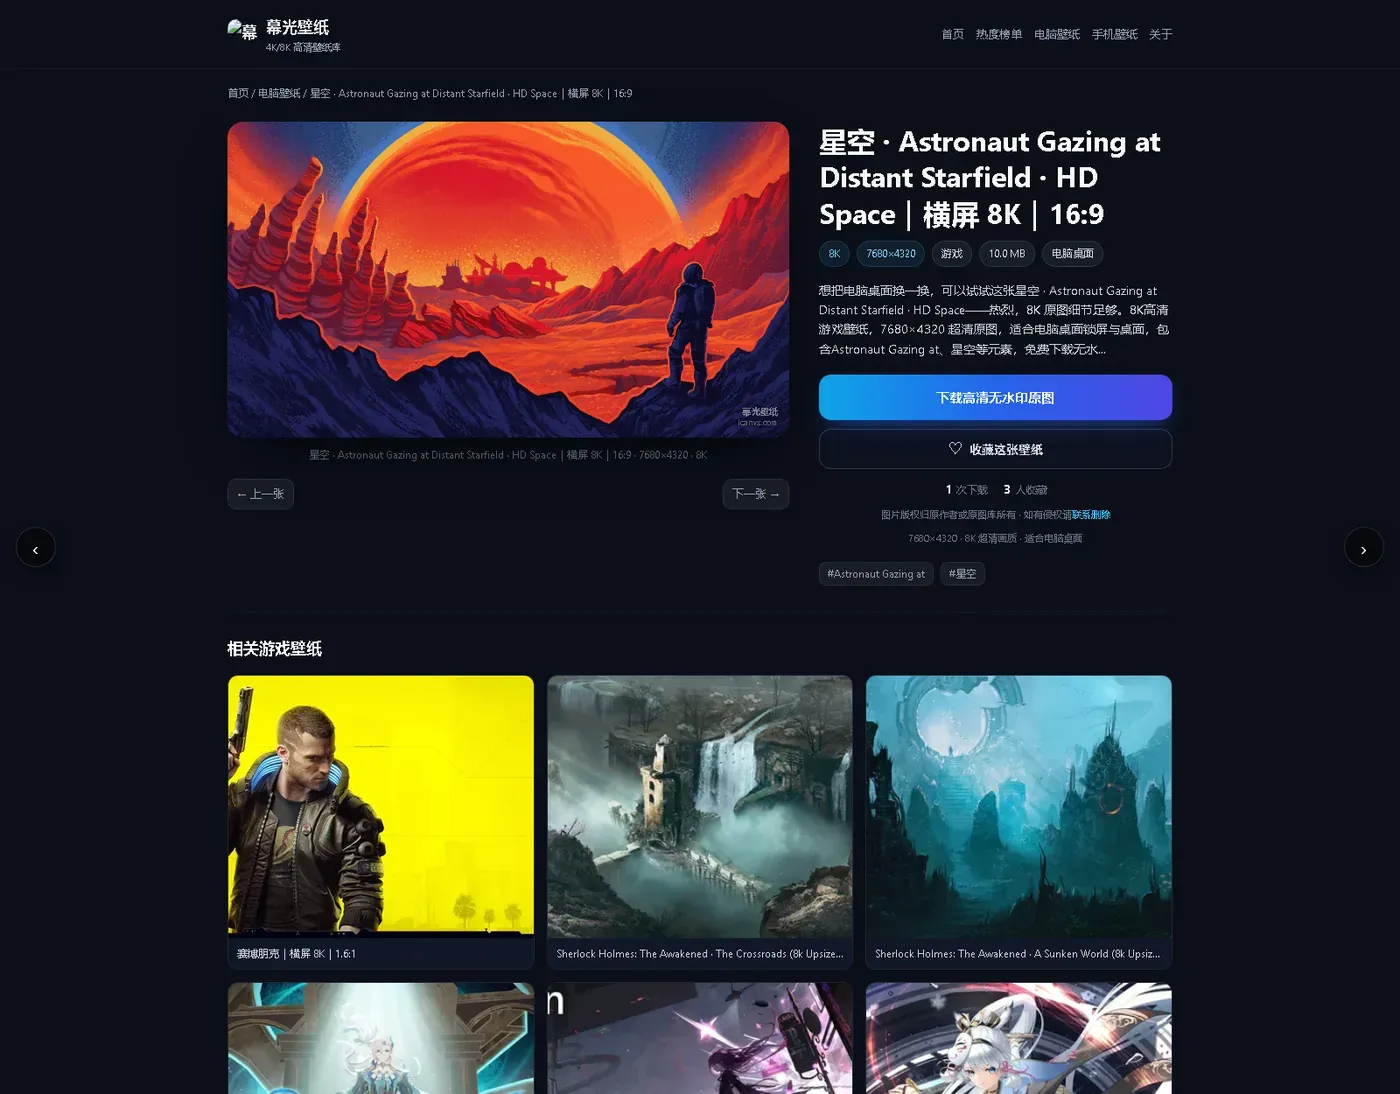
详情页是构建时生成的独立 HTML,分辨率、体积、下载和收藏都在一屏:
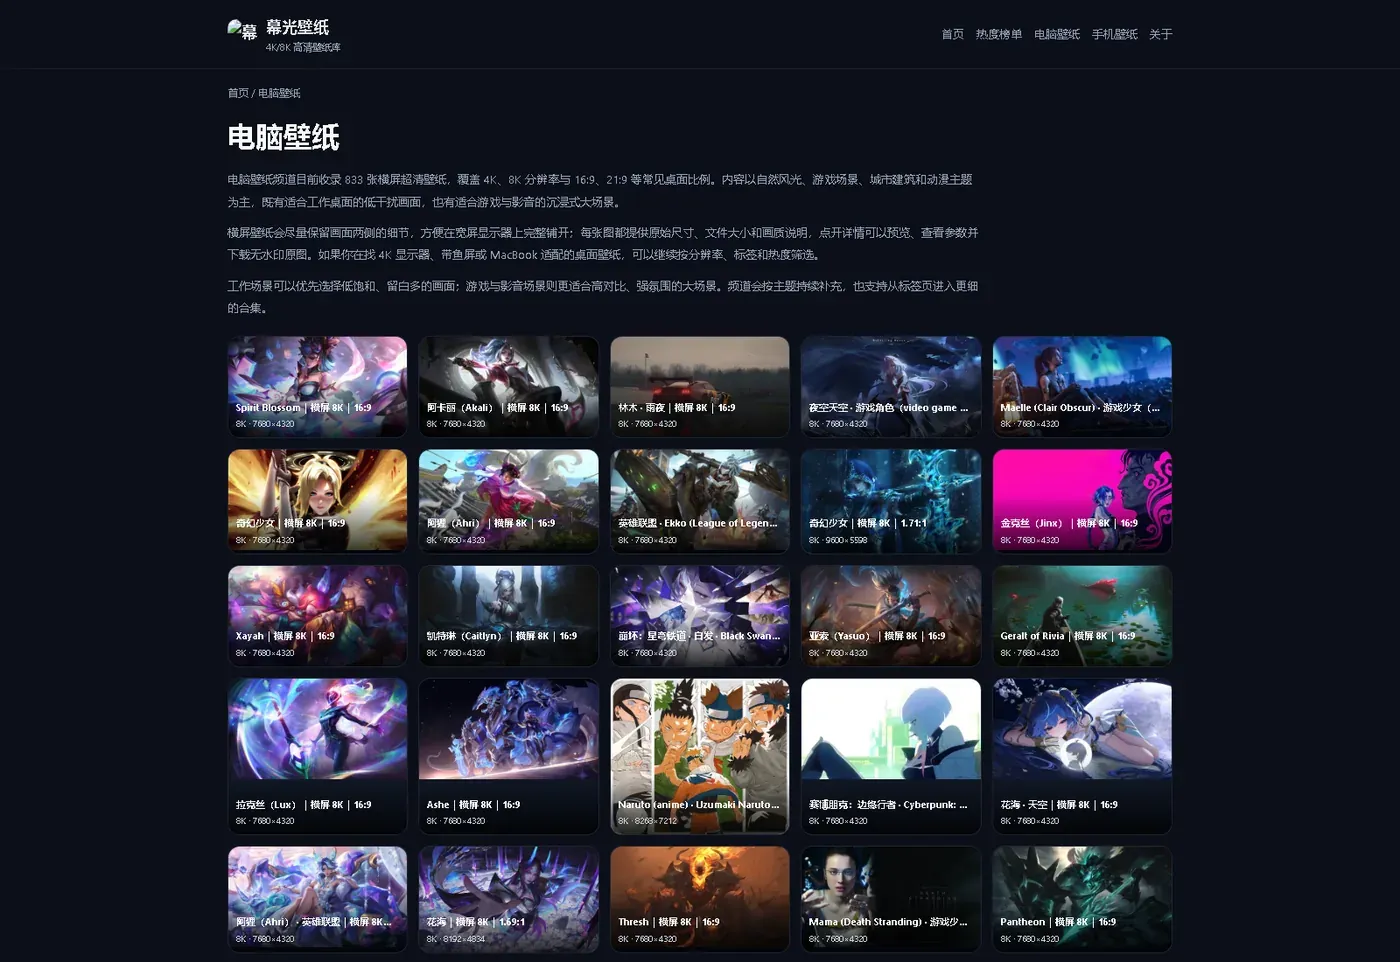
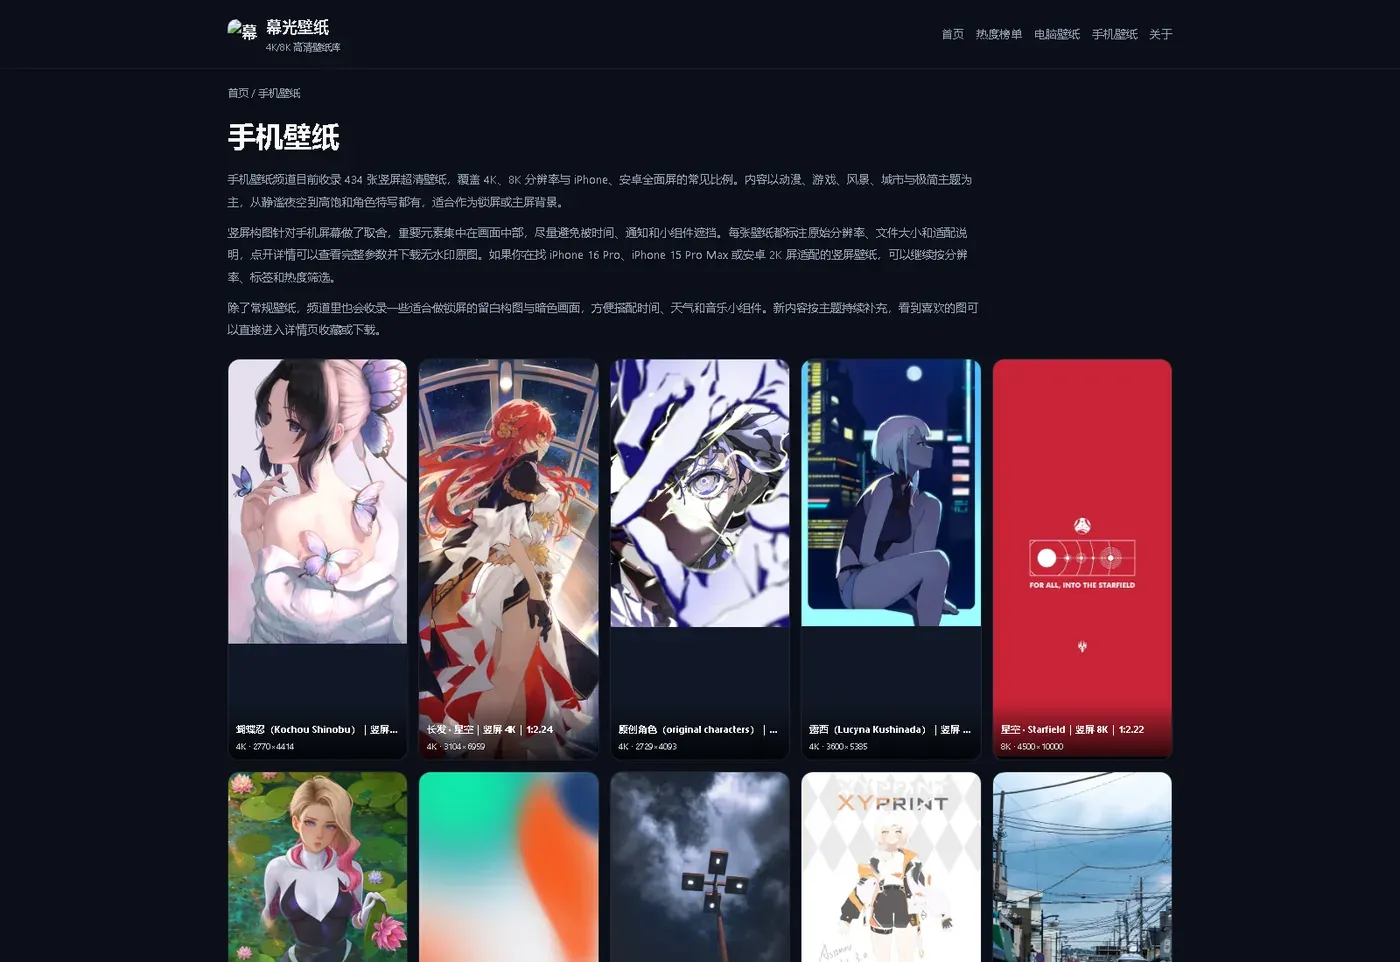
电脑壁纸和手机壁纸是两个独立频道,内容页也是构建时静态生成的:
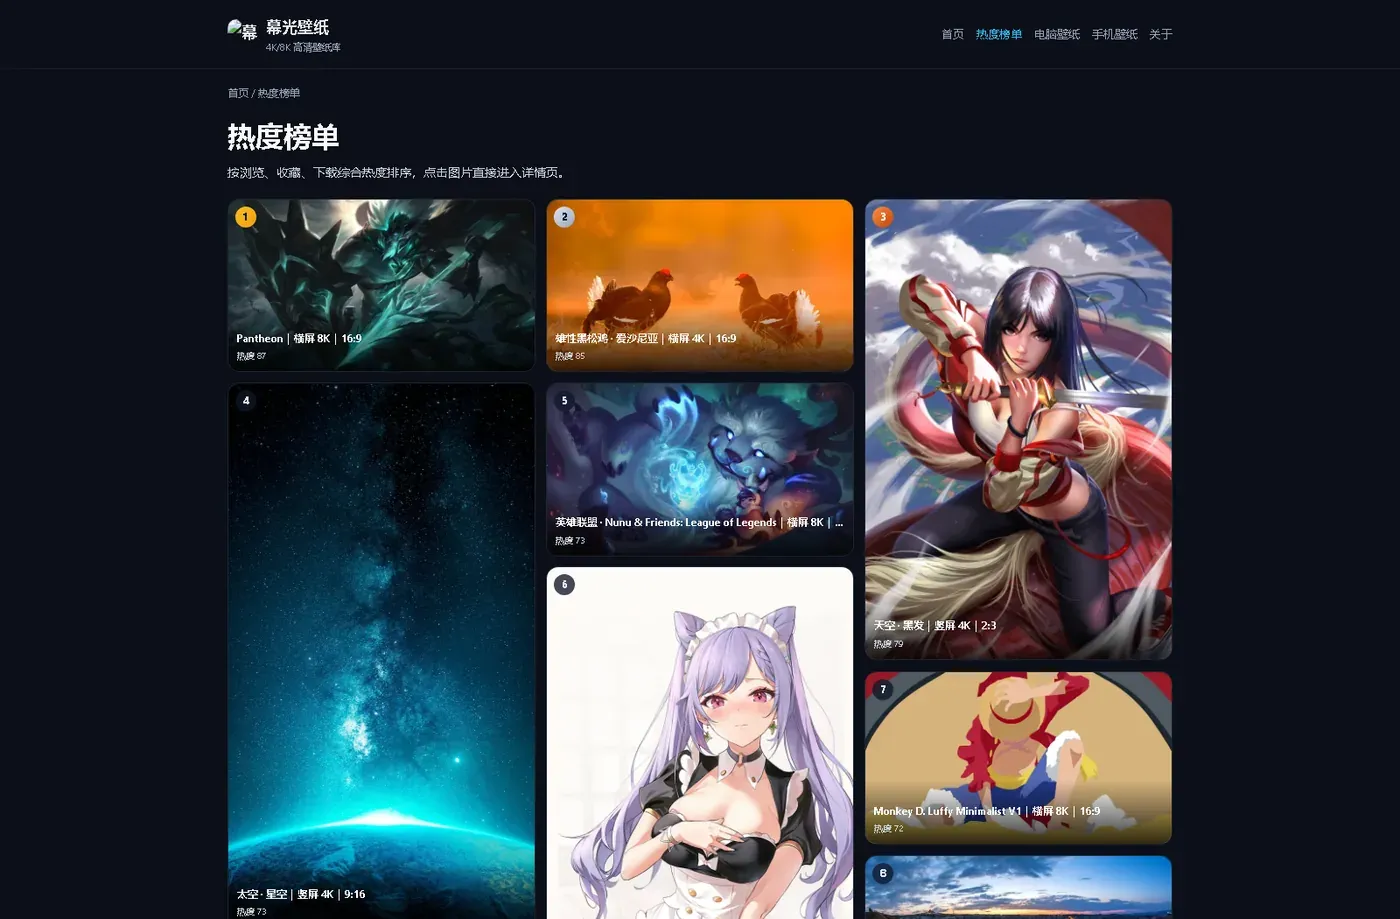
热度榜按浏览、收藏、下载加权排序,数据来自统计接口:
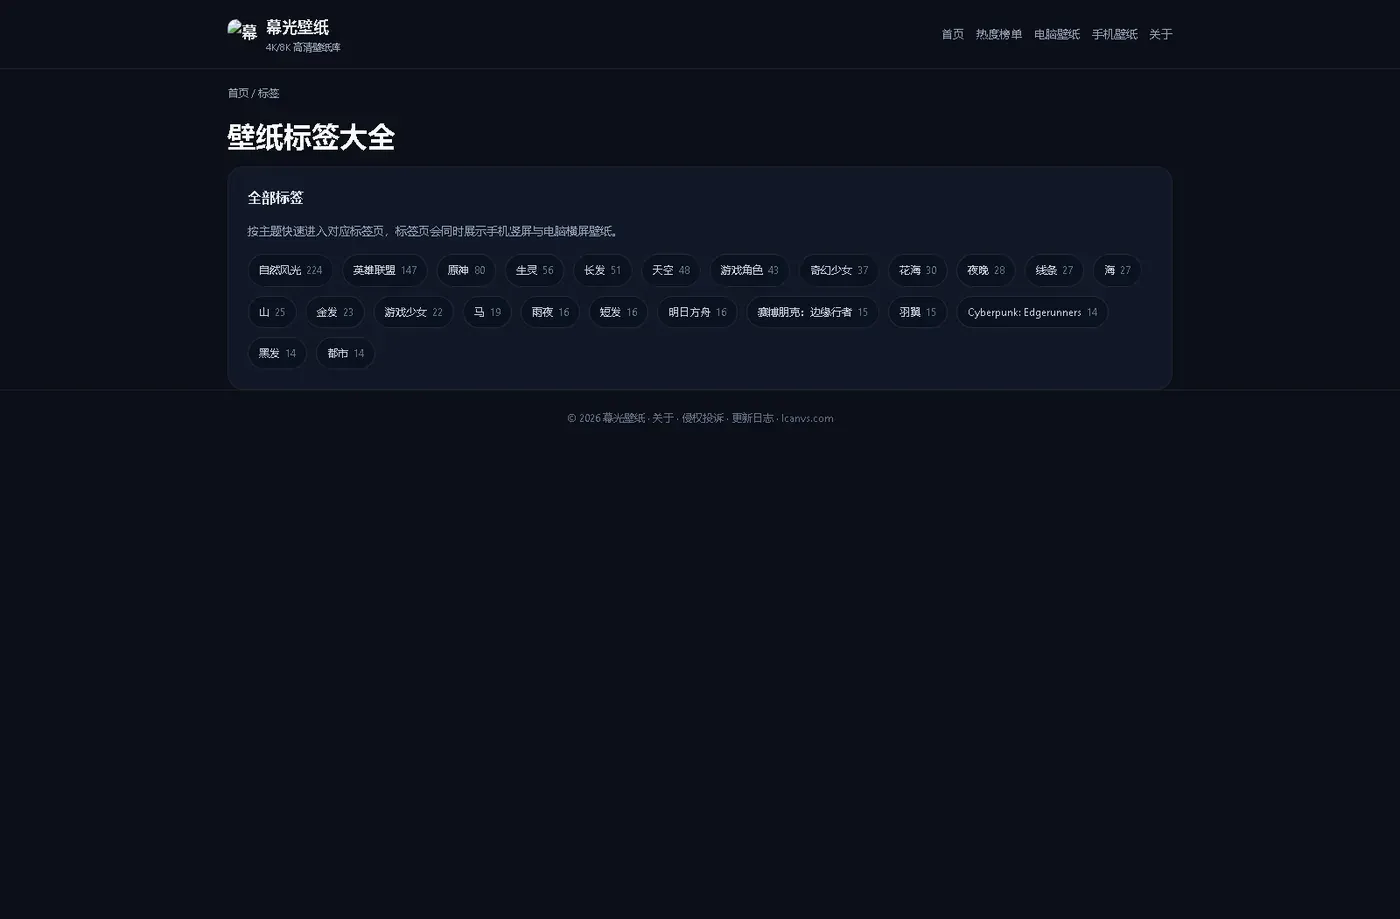
标签页一共 24 个,构建时按标签数量自动生成:
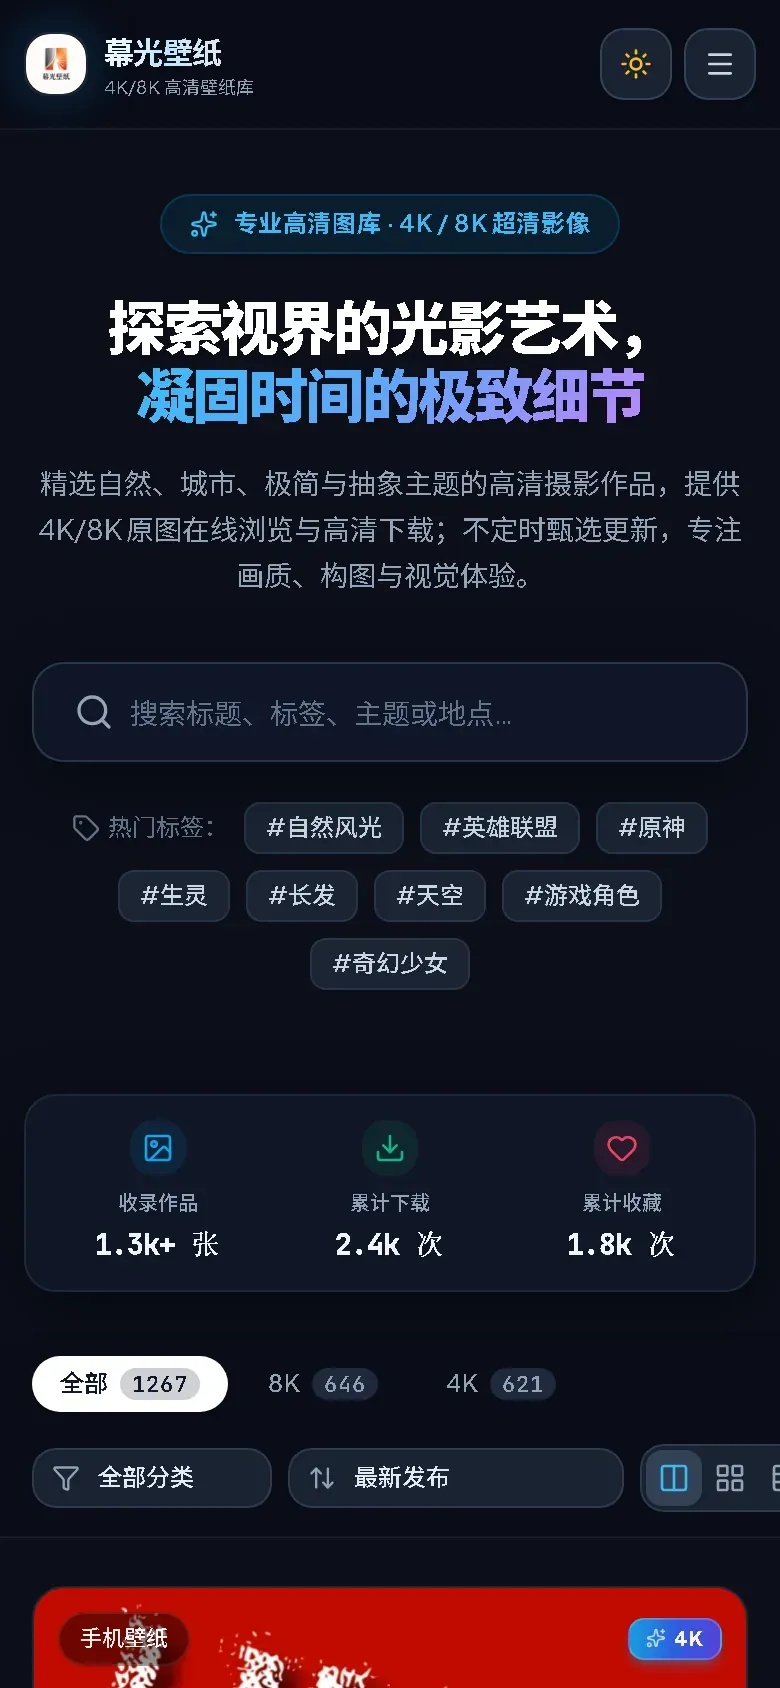
手机端是响应式的,没单独做 App:
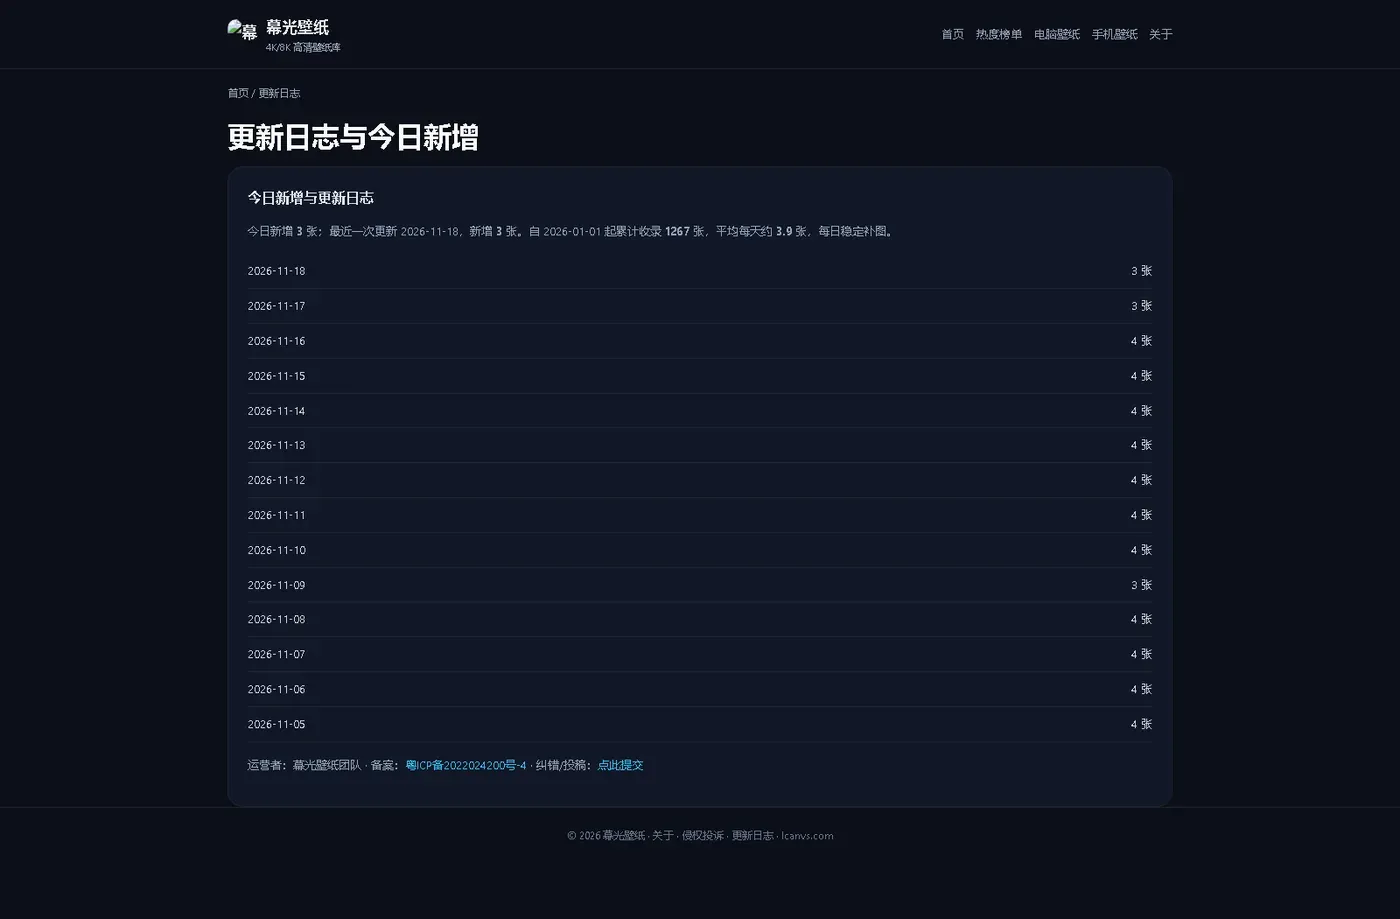
更新日志按天列出新增数量,能看出最近的更新情况:
我为什么敢接这个活
写页面我确实不会。但把网站拆开,它其实是我熟悉的东西:
- 一堆数据;
- 一套模板;
- 一层缓存;
- 一个部署流程。
前端框架只是模板的实现方式。所以我给自己的分工是:页面交给 AI,数据、构建、缓存、部署和防护我自己来。
技术栈大概是这样:
| 层 | 用什么 |
|---|---|
| 前端 | React 18 + TypeScript + Vite + Tailwind(AI 生成,我改数据逻辑) |
| 内容数据 | 一个 gallery.json,构建时生成静态页面 |
| 图片存储 | 七牛云 Kodo + 自定义 CDN 域名 |
| 采集 | Python 3 + Pillow + urllib,线程池并发 |
| 统计 | Cloudflare Worker + D1(推荐默认);有闲置国内机器时也可以用 ECS + SQLite |
| 部署 | npm scripts + qshell + 系统定时器 |
数据流是这样:
国外公开图库 / 壁纸社区
                │
                ▼
        Python 爬虫(校验、生成缩略图、去重)
                │
                ▼
        七牛云 Kodo  photos/...
                │
                ├── gallery.json
                │        │
                │        ▼
                │   Vite 构建:1267 个详情页 + 标签页 + sitemap
                │
                ▼
        CDN(lcanvs.com)──► 浏览器
选型时我给自己定了三条硬约束:内容站不依赖服务器、不维护内容数据库、构建产物必须是纯静态。AI 给的方案只要违反这三条,我就换。统计服务后来放到了另一台已有机器上,不影响主站;没有闲置机器的话,Worker + D1 就够了,后面会讲。
具体怎么用 AI:我把 gallery.json 的字段和页面清单丢给它,让它生成组件骨架;报错直接贴回去;样式不满意就描述效果让它改。现在前端有列表、瀑布流、搜索、筛选、详情、排行榜、主题切换、移动端菜单,都是 AI 一点点加出来的。它有时候会自己发明字段名,或者把分页逻辑写复杂,所以每次改完我都跑一遍构建,看 1267 个页面能不能全生成——能全生成,说明数据契约没被改坏。
我的工作是把关:数据结构、路由、SEO、性能、部署。前端代码里哪块是 AI 写的、哪块是我改的,我自己也分不太清了,但数据契约和构建流程是我定的。
核心约定只有一条:gallery.json 是前后端唯一的数据契约。 爬虫只往里写,前端和构建脚本只读。这样 AI 改前端不会把数据结构改乱,我改爬虫也不用管页面怎么渲染。
坑一:SPA 在搜索引擎眼里是白页
第一版是标准的 React SPA:打开首页,JS 拉 gallery.json,渲染列表,点卡片进详情。
人看着没问题,view-source 一看,HTML 里只有一个 <div id="root"></div>。
百度对 JS 渲染的支持一直一般,我不敢赌。图片站靠长尾搜索,用户搜“星空 8K 壁纸”,得有个能被抓到的 URL,不能是靠 JS 现场拼出来的页面。
于是改成构建时生成静态页
我写了个 generate-photo-pages.mjs,在 vite build 之前跑:
- 遍历 1267 条数据;
- 每条生成一个
public/wallpaper/<slug>.html; - 页面里放真实的
<img>、标题、描述、标签、相关推荐、下载按钮; <head>里写死title、description、canonical、Open Graph 和 JSON-LD。
详情页的 JSON-LD 大概是这样:
{

  "@context": "https://schema.org",
  "@type": "ImageObject",
  "name": "星空 · Astronaut Gazing at Distant Starfield|横屏 8K|16:9",
  "contentUrl": "https://lcanvs.com/photos/2026/space-8k-001.jpg",
  "thumbnailUrl": "https://lcanvs.com/photos/2026/thumbs/space-8k-001.webp",
  "width": 7680,
  "height": 4320,
  "uploadDate": "2026-07-17",
  "encodingFormat": "image/jpeg",
  "creditText": "版权归原作者或原图库所有"
}
slug 用拼音生成:
xing-kong-astronaut-gazing-at-distant-starfield-space-8k-001
不是随便拼的:标题拼音 + 图片 id,既能读,又保证唯一。之前用纯 id 当 URL,搜索结果里全是 8k-001 这种,很难看。
构建前还会跑 generate-sitemap.mjs,现在 sitemap 里有 1299 条 URL(1267 张图 + 分类/标签/静态页)。
结果和代价
- 每张图都有独立 URL、独立标题和描述,百度、Google 拿到的是完整 HTML;
- 标签页、电脑/手机频道页也一起静态化;
- 构建变慢:现在一次完整构建要生成 1267 个详情页,一两分钟;
- 另一个代价是“改模板要重新生成全部页面”,所以模板逻辑得收敛,不能每页写一套。
这一步做完,我才觉得这个站“能被人搜到”,而不是只能自己收藏夹里打开。
坑二:4K/8K 原图不能直接塞进列表
1267 张图,原图加起来 5.12GB,平均一张 4.14MB,8K 的有 646 张。
首页直接加载原图,用户滑两屏流量就几百兆。手机用户直接骂人。
缩略图在上传时就生成
爬虫下载完原图后,用 Pillow 生成一张 720px 宽的 WebP 缩略图,作为独立文件上传:
def make_thumbnail(img_bytes: bytes, width: int = 720) -> bytes:
    im = Image.open(io.BytesIO(img_bytes))
    if im.mode not in ("RGB", "RGBA"):
        im = im.convert("RGB")
    w, h = im.size
    if w > width:
        new_h = int(h * width / w)
        im = im.resize((width, new_h), Image.Resampling.LANCZOS)
    buf = io.BytesIO()
    im.save(buf, format="WEBP", quality=82, method=4)
    return buf.getvalue()
原图和缩略图分别放在:
photos/2026/space-8k-001.jpg
photos/2026/thumbs/space-8k-001.webp
列表用缩略图,详情页用 1200px 的预览图,点“下载原图”才拿 8K 大图。
为什么不直接用七牛的图片处理参数
最开始我用的是 ?imageView2/2/w/720 这种 URL 参数,看起来省事。但七牛的测试域名有两个坑:
- 只支持 HTTP,HTTPS 页面加载会被浏览器当混合内容拦掉;
- 会忽略 URL 查询参数做缓存——缩略图和原图用同一个 key,缓存互相污染。
我当时的症状是:列表里偶尔冒出一张巨大的原图,或者详情页打开是糊的缩略图。查了半天才定位到缓存键。
后来干脆不用参数,所有尺寸都上传成独立文件。用存储换确定性,对个人项目来说这笔账很划算。
坑三:代码改完了,线上还是旧的
这个问题折腾了我一个晚上。
改完标题,npm run build 和 qshell qupload 都返回成功,浏览器打开还是旧标题。Ctrl+F5 有时好有时不好,手机上怎么刷都是旧的。
原因不复杂:七牛云对象默认带
Cache-Control: public, max-age=31536000
而 index.html、data/gallery.json 是固定文件名,不像 assets/ 带哈希。浏览器一年内不会重新请求,CDN 边缘节点也继续返回旧副本。
改缓存头,再主动刷一遍 CDN
写了个 refresh_cdn.py,做两件事:
- 把
index.html、site-info.html、data/gallery.json的Cache-Control改成no-cache; - 调用七牛的 CDN 刷新接口,让边缘节点立即回源。
具体做法是调七牛的 chgm 接口,key 要先 base64:
entry = urlsafe_b64encode(f"{bucket}:{key}".encode("utf-8"))
value = urlsafe_b64encode(b"no-cache")
path = f"/chgm/{entry}/cacheControl/{value}"
现在 daily-crawler 上传完 gallery.json 会自动调一遍,部署脚本最后一步也会调一遍,不用我记。
后来我习惯每次上传前先想一遍:这个文件的缓存键是什么、谁在缓存它、多久失效。后端做缓存的那套思路,放到 CDN 上一样成立。
坑四:本地开发,图片全是 403
线上图片正常,本地 npm run dev 一打开,所有图 403。
原因是我在七牛 CDN 上开了 Referer 防盗链,白名单里只有 https://lcanvs.com。本地页面的 Referer 是 http://localhost:5173/,直接被拒。
本地加一层代理,替请求带上 Referer
在 Vite 的 dev/preview 配置里加一个代理:
/qiniu-media/* → https://lcanvs.com/*
代理请求时把 Referer 改成 https://lcanvs.com/。前端配置里加一个开关:
localProxy: 'auto', // 只在 localhost / 127.0.0.1 时启用
这样本地能正常看图,线上也不会多一层代理。
后来我才发现,防盗链开起来不只是线上生效,本地开发也会被它挡。换成自定义域名 + HTTPS 之后,线上不再依赖测试域名;本地代理我留着了,偶尔还要用。
坑五:950 张图一次导入,最怕传到一半
回到开头那批图。
950 张,平均 4MB 一张,按当时的上传速度,全部传完要几个小时。中间网络抖一下、进程崩一次,就得回答三个问题:
- 哪些传上去了?
- 哪些只传了原图、没传缩略图?
- 重跑一遍会不会产生重复数据?
第一次做批量导入的时候,我没想清楚这三个问题,结果就是反复重传、列表里出现重复、gallery.json 还写坏过。后来把整个流程按“幂等 + 可恢复”重写了一遍,才敢放心批量跑。
把导入改成可以重跑
现在的流程是这样:
- 先拉云端文件清单。按前缀列出已经存在的 key,放进一个 set;处理每张图之前先查 set,命中就跳过,不重复下载、不重复上传。
- 原图和缩略图分开判断。原图存在但缩略图缺失的,只补缩略图,不重传原图。
- 上传前校验。Pillow 打开,宽高不达标直接丢弃;文件太小或者打不开的也丢弃,避免把坏图写进库。
- 元数据缓存。标题、分类、翻译结果按 id 缓存在本地,重跑时不用重新请求和翻译。
- 写入原子化。
gallery.json先写临时文件,再os.replace覆盖,进程中途被杀也不会留下半个 JSON。 - 失败可重试。每张图独立处理,失败的记日志,下次只跑失败的,不影响已经成功的。
关键的几段:
# 1. 云端 key 去重
existing = list_qiniu_keys(prefix)
if image_key in existing and not force:
    return None, "skip"

# 2. 原图在、缩略图不在,只补缩略图
need_image = image_key not in existing
need_thumb = thumb_key not in existing
# 3. 原子写 gallery.json
def _atomic_write_text(path, text):
    tmp = path + ".tmp"
    with open(tmp, "w", encoding="utf-8") as f:
        f.write(text)
    os.replace(tmp, path)
最后的结果是:这批 950 张可以分几次跑,断了就续,重复执行也不会多出一条数据。现在库里 1267 张,批量导入占了大半。
记住三件事
批处理任务,先把三件事想清楚再写代码:幂等、可恢复、可观测。
- 幂等:同一张图处理十次,结果和一次一样;
- 可恢复:断了能从断点继续,而不是从头再来;
- 可观测:每一张图成功还是失败、失败原因是什么,日志里能查到。
想清楚这三点,批量导入就不用靠运气了。
静态站也需要后端:统计和防刷
纯静态站有个硬伤:访客点了下载、点了收藏,这些数据没地方写。
要么不做统计,要么单独找个地方写。我选了后者,于是有了 stats-worker。
第一版:Cloudflare Worker + D1
需求很简单:
- 记录每张图的下载、收藏、浏览;
- 同一访客同一张图,每天只算一次下载,收藏只算一次;
- 前端拿不到统计时不要把本机数据冒充成全站数据。
为什么用 D1 不用 KV:计数是典型的 read-modify-write,KV 不是原子的,高并发下会丢计数;D1 有唯一约束和原子自增,正好。
去重靠唯一索引 + INSERT OR IGNORE:
const insert = await db
  .prepare(
    `INSERT OR IGNORE INTO visitor_downloads (visitor_id, photo_id, day, created_at)
     VALUES (?, ?, ?, ?)`
  )
  .bind(visitorId, photoId, day, now)
  .run();

const counted = Number(insert?.meta?.changes || 0) > 0;
if (counted) {

  await db
    .prepare('UPDATE photo_stats SET downloads = downloads + 1 WHERE photo_id = ?')
    .bind(photoId)
    .run();
}
按北京时间分自然日:
const day = new Date(now + 8 * 60 * 60 * 1000).toISOString().slice(0, 10);
另一套:ECS + SQLite(有闲置国内机器再说)
如果你手上没有现成的空闲服务器,直接用 Cloudflare Worker + D1。免费额度对个人站够用,不用管进程、nginx、证书,部署就一条 npx wrangler deploy。
我多写一套,是因为我本来就有一台跑博客 ltomato.com 的阿里云 ECS,机器一直开着,空着也是空着。Worker 国内访问时快时慢,有时候要等好几秒,统计不是核心功能,可一直转圈也难看,于是照着同一份接口用 Python + SQLite 写了一个:
GET /api/stats、GET /api/rankingPOST /api/downloads、POST /api/likes、POST /api/views- nginx 反代到
https://stats.lcanvs.com - systemd 托管,
Restart=always,内存限制 128M
前端只改一个环境变量:
VITE_STATS_API_BASE=https://stats.lcanvs.com
接口协议不变,两套实现可以随时切。这是我觉得“后端思维”最占便宜的地方:先把接口定死,实现随便换,迁移成本就是改一行 .env。
顺带一提,博客和统计服务共用一台机器,成本就是本来就要付的那份。如果你也有闲置的国内机器,这种小接口放上去确实比绕一圈 Workers 舒服;没有的话,别为了统计专门买服务器。
防刷是分层的
图片站最怕的是被人批量下载把 CDN 流量刷爆,没人看反而不怕。现在大概有这几层:
- CDN:Referer 白名单、UA 黑名单(curl / python-requests / scrapy 这些),控制台里再配用量封顶和告警;
- 下载接口:Cloudflare Turnstile 人机验证 + 每日次数限制(访客 30 次/天,IP 是 3 倍);
- 统计接口:匿名访客 ID 去重、参数格式校验、CORS 来源限制。
这些只能提高成本,挡不住决心足够的人。真要彻底防,得把原图放私有空间、由服务端签发短链,改动太大,暂时没做。
采集、清洗、自动化
内容来自几个国外的公开图库和壁纸社区:有的提供公开 API,有的只有公开列表页。优先选来源可查、允许公开访问的内容,脚本只处理公开列表,不碰需要登录、付费或者绕过验证的资源。也遇到过只给榜单、不给公开原图的站,这种就只做索引,不硬抓。
采集里花时间最多的不是“抓”,是这些:
- 去重:先拉云端文件清单,已存在的 key 直接跳过,几百张图不用重复上传;
- 校验:Pillow 打开,宽高不达标直接丢,避免把糊图传上去;
- 标题和分类:英文标题翻译后缓存,中文标题清洗掉版权后缀,再按关键词归类(风景/城市/建筑/动物/人文/极简);
- 缩略图:下载时顺手生成,不额外跑一遍;
- 并发:下载能到 1.6MB/s,上传只有 0.11MB/s 左右——上传才是瓶颈,线程开再多也没用。
我平时所有操作都在终端里,图形界面只用来确认结果。日常大概就是这几条:
# 1. 构建:重新生成 1267 个详情页、标签页和 sitemap
npm run build

# 2. 上传构建产物(jemy/qupload.json 指向 web/dist)
qshell qupload jemy/qupload.json

# 3. 刷 CDN 缓存
python refresh_cdn.py

# 4. 采集最近 7 天(在 daily-crawler/ 下运行)
cd daily-crawler && python crawler.py --days 7 --threads 4
定时任务也是同一条命令,交给系统定时器,每周日 23:50 跑一次,日志写到 daily-crawler/logs/weekly.log。定时器只负责触发,逻辑都在脚本里,换机器不用改代码。换到 Linux 的话,一行 crontab 就够:
50 23 * * 0 cd /path/to/daily-crawler && python crawler.py --days 7 --threads 4 >> logs/weekly.log 2>&1
统计服务的部署同样是一条命令:
# Cloudflare Worker 版
npx wrangler deploy

# ECS 版
sudo systemctl restart lcanvs-stats
页面保留来源说明、许可信息和侵权投诉入口,收到有效通知会下架对应内容。这部分没什么技术含量,但做内容站绕不开。
现在日常维护基本就是每周看一眼日志,其他时间不用管。
现在的样子和成本
几个数字:
- 1267 张图,5.12GB 原图,646 张 8K;
- 电脑端 833 张、手机端 434 张,24 个标签页;
- 1299 条 sitemap URL;
- 2411 次下载、1831 次收藏(截图时);
- 构建一次一两分钟,部署一次几分钟。
成本:
- 域名 + 备案(一次性);
- 七牛云存储 + CDN(按量,个人站量级很小);
- 一台最低配 ECS 跑统计和 nginx;如果本来没有,这笔钱可以省,直接用 Worker + D1;
- 没有前端服务器,没有数据库运维(内容库就是那个 JSON)。
目前站点没有广告,也不用登录,打开就能下原图。
还没做好的
- 搜索是纯前端过滤,
gallery.json已经 865KB(gzip 后 98KB),图再多就得换方案; - 分类和标签靠关键词规则,规则不可能全覆盖,偶尔会分错;
- 收藏没有账号体系,靠浏览器里的匿名访客 ID 识别,换设备就没了;
- 手机端详情页还是偏“桌面缩小版”,有空再单独排一版。
如果重来一次,我会改三件事:
- 第一天就做静态生成,不要先 SPA 再补;
- 先想缓存键,再选文件名和上传方式;
- 批量导入一开始就按幂等 + 断点续传来设计,别等重传几次才补。
给跟我一样的后端同学
如果你也不会前端,但想独立做一个内容站,我的建议是:把前端当构建产物,不是运行时服务。数据 → 模板 → 静态文件,这条路对个人项目最稳,CDN 能扛、成本低、SEO 友好。
数据即接口。先把 JSON 结构定下来,爬虫、构建脚本、前端都围着它转,AI 改前端时你只需要保证契约不变。
缓存、防盗链、限流、去重,这些本来就是后端的老本行。放到静态站和 CDN 上,逻辑没变,只是对象从 Redis/数据库变成了文件和边缘节点。
AI 是加速器,不是架构师。它很擅长写我不熟的 React 组件、Tailwind 样式、TypeScript 类型;信息架构、缓存策略、数据模型、防刷方案,还是得自己定。它给的代码要 review,尤其是状态管理和性能相关的部分。
先上线,再优化。我第一版也丑、也慢、也有一堆硬编码,但只有先跑起来,才知道下一个该修什么。
站点在这里:https://lcanvs.com
目前 1267 张图都按电脑/手机、分类和标签整理好了,不用注册就能下原图。我平时把建站、运维的零碎记录写在博客 ltomato.com,也欢迎来逛。如果你也在做类似的项目,或者对某个坑有更好的处理方式,欢迎交流。
