
给大模型接上对象存储,听起来像个小需求:把文件传上去、拿下来、给个地址。真做起来才发现,难的不是调 OSS 的 API,而是让模型知道该调哪个 Bucket、知道路径怎么拼、知道哪些操作会删东西。
这篇文章记的是我写的 oss-mcp-server:一个用官方 MCP Python SDK 搭的阿里云 OSS 服务端,11 个工具,1452 行源码,188 条断言全绿,已经发到 PyPI 和 Official MCP Registry。
下面每一个数字都是在这个仓库里跑出来的,不是估的。
一、它长什么样
先看整体。客户端(MCP 客户端 / Agent)通过 stdio 或 HTTP 连到服务,服务层做分组路由,底层是 oss2 SDK。
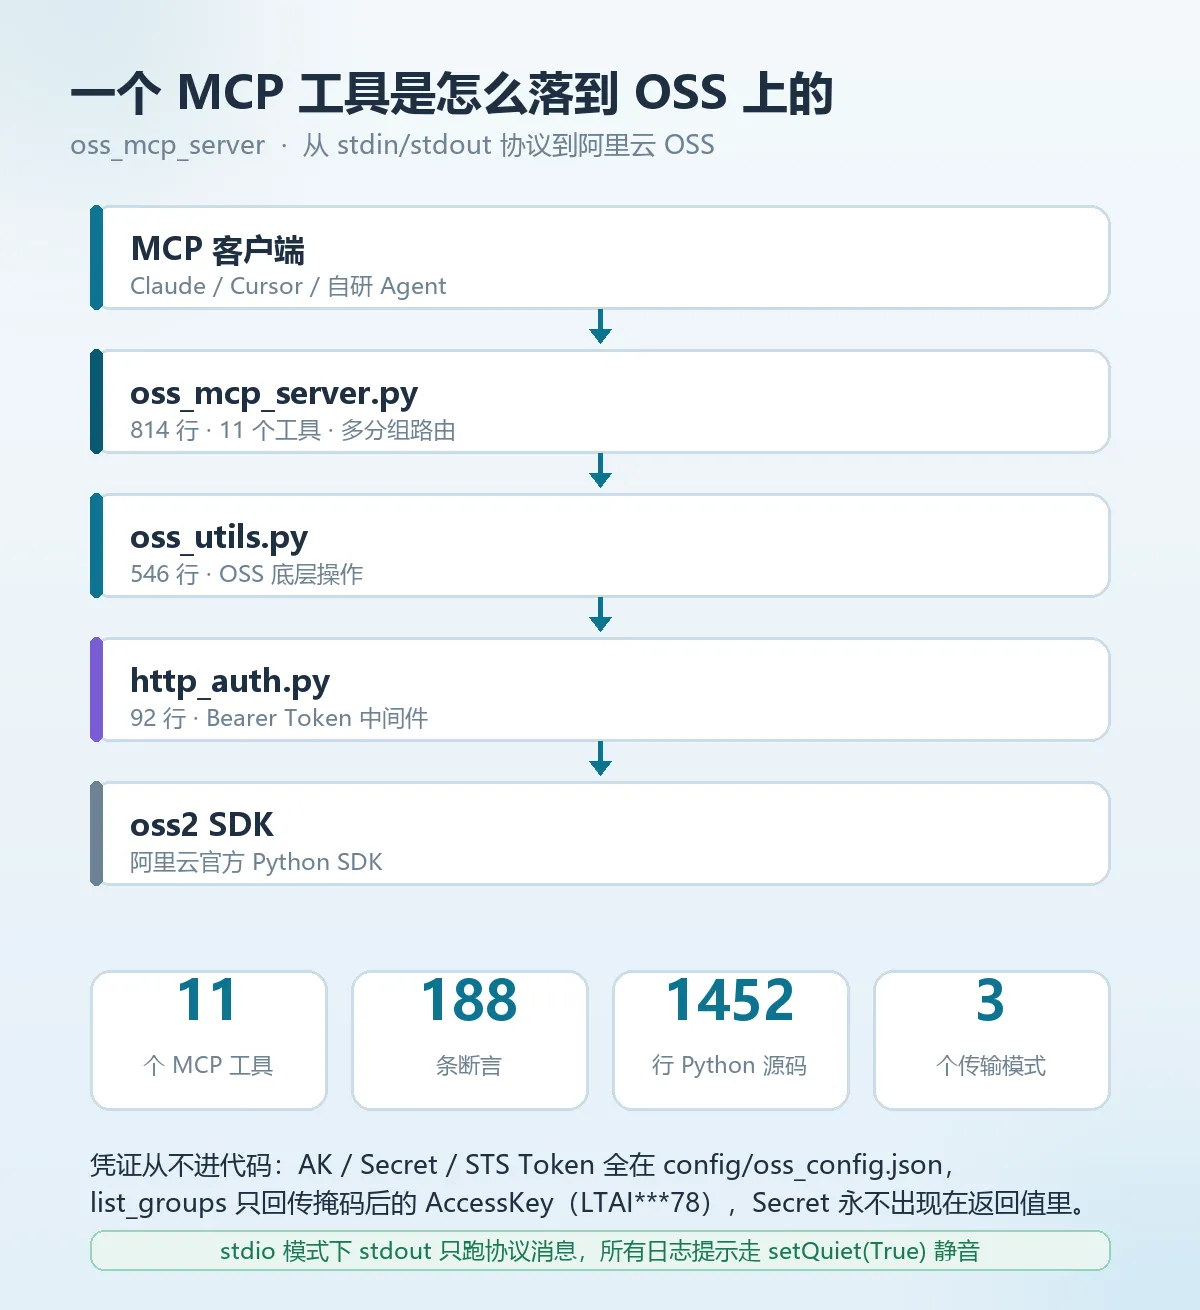
三个文件,各有分工:
| 文件 | 行数 | 职责 |
|---|---|---|
src/oss_mcp_server.py |
814 | MCP 工具定义、多分组路由、命令行与启动逻辑 |
src/oss_utils.py |
546 | OSS 底层操作:上传、替换、下载、打包、删除、签名 URL |
src/http_auth.py |
92 | HTTP 模式的 Bearer Token 认证中间件 |
服务基于 mcp SDK 的 FastMCP,总共 11 个工具:
mcp = FastMCP(
    "oss-utils",
    instructions=("阿里云 OSS 工具,支持多组 AccessKey 认证配置。..."),
)

@mcp.tool(
    annotations=ToolAnnotations(
        readOnlyHint=False, destructiveHint=True,
        idempotentHint=False, openWorldHint=True,
    ),
)
def replace_file(local_path, object_name, keep_original_name=True, acl=None, group=None) -> dict:
    ...
这里有个细节值得说:ToolAnnotations 里的 destructiveHint 不是装饰。模型在决定「要不要调这个工具」时会读它。只有 3 个工具标了 destructiveHint=True:
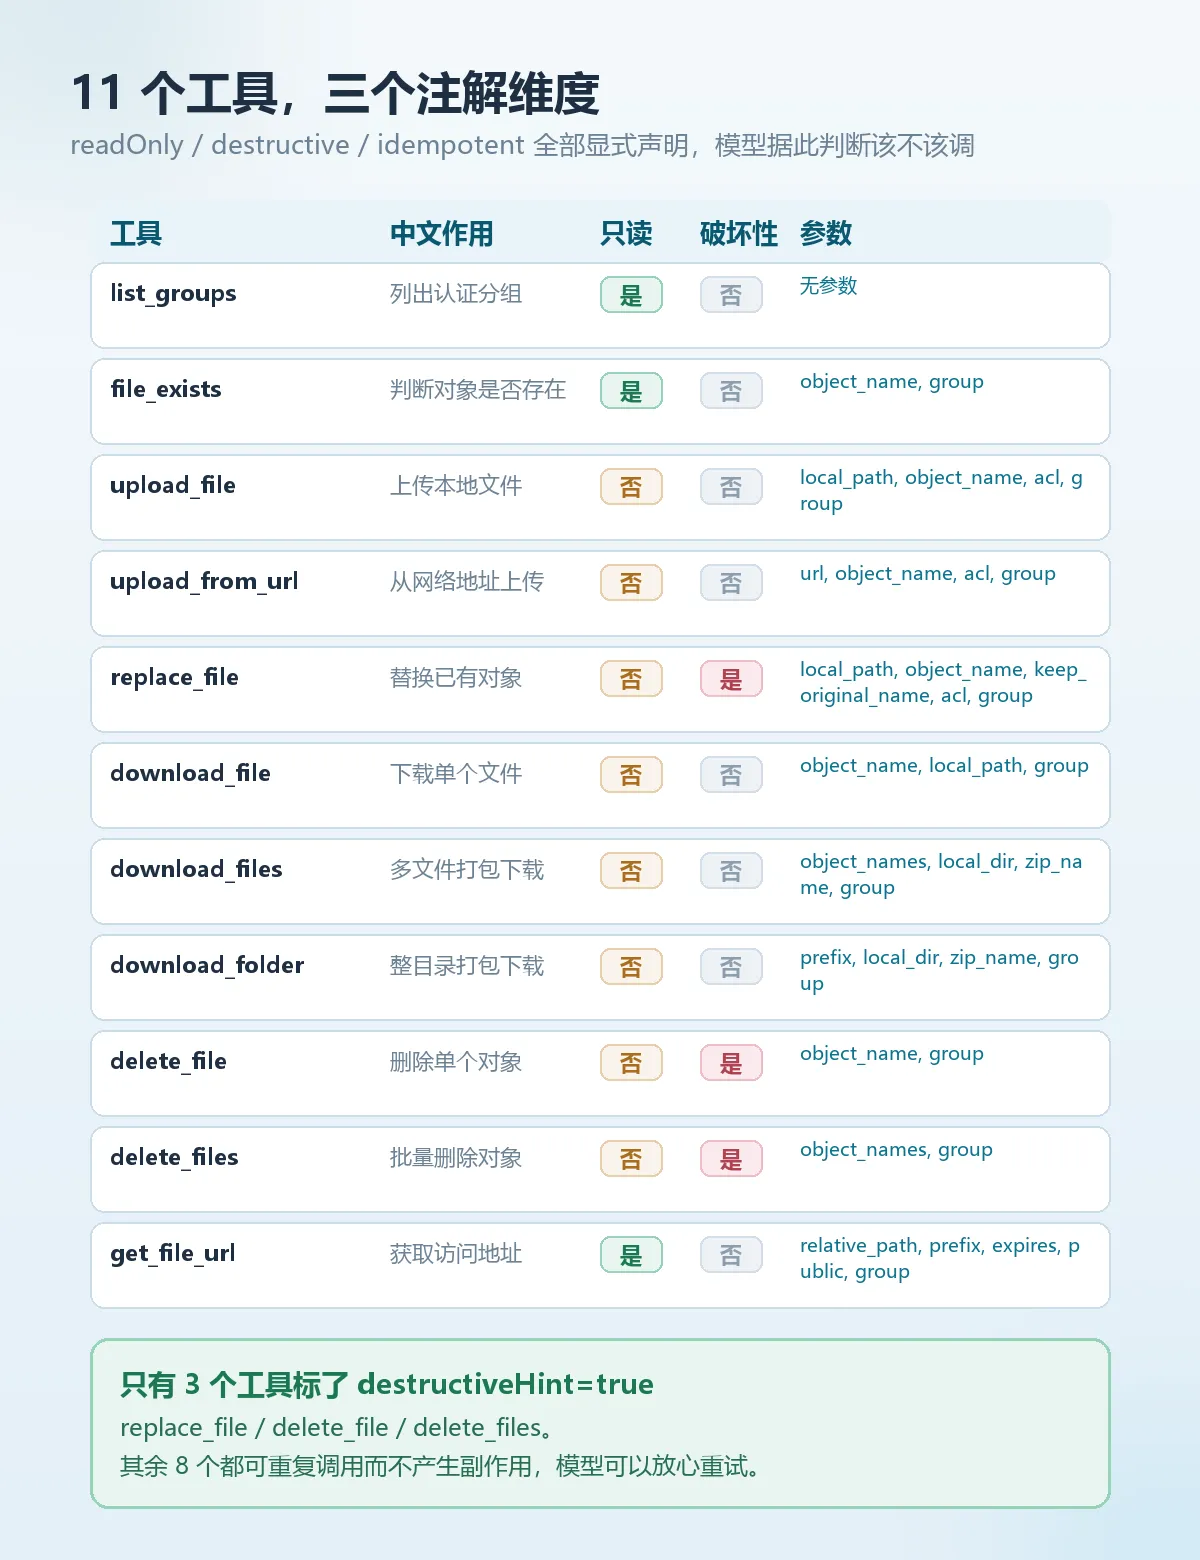
replace_file、delete_file、delete_files。其余 8 个都可以重复调用而不产生副作用,模型可以放心重试。
二、最核心的设计:多分组 + 别名路由
这是整个项目最花心思的地方。
我手上有不止一个 OSS Bucket:生产的、测试的,可能还有第三方的。它们 Endpoint 不同、Bucket 不同、有的公共读有的私有、有的还带 STS 临时凭证。以前的做法是起多个 MCP Server,客户端里配一堆条目,切 Bucket 要改配置。
我的做法是:一个服务,多组配置,工具参数里带 group。
配置文件长这样(config/oss_config.json,注意 AK 要从 example 复制出来填):
{

  "default_group": "prod",
  "http_bearer_token": "",
  "groups": {

    "prod": {

      "alias": "生产",
      "access_key_id": "LTAI5tXXXX",
      "access_key_secret": "XXXX",
      "endpoint": "oss-cn-hangzhou.aliyuncs.com",
      "bucket": "prod-bucket",
      "domain": "https://static.example.com",
      "default_prefix": "",
      "public_read": true
    },
    "test": {

      "alias": "测试",
      "aliases": ["测试OSS"],
      "access_key_id": "LTAI5tYYYY",
      "access_key_secret": "YYYY",
      "security_token": "",
      "endpoint": "oss-cn-shanghai.aliyuncs.com",
      "bucket": "test-bucket",
      "public_read": false
    }
  }
}
2.1 别名怎么匹配
用户说「从测试 OSS 下载」,模型怎么知道该用哪组?
我在 _name_variants 里做了一层后缀变体:分组名和别名去空格、忽略大小写,然后自动补 / 去 oss、云存储 这两个常见后缀。于是「测试」「测试OSS」「测试oss」都能命中同一个分组。
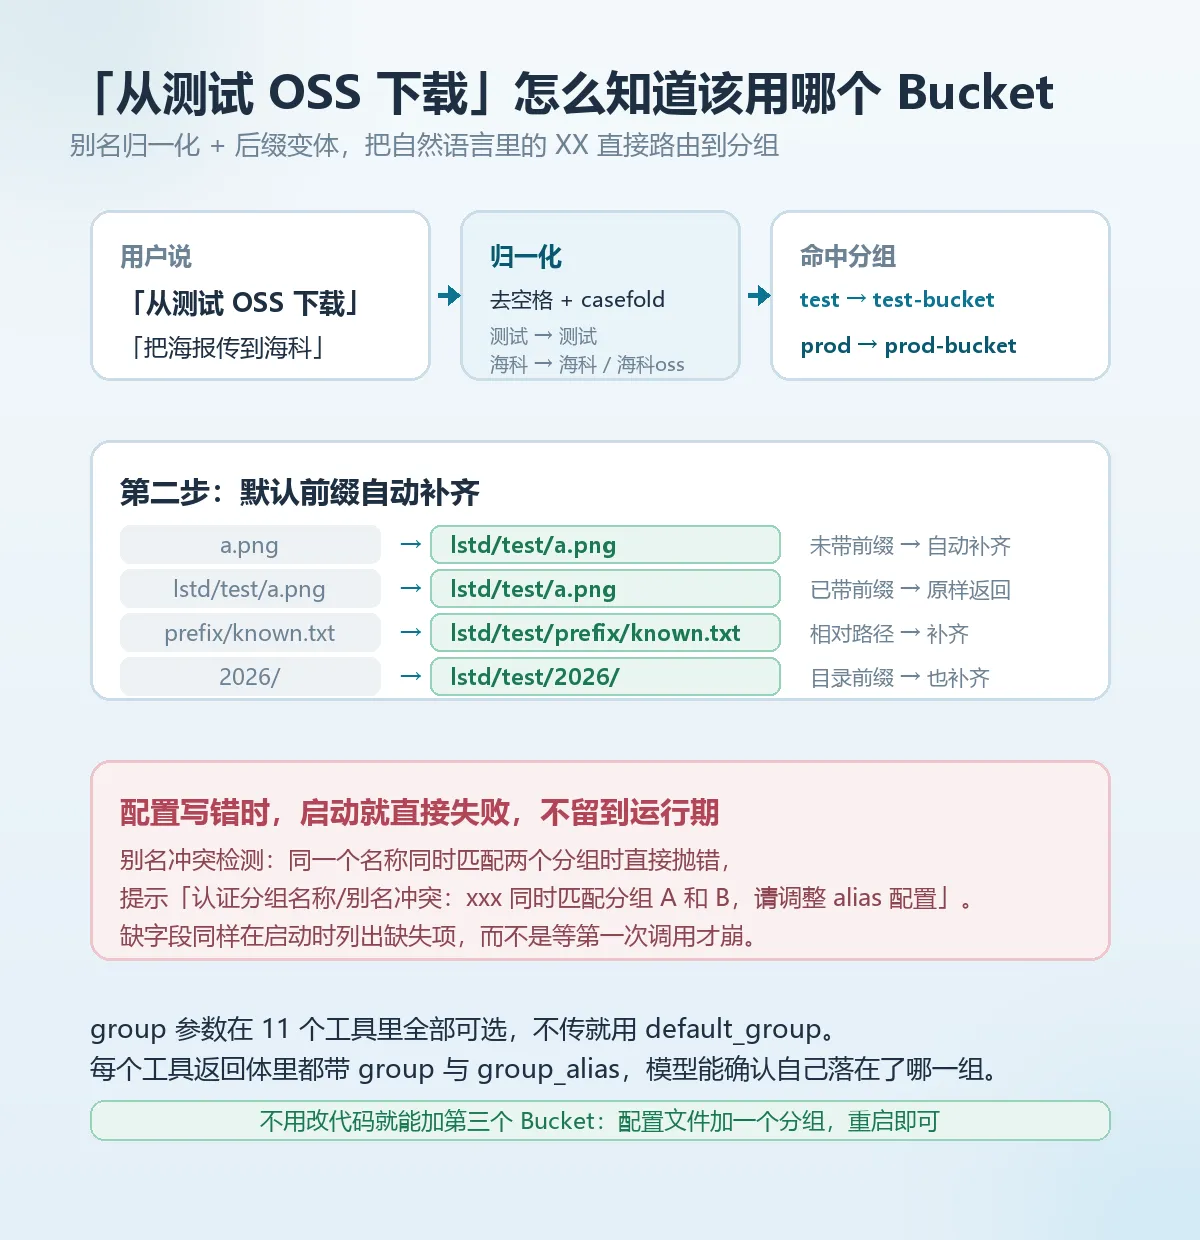
匹配表是启动时构建的,冲突直接在启动时抛错,不留到运行期:
owner = lookup.get(key)
if owner and owner != name:
    raise ValueError(
        f"认证分组名称/别名冲突:'{display_name}' 同时匹配分组 {owner} 和 {name},请调整 alias 配置"
    )
我觉得这比运行到一半才发现传错组要好得多——写错配置是一秒钟的事,跑到一半才发现文件进了错误的 Bucket,那是事故。
匹配上之后,别名信息还会被写回工具描述:
def _refresh_tool_help():
    """把分组别名写入工具描述和 group 参数说明,便于模型直接按别名选组"""
    for tool in tool_manager.list_tools():
        properties["group"]["description"] = (
            f"认证分组名称或别名,不传则使用默认分组。{help_text}"
        )
        tool.description = f"{base_description}\n\n{help_text}"
模型在选工具时读到的描述里就带着「当前有哪些分组、分别叫什么」,不用再调一次 list_groups 去问。
2.2 默认前缀自动补齐
第二个坑是路径。每个 Bucket 有自己的目录约定,比如测试组的文件都要放在 lstd/test/ 下面。如果让模型每次都自己拼全路径,它会拼错——拼少了文件落到根目录,拼多了变成 lstd/test/lstd/test/a.png。
我在 normalizeObjectName 里统一处理:
def normalizeObjectName(object_name, default_prefix=None):
    """归一化 OSS 对象路径:未以默认前缀开头时自动补齐,已带前缀时保持不变"""
    if not default_prefix:
        return name
    prefix = default_prefix.strip().lstrip('/')
    if not prefix.endswith('/'):
        prefix += '/'
    # 对象本身等于前缀根目录(不带末尾 /)时也视为已带前缀
    if name == prefix.rstrip('/') or name.startswith(prefix):
        return name
    return prefix + name
规则就一条:没带前缀就补上,带了就不重复补。所有工具——上传、下载、删除、查 URL——都走这一个函数,所以不会出现「上传补了前缀、删除没补」这种不一致。
三、认证:对外暴露之前先想清楚谁能连
HTTP 模式支持 streamable-http 和 sse 两种传输,监听地址可以配。既然能对外,就必须有认证。
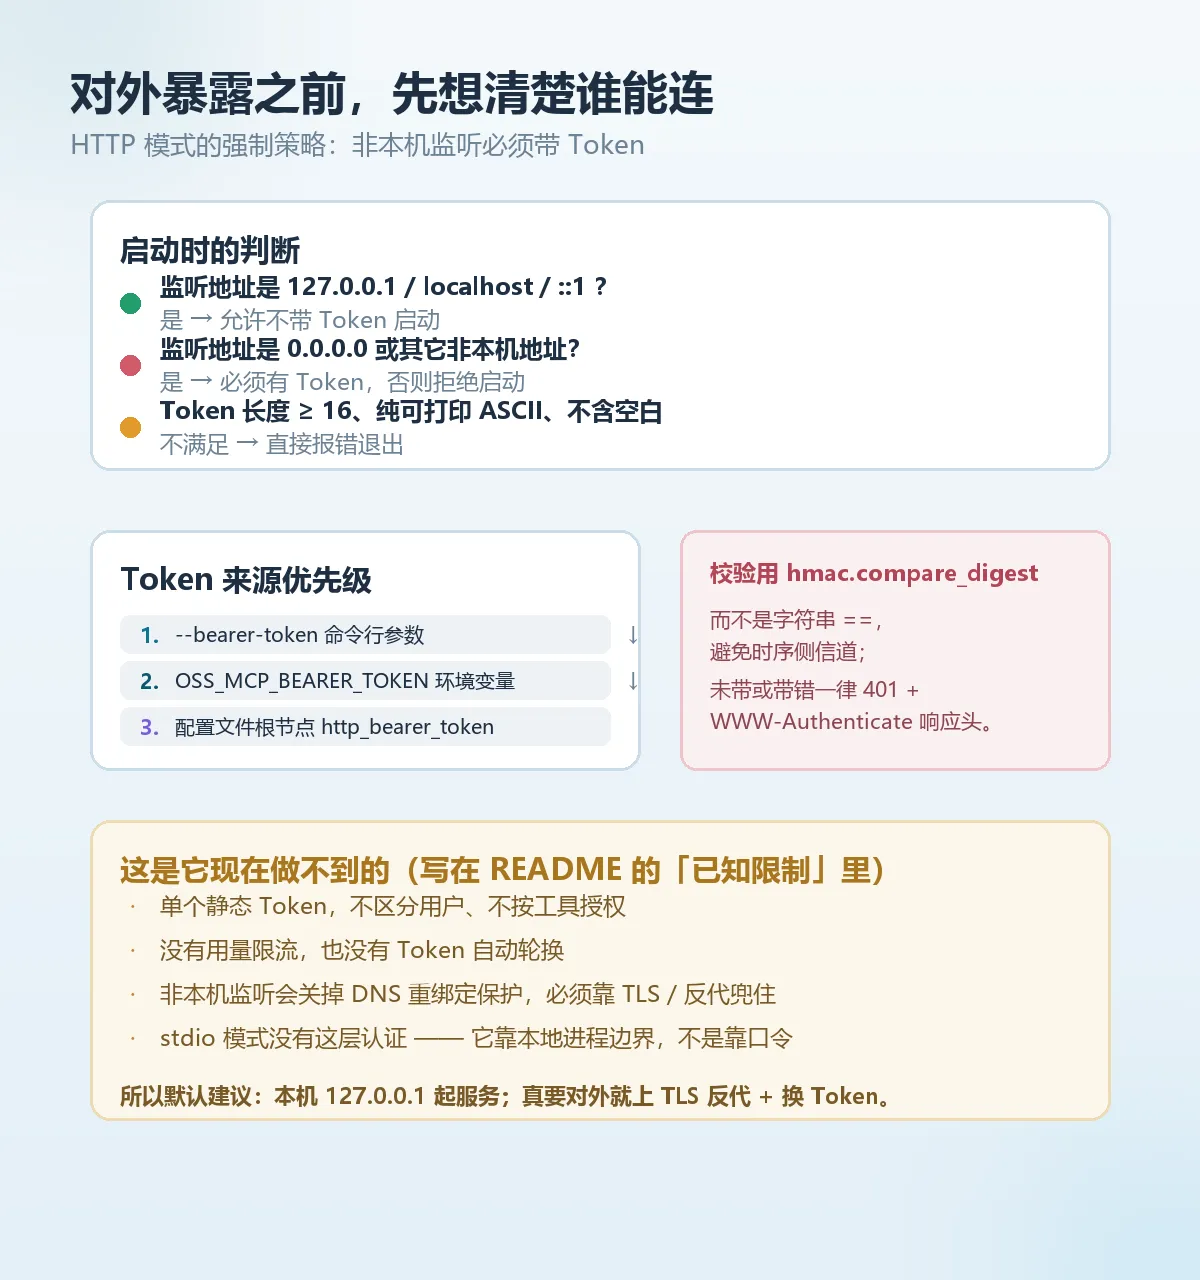
我的策略是强制,而不是「建议」:
def prepare_http_auth(host, token):
    """校验 HTTP 认证配置:本机允许无 Token,非本机必须配置 Token。"""
    if token is not None:
        if isinstance(token, str) and token.strip():
            return validate_bearer_token(token)
    if is_local_host(host):
        return None
    raise ValueError(
        f"HTTP/SSE 模式监听非本机地址 {host} 时必须配置 HTTP Bearer Token:..."
    )
监听 127.0.0.1 时不配 Token 也能起;监听 0.0.0.0 时必须配,不配直接拒绝启动。Token 还要满足:至少 16 个字符、纯可打印 ASCII、不含空白。
Token 来源有三级优先级:
--bearer-token命令行参数OSS_MCP_BEARER_TOKEN环境变量- 配置文件根节点
http_bearer_token
校验用的是 hmac.compare_digest 而不是字符串 ==,避免时序侧信道:
if (len(parts) == 2
        and parts[0].lower() == "bearer"
        and supplied
        and hmac.compare_digest(supplied.encode("utf-8"), self.token.encode("utf-8"))):
    await self.app(scope, receive, send)
    return
不通过就返回 401 并带上 WWW-Authenticate 头。
另一个细节:凭证不能漏进返回值
list_groups 是给模型看的分组清单,它会返回 AK。但 AK 本身不能明文给出去,我做了掩码:
def _mask_access_key(value):
    if not value:
        return ""
    if len(value) <= 8:
        return f"{value[:2]}***"
    return f"{value[:4]}***{value[-2:]}"
LTAI5tXXXXXXXXXXXXXX 会变成 LTAI***78。Secret 和 STS Token 完全不返回——只返回一个布尔值 uses_sts 告诉模型「这组用的是临时凭证」。
这条有专门的断言守着:
dumped = json.dumps(groups_result, ensure_ascii=False)
assert "PROD_SECRET_SHOULD_NOT_LEAK" not in dumped
assert "TEST_SECRET_SHOULD_NOT_LEAK" not in dumped
assert "sts-token-should-not-leak" not in dumped
stdio 模式的一个坑
stdio 传输下,stdout 是 MCP 协议消息的专用通道,任何一行多余的 print 都会污染协议流。所以 OSS 库函数里的所有提示信息都得能静音:
def setQuiet(quiet=True):
    """控制库函数是否输出提示信息;MCP 服务需调用 setQuiet(True) 避免污染 stdio 协议流"""
    global _quiet
    _quiet = quiet
服务启动时无条件 oss_utils.setQuiet(True),日志提示统一走 stderr。
四、11 个工具里有两个值得单独说
4.1 replace_file:替换不是简单的上传
需求是「用新文件替换 OSS 上的旧文件,访问地址不能变」。OSS 没有原生的「替换」操作,我实现成:
keep_original_name=True(默认):写回原对象路径,URL 不变keep_original_name=False:用本地文件名放到原目录,上传成功后才删旧对象
两个安全阀:
# 原对象不存在 → 拒绝
if not bucket_client.object_exists(object_name):
    raise ValueError(f"待替换的 OSS 对象不存在:{object_name},如需新建请使用上传功能")

# 改名目标已存在 → 拒绝,不动任何东西
if new_object_name != object_name and bucket_client.object_exists(new_object_name):
    raise ValueError(f"目标对象已存在,拒绝覆盖:{new_object_name}...")
而且删旧对象失败时,错误信息会明确说清新对象已经传上去了:
raise ValueError(
    f"新文件已上传到 {new_object_name},但删除旧对象 {object_name} 失败:{exc}"
)
宁可报错让人来看,也不静默留两个文件。
4.2 下载:多文件和目录自动打包
download_files 和 download_folder 都会打成 zip。两个细节:
- 多文件下载时,zip 内保留完整对象路径,避免同名文件互相覆盖
- 目录下载时,zip 内保留目录内相对路径,解压出来就是原来的结构
# 多个文件保留完整的对象路径,避免同名文件互相覆盖
self._add_object_to_zip(zip_file, object_name, object_name, bucket=bucket_client)
批量删除则是每 1000 个一批,因为阿里云单次批量删除上限就是 1000:
BATCH_DELETE_LIMIT = 1000
for start in range(0, len(keys), BATCH_DELETE_LIMIT):
    batch = keys[start:start + BATCH_DELETE_LIMIT]
    result = bucket_client.batch_delete_objects(batch)
五、188 条断言,和一套不用真账号的测试法
OSS 相关的测试最烦的是需要真账号、真 Bucket、真网络。我的做法是假 Bucket:写一个 FakeBucket 类,把 oss2 的接口模拟出来,测试跑完全不碰网络。
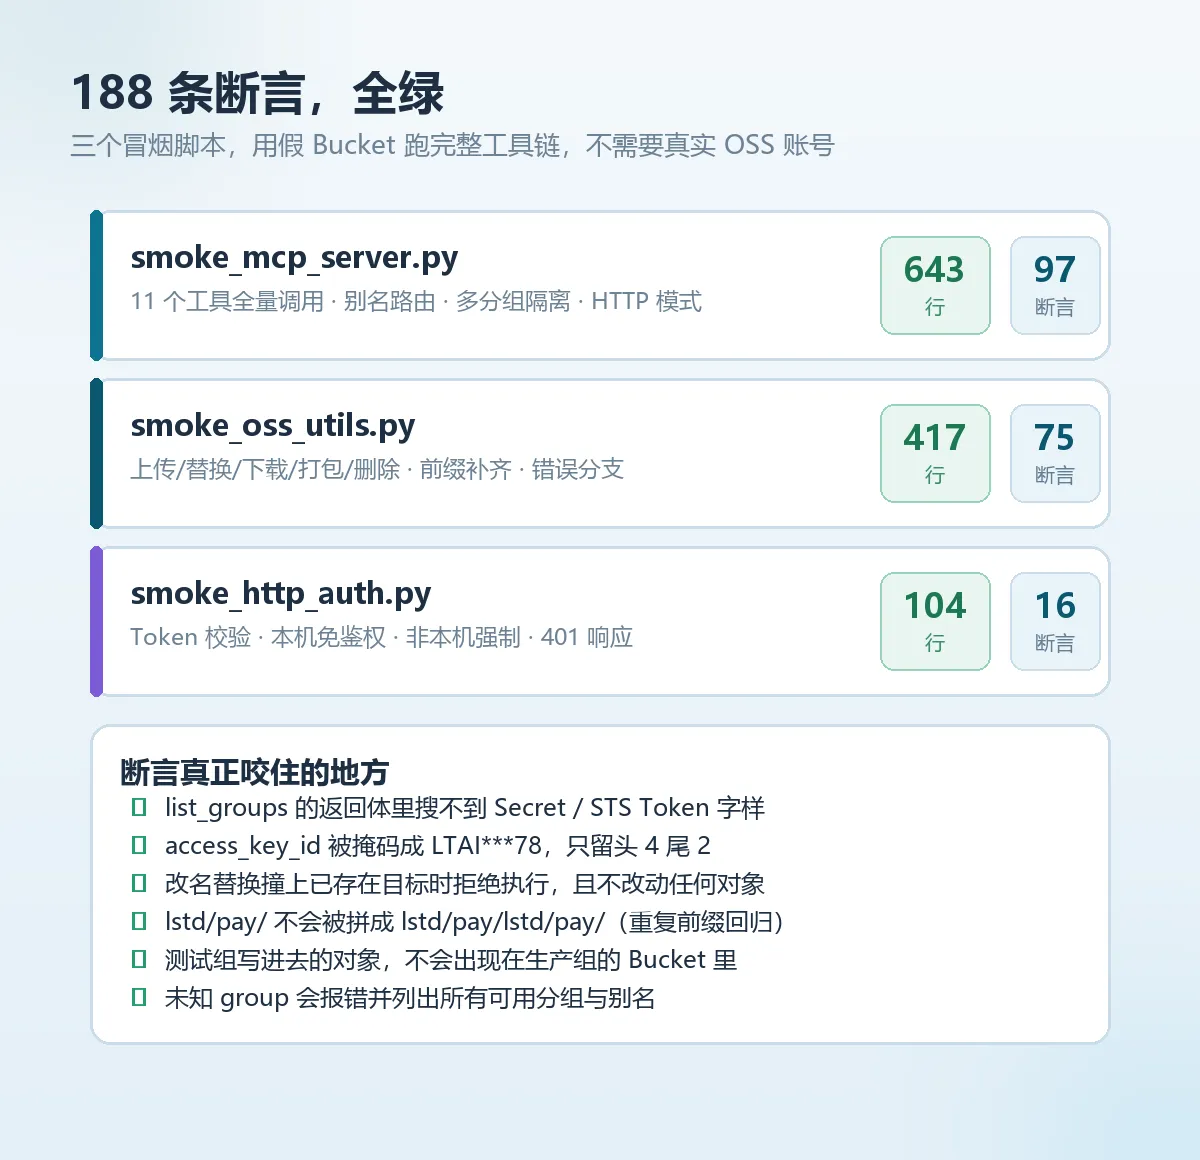
三个冒烟脚本:
| 脚本 | 行数 | 断言数 | 覆盖 |
|---|---|---|---|
smoke_mcp_server.py |
643 | 97 | 11 个工具全量调用、别名路由、多分组隔离、HTTP 模式 |
smoke_oss_utils.py |
417 | 75 | 上传/替换/下载/打包/删除、前缀补齐、错误分支 |
smoke_http_auth.py |
104 | 16 | Token 校验、本机免鉴权、非本机强制、401 响应 |
跑法:
python tests/smoke_mcp_server.py
# -> ALL MULTI-GROUP MCP TESTS PASSED
这些断言咬住的地方,有几条是我写的时候真踩过的:
- 分组隔离:测试组写进去的对象,不能出现在生产组的 Bucket 里
- 重复前缀回归:
lstd/pay/不能被拼成lstd/pay/lstd/pay/ - 改名撞车:替换目标已存在时拒绝执行,且不改动任何对象
- 未知 group:报错信息里要列出所有可用分组和别名,让模型能自我纠正
result = await call("download_files", {

    "object_names": ["prefix/up.txt", "lstd/pay/prefix/up2.txt", "prefix/up.txt"],
    "local_dir": tmp, "zip_name": "prefix-multi.zip", "group": "prod",
})
assert result["file_count"] == 2, result
注意这行断言:file_count 是 2 不是 3。因为 prefix/up.txt 归一化后是 lstd/pay/prefix/up.txt,和第三个元素其实是同一个文件——去重发生在归一化之后,不是之前。这个顺序我一开始写反了,测试直接把它揪出来。
六、它现在做不到什么
这部分我放在正文而不是文末附录,因为用的人需要先知道边界。
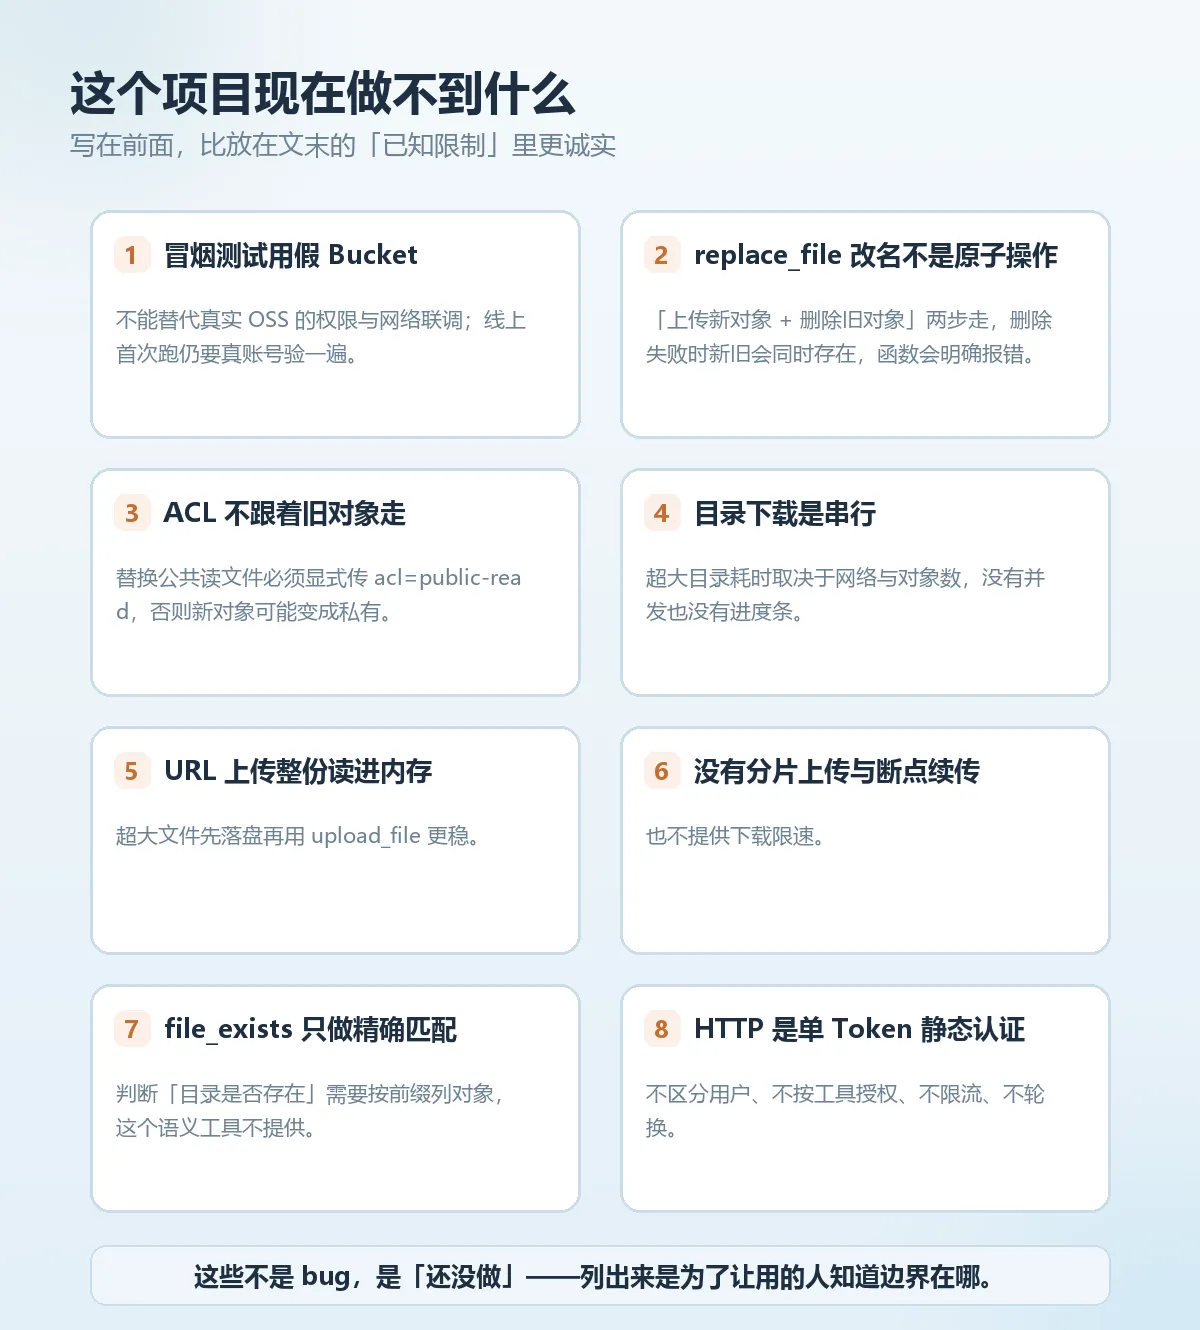
具体来说:
- 测试用假 Bucket,不能替代真实 OSS 的权限与网络联调。线上首次跑仍要拿真账号验一遍。
replace_file改名不是原子操作,是「上传新对象 + 删除旧对象」两步走,删除失败时新旧会同时存在(但会明确报错)。- 替换不继承旧对象的 ACL。不显式传
acl=public-read的话,新对象可能变成私有——这是我在实际用的时候踩到的。 - 目录下载是串行,超大目录耗时取决于网络和对象数,没有并发也没有进度条。
- URL 上传整份读进内存,超大文件先落盘再用
upload_file更稳。 - 没有分片上传、断点续传、下载限速。
file_exists只做精确匹配,判断「目录是否存在」需要按前缀列对象,这个语义工具不提供。- HTTP 是单 Token 静态认证,不区分用户、不按工具授权、不限流、不轮换。非本机监听会关掉 DNS 重绑定保护,必须靠 TLS / 反向代理兜住。
七、怎么用起来
7.1 装
uvx oss-mcp-server
或者从源码:
git clone https://github.com/xiaobinger/oss_mcp_server
cd oss_mcp_server
pip install -e .
7.2 配
cp config/oss_config.example.json config/oss_config.json
# 编辑 config/oss_config.json,填 access_key_id / access_key_secret / endpoint / bucket
7.3 接客户端
stdio 模式(本地客户端拉起,最常用):
{

  "mcpServers": {

    "oss": {

      "command": "uvx",
      "args": ["oss-mcp-server"],
      "env": {

        "OSS_ACCESS_KEY_ID": "LTAI...",
        "OSS_ACCESS_KEY_SECRET": "...",
        "OSS_ENDPOINT": "oss-cn-hangzhou.aliyuncs.com",
        "OSS_BUCKET": "your-bucket"
      }
    }
  }
}
HTTP 模式(多客户端共享,走网络):
python src/oss_mcp_server.py --config ./config/oss_config.json \
    --transport streamable-http --host 127.0.0.1 --port 8000
# -> OSS MCP 服务已启动:http://127.0.0.1:8000/mcp(transport=streamable-http)
对外监听时补上 Token:
export OSS_MCP_BEARER_TOKEN="your-token-at-least-16-chars"
python src/oss_mcp_server.py --config ./config/oss_config.json \
    --transport streamable-http --host 0.0.0.0 --port 8000
7.4 服务管理脚本
Windows / Linux / macOS 各有一套:
./scripts/mcp_service.sh start|stop|restart|status|logs
.\scripts\mcp_service.ps1 start|stop|restart|status|logs
脚本会自己准备环境:虚拟环境不存在就创建,缺依赖就升级 pip 再装 requirements.txt。它还会检查端口占用、记录 PID 到 run/mcp.pid、日志写到 logs/。不想让它动环境的话,设 OSS_MCP_AUTO_INSTALL=0。
7.5 命令行工具
同一套底层能力也能脱离 MCP 单独用:
# 上传本地文件并设为公共读
python src/oss_utils.py --access-key-id AK --access-key-secret SK \
    --endpoint oss-cn-hangzhou.aliyuncs.com --bucket demo \
    upload --file ./a.png --key a.png --acl public-read

# 替换已有文件,保留原对象路径(URL 不变)
python src/oss_utils.py ... replace --file ./new.png --key a.png

# 替换并按本地文件名改名,成功后删除旧对象
python src/oss_utils.py ... replace --file ./new.png --key a.png --use-local-name

# 下载整个目录(自动打包,ZIP 内保留相对路径)
python src/oss_utils.py ... download --prefix 2026/ -d ./downloads
八、写在最后
这个项目一共 13 次提交,1452 行源码,188 条断言。核心功能其实不复杂——上传就是 put_object,下载就是 get_object_to_file。
真正花时间的是那些「看起来是小问题」的地方:
- 模型的自然语言里「测试 OSS」怎么对应到
test分组 - 路径前缀补齐的顺序(先归一化再去重,反了就出错)
- stdio 模式下 print 会污染协议流
- 替换时 ACL 不跟着旧对象走
这些都不是难算法,但每一个都能让工具在生产环境里出静默的错误。所以我做了两件事:把判断收敛到少数几个函数里(normalizeObjectName、_resolve_group、_mask_access_key),给每个坑配一条断言。
项目已发到 PyPI(oss-mcp-server)和 Official MCP Registry,仓库在 github.com/xiaobinger/oss_mcp_server。
如果你也在给模型接对象存储,最容易踩的坑应该是「模型不知道该传全路径还是相对路径」和「多 Bucket 时选错组」。这两个我踩过了,代码是现成的。
