
大家多半都写过这么一行 Java,然后愣了一下:
System.out.println(0.1 + 0.2);         // 0.30000000000000004
System.out.println(0.1 + 0.2 == 0.3);  // false
类似的事情还有不少:
- 商品价格
19.99乘以 100 换算成「分」,(int) (19.99 * 100)得到的是1998,少了一分钱; - 后端返回的订单 id 是
Long类型的9007199254740993,到了前端,JSON.parse一下变成了9007199254740992; - 写个
for循环,把0.1累加 10 次,结果是0.9999999999999999,而不是1.0。
这些问题不是 Java 独有的,换成 C、Go、JavaScript、Python,算出来都一样,因为它们用的是同一套标准:IEEE 754 浮点数。这篇文章就顺着三个问题把它讲清楚:浮点数是什么(what)?0.1 + 0.2 到底是怎么算出 0.30000000000000004 的(how)?既然它有这么多坑,为什么几乎所有语言、所有 CPU 还都用它(why)?
浮点数是什么:二进制的科学计数法
大家中学都学过科学计数法:阿伏伽德罗常数写成 6.02 × 10^23,一个电子的质量写成 9.11 × 10^-31 kg。前面的 6.02 叫有效数字,后面的 23 叫指数,指数决定小数点往哪边挪、挪几位。小数点的位置不固定,可以「浮动」,这就是浮点数名字的由来。
计算机里的浮点数,就是把这套写法搬到二进制上。Java 的 double 占 64 位,被切成三段:
- 符号,1 bit:0 是正,1 是负;
- 指数,11 bit:决定 2 的几次方;
- 尾数,52 bit:有效数字的小数点后面那部分。
拿 0.1 举例,用 Long.toHexString(Double.doubleToLongBits(0.1)) 就能看到它在内存里的 64 个 bit:3FB999999999999A。拆开来是这样:
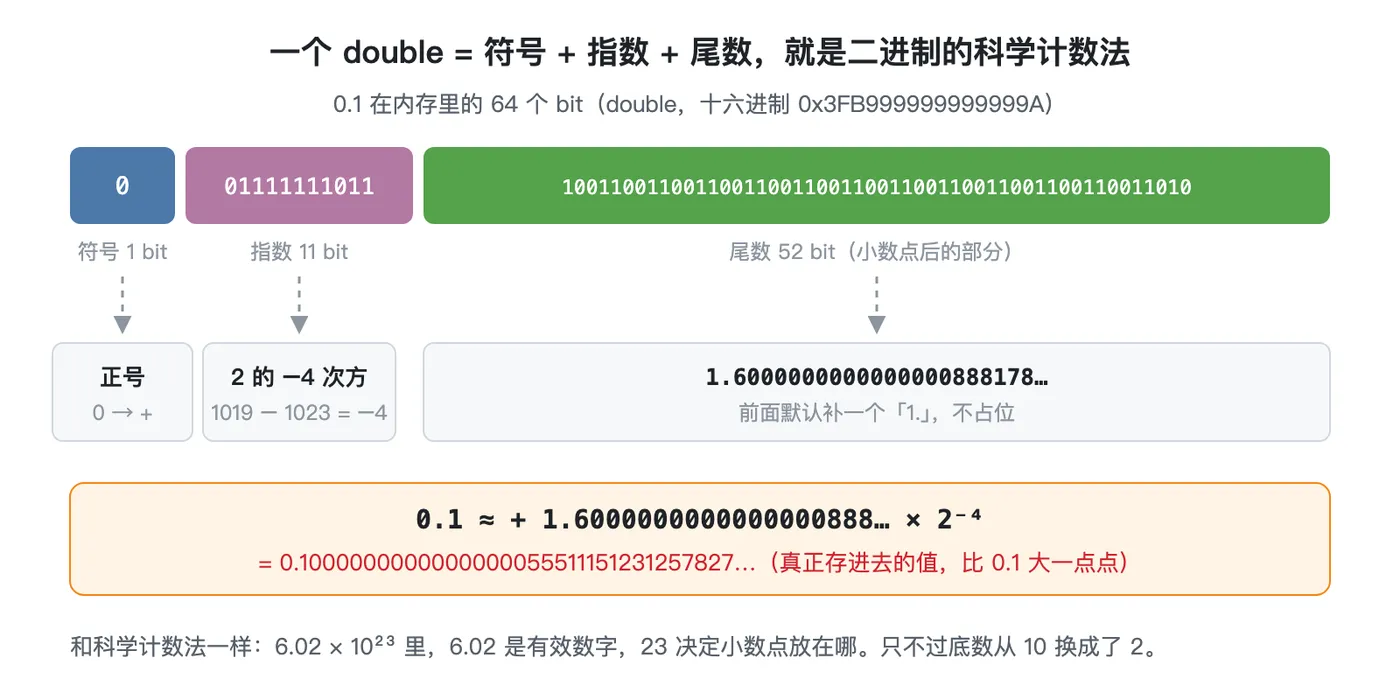
翻译回来就是 + 1.6000000000000000888… × 2^-4。想看它精确等于多少,Java 里有个现成的办法:new BigDecimal(double) 会把 double 的真实值一位不差地展开。
System.out.println(new BigDecimal(0.1));
// 0.1000000000000000055511151231257827021181583404541015625
内存里存的根本不是 0.1,而是一个比 0.1 大了大约 5.55 × 10^-18 的数。System.out.println(0.1) 之所以显示 0.1,是因为 Double.toString 会挑「能唯一还原回这个 double 的最短十进制写法」,看起来一切正常。
float 是同样的结构,只是缩成 32 位(1 + 8 + 23),误差更大:new BigDecimal(0.1f) 是 0.100000001490116119384765625,所以 0.1f == 0.1 是 false。两个看起来都是 0.1 的数,其实是两个不同的近似值。
这个格式里有两处设计,第一眼看上去有点怪。
为什么尾数前面的「1.」不用存? 十进制的科学计数法要求有效数字的第一位是 1~9;换到二进制,第一位只能是 1,因为只有 0 和 1 两个数字,而 0 开头就不算规范写法了。既然第一位永远是 1,那就干脆不存,白赚一位。所以 52 bit 的尾数实际有 53 位精度,后面讲到的 2^53 就是从这里来的。
为什么指数要减 1023? 指数可正可负,0.1 的指数是 −4。IEEE 754 没有给指数单独配符号位,而是统一加上一个偏移量 1023 再存,所以存进去的是 1019,读出来再减掉。这样做的好处是:同号的两个 double,直接把 64 个 bit 当整数比大小,结果和比浮点数大小一样。用 Double.doubleToLongBits 看一下:
| double | Double.doubleToLongBits(x) |
|---|---|
| 0.1 | 4591870180066957722 |
| 0.2 | 4596373779694328218 |
| 0.3 | 4599075939470750515 |
| 1.0 | 4607182418800017408 |
| 2.0 | 4611686018427387904 |
数越大,long 也越大,顺序完全一致。硬件比较浮点数时就可以复用整数比较的电路,排序算法也能直接用这个性质。
0.1 + 0.2 为什么不等于 0.3
问题的根子在第一步:0.1 根本存不准。
大家都知道 1/3 在十进制里写不完:0.3333…,写多少位都只是近似。原因是 3 不是 10 的因子,10 只能被 2 和 5 整除,所以分母里带别的质因子的分数,用十进制写都会无限循环。
二进制也一样,只不过它的「底」是 2,只能整除 2。0.1 = 1/10,分母 10 = 2 × 5,里面那个 5 二进制消化不掉。把十进制小数转二进制的办法是「乘 2 取整数位」,大家可以手算一下:
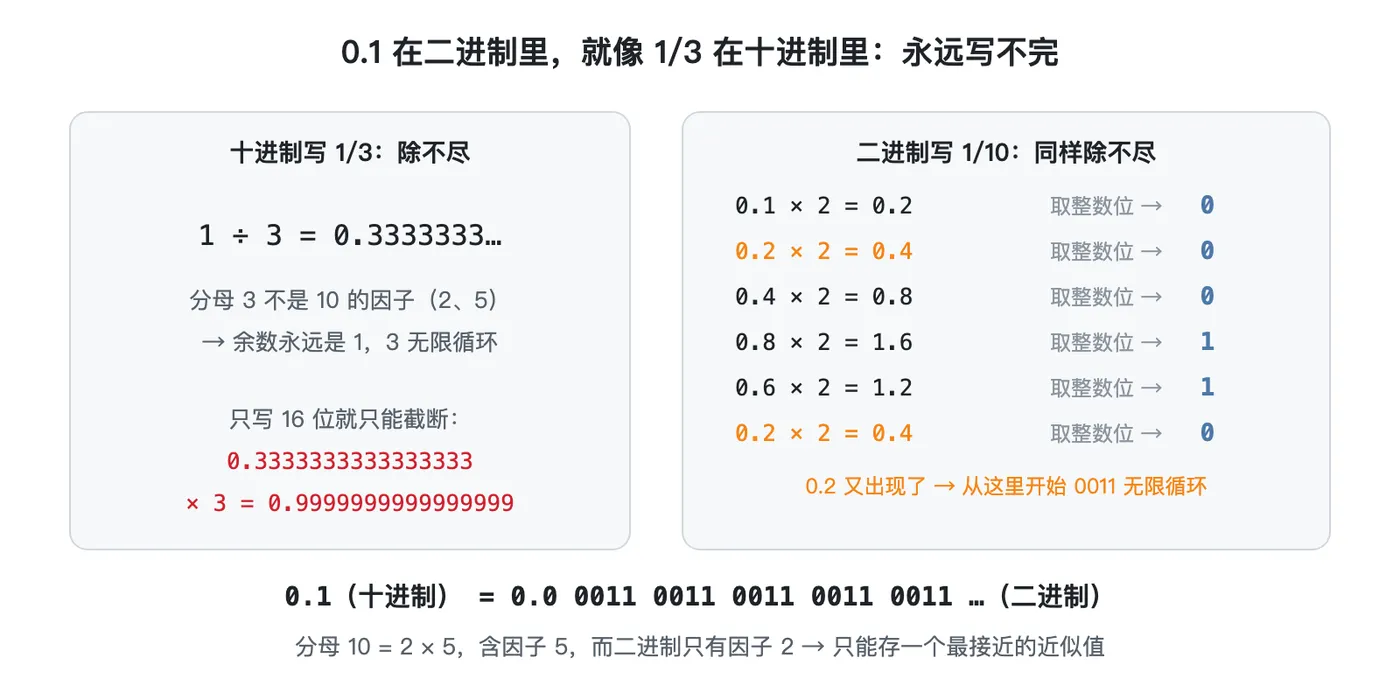
算到第 6 步,0.2 又出现了,后面就是 0011 无限循环。尾数只有 52 位,只能在某处截住、舍入,0.1 就这样变成了 0.1000000000000000055…。0.2 也一样,变成了 0.2000000000000000111…。两个本来就有误差的数相加,结果自然也带误差。
但光说「有误差」还不够,大家可能会问:0.3 本身也存不准,为什么误差没有「刚好对上」?这里要看一下数轴。
double 不是连续的,它是数轴上一个一个离散的点。Math.ulp(0.3) 返回 5.551115123125783E-17,意思是在 0.3 附近,相邻两个 double 之间就隔这么远。任何计算结果都必须落到其中某一个点上:
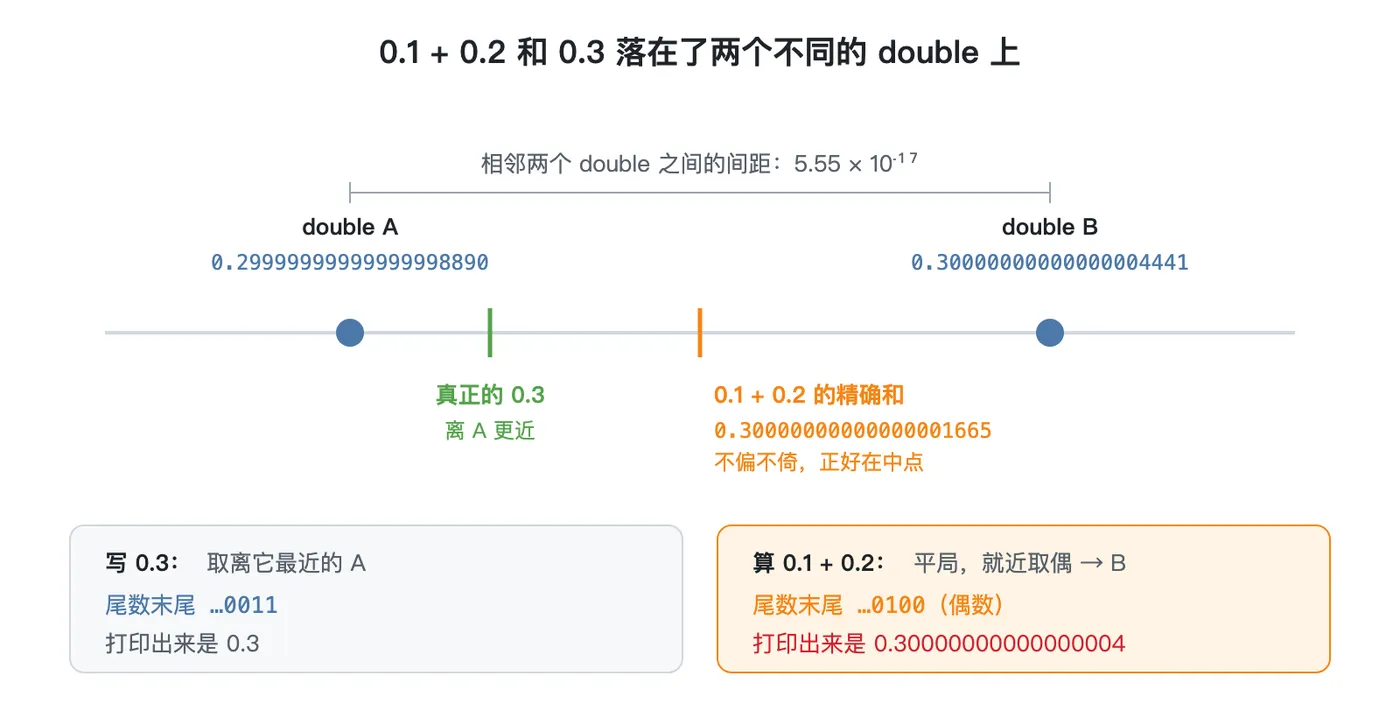
- 代码里写
0.3:真正的 0.3 离左边的 A 更近,于是存成 A,new BigDecimal(0.3)是0.29999999999999998889…; - 计算
0.1 + 0.2:把两个存进去的近似值精确相加,得到0.30000000000000001665…。巧的是,它正好落在 A 和 B 的正中间,离两边的距离都是2.78 × 10^-17,一分不差。
「正好落在正中间」就是所谓的平局(tie)。浮点运算的默认规则是就近:结果落在两个点之间,就选离得近的那个,就像把 2.3 取整成 2、把 2.7 取整成 3。可如果结果是 2.5,到 2 和到 3 一样远,「就近」就选不出来了,这就是平局。
0.1 + 0.2 就是二进制里的「2.5」。把尾数的最后几位排在一起看:
A         …0011
B         …0100
精确的和  …0011 1    ← 比 double 多出一位,而且这一位刚好是 1
精确的和需要 54 位尾数,double 只放得下 53 位,多出来的那一位要舍掉。二进制里,被舍掉的部分「恰好是 1,后面全是 0」,就相当于十进制里「恰好是 5,后面全是 0」,也就是正好一半。所以它离 A 和 B 一样远。
平局了怎么办?IEEE 754 的规定是就近取偶(round half to even):选尾数最后一位是 0 的那个。A 的尾数末尾是 …0011,B 是 …0100,于是选了 B。new BigDecimal(0.1 + 0.2) 是 0.30000000000000004440…,打印出来就是 0.30000000000000004。一边是 A,一边是 B,== 自然返回 false。
为什么平局要取偶,而不是像小学那样「四舍五入」? 因为「逢 5 就进」在大量计算里会让误差一直往同一个方向偏。Java 里正好两种都有:Math.round 是逢 5 就进(Javadoc 的说法是平局时朝正无穷方向取整),Math.rint 是就近取偶。拿四个刚好在中间的数试一下,0.5, 1.5, 2.5, 3.5,真实的和是 8:
| 原数 | Math.round(逢 5 就进) | 误差 | Math.rint(就近取偶) | 误差 |
|---|---|---|---|---|
| 0.5 | 1 | +0.5 | 0.0 | −0.5 |
| 1.5 | 2 | +0.5 | 2.0 | +0.5 |
| 2.5 | 3 | +0.5 | 2.0 | −0.5 |
| 3.5 | 4 | +0.5 | 4.0 | +0.5 |
| 求和 | 10 | +2 | 8.0 | 0 |
逢 5 就进,每个平局都多算 0.5,四次全往上偏,加起来多了 2;取偶是一上一下,加起来刚好抵消。数据一多,取偶的误差也就能互相抵消。这也是为什么 BigDecimal 专门提供了 RoundingMode.HALF_EVEN,金融行业管它叫「银行家舍入」:new BigDecimal("2.5").setScale(0, RoundingMode.HALF_EVEN) 得 2,换成 HALF_UP 得 3。
反过来,如果每次都往同一个方向舍,哪怕每次只差一点点,次数一多也会滚成大错。最出名的例子是 1991 年海湾战争中的爱国者导弹事故。
爱国者系统里有一个计数器,每过 0.1 秒加 1。要知道过去了多少秒,就拿计数器的值乘以 0.1:计到 10 是 1 秒,计到 36,000 是 1 小时。问题出在这个 0.1 上。按美国 GAO 的调查报告,系统用 24 位二进制存它。前面说过,0.1 在二进制里是 0.000110011… 无限循环,只能在第 24 位截住,后面的直接丢掉。这不是舍入,是截断,永远往小了取。存进去的是 0.09999990463…,比 0.1 少了约 9.54 × 10^-8。
单看一次,这点误差完全可以忽略。但它是乘在计数器上的:开机越久,计数器越大,算出来的时间偏得越多,而且永远偏小。飞毛腿导弹的速度大约 1676 m/s,换算成距离是这样:
| 连续运行 | 计数器的值 | 时间少算了 | 飞毛腿这段时间飞过 |
|---|---|---|---|
| 1 小时 | 36,000 | 0.0034 秒 | 约 6 米 |
| 8 小时 | 288,000 | 0.0275 秒 | 约 46 米 |
| 100 小时 | 3,600,000 | 0.3433 秒 | 约 575 米 |
事发那天,系统已经连续开机约 100 小时。雷达发现来袭的飞毛腿后,系统要根据「当前时间」预测它下一刻会出现在哪里,再把雷达对准那里确认。可「当前时间」慢了 0.34 秒,预测的位置就差了 500 多米,雷达在那里什么也没看到,判定为误报,没有拦截。导弹击中了达兰的美军营房,28 名士兵遇难。
这里用的不是浮点而是定点数(后面「为什么要设计成这样」会讲到),但病根一样:0.1 在二进制里存不准。截断又让误差每次都往同一边偏,越积越大。
精度是相对的:数越大,缝越宽
刚才说 0.3 附近相邻 double 的间距是 5.55 × 10^-17。这个间距在别处也一样吗?不一样,而这正是浮点数最核心的特征。
尾数的位数是固定的 53 位,所以每个 [2^n, 2^(n+1)) 区间里 double 的个数一样多,都是 2^52 个。可区间每往右一段,长度就翻一倍,同样多的点摊在两倍长的区间上,间距也就翻倍。大家可以用 Math.ulp(x) 自己验证:
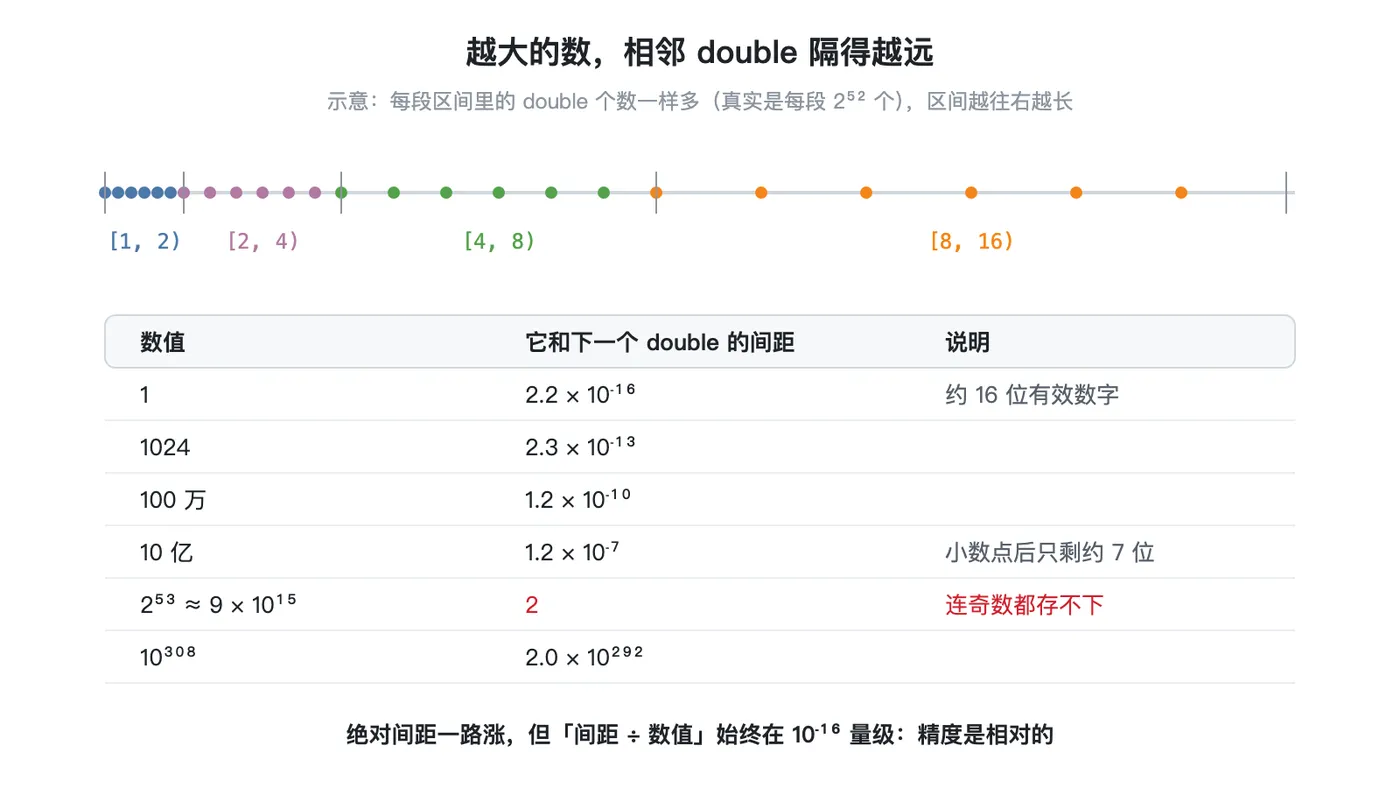
绝对间距从 10^-16 一路涨到 10^292,但如果拿间距除以数值本身,结果始终在 10^-16 这个量级。也就是说,double 保证的是相对精度:大约 15~16 位有效数字,至于这 16 位落在小数点前面还是后面,它不管。
大家在业务里撞上的好几个怪现象,都是这句话的推论:
- 大整数存不准。 到了
2^53 = 9007199254740992,Math.ulp变成了2.0,奇数直接没有位置可放。(long) (double) 9007199254740993L得到的是9007199254740992。Java 的long有 64 位,自己不会出问题,但前端 JavaScript 只有 double 一种数字类型,后端的Long一到前端就会被悄悄改掉。真实案例是 Twitter:2010 年推文 id 换成 Snowflake 算法之后很快超过了 2^53,JavaScript 客户端解析出来的 id 对不上,Twitter 只好在 API 里给每个 id 再加一个字符串版本的id_str。国内项目用雪花算法生成主键,踩的是同一个坑。 - 大数加小数,小数被「吃掉」。
1e16 + 1 == 1e16是true。在1e16附近,间距已经是 2,加 1 不够跨到下一个点,舍入回原地。累加时先加大数、后加小数,小数就可能一个都加不进去。 - float 更早露馅。
float只有 24 位精度,16777217f == 16777216f是true,(int) 16777217f得16777216。拿float存金额、计数,两千万不到就开始出错。
为什么要设计成这样
看完上面这些坑,大家自然会问:既然这么多问题,为什么不换一种表示法?要回答这个问题,先得想清楚我们真正想要什么。
我们想要的是:用固定大小的一块内存(最好 8 字节),表示范围极大的实数,小到原子的 10^-10 米,大到宇宙的 10^26 米,并且加减乘除都能由硬件一条指令完成。顺便,最好 0.1 也能存准。
能想到的办法挨个过一遍:
办法一:定点数。 约定小数点固定在某个位置,比如用
long存「分」,19.99元存成1999。整数运算又快又准,金额也存得准。可小数点钉死了,范围就锁住了:精确到 0.01,就表示不了0.001;改成精确到10^-9,最大值就只剩92 亿左右(Long.MAX_VALUE / 10^9 ≈ 9.2 × 10^9)。想同时表示原子大小和宇宙大小,定点数做不到。爱国者导弹用的就是定点数,它一样存不准 0.1。办法二:分数。 存一个分子、一个分母,
1/10和1/3都能精确表示。问题是分母会越算越长:只是把1 + 1/2 + 1/3 + … + 1/100加起来,结果的分母就有 40 位数字。大小不固定,运算也没有硬件支持,而且√2、π照样表示不了。办法三:十进制任意精度,也就是
BigDecimal。 思路很直接:既然二进制存不准十进制小数,那就用十进制存。BigDecimal内部是两部分:一个任意长的整数,加一个「小数点往左挪几位」的 scale。0.1存成整数1、scale1,意思是1 × 10^-1;19.99存成整数1999、scale2。整数部分不够长会自动加长,所以多少位都存得下,new BigDecimal("0.1").add(new BigDecimal("0.2"))精确等于0.3。但它并没有消灭「存不准」,只是换了一批存不准的数。前面讲过,一个分数能不能写完,看分母的质因子:二进制只能消化 2,十进制能消化 2 和 5。
| 分数 | 二进制(double) | 十进制(BigDecimal) |
| --- | --- | --- |
| 1/8 = 0.125 | 存得准 | 存得准 |
| 1/10 = 0.1 | 存不准 | 存得准 |
| 1/3 | 存不准 | 存不准 |
| 1/7 | 存不准 | 存不准 |十进制只比二进制多赢了「分母带 5」这一类,正好覆盖了人写出来的金额、税率,可分母带 3、7 的照样没办法。
BigDecimal遇到这种情况宁可报错,也不偷偷舍入:BigDecimal.ONE.divide(new BigDecimal(3))会直接抛出ArithmeticException: Non-terminating decimal expansion。想算下去,就得告诉它保留几位,比如MathContext.DECIMAL64,也就是 16 位有效数字:BigDecimal third = BigDecimal.ONE.divide(new BigDecimal(3), MathContext.DECIMAL64); // 0.3333333333333333 third.multiply(new BigDecimal(3)); // 0.9999999999999999一旦限定了位数,它就和
double一样要舍入、一样有误差,只是误差出现在另一批数上。另一个代价是速度和内存。
double固定 8 字节,可以直接放在 CPU 寄存器里,一条指令算完。办法四:二进制浮点,也就是
double。 和定点数一样是 8 字节,区别在于这 64 位怎么分。定点数把 64 位全拿来存数字,小数点的位置写死在约定里;浮点数拿出 11 位专门记「小数点在哪」,剩下的位存数字。代价是数字只剩 53 位,大约 16 位有效数字;换来的是小数点能从2^-1022一路挪到2^1023。格式固定,CPU 就能为它造专门的电路,x86 的addsd、ARM 的fadd一条指令就做完一次 double 加法。
同样是 8 字节,把定点数(long 精确到 10^-9)和 double 放在一起比一下:
| long 定点(精确到 10^-9) | double | |
|---|---|---|
| 最大值 | 约 9.2 × 10^9 | 约 1.8 × 10^308 |
| 最小正数 | 10^-9 | 约 2.2 × 10^-308(Double.MIN_NORMAL) |
| 原子大小 10^-10 米 | 存不下,变成 0 | 能存,附近间距约 1.3 × 10^-26 |
| 1 附近的间距 | 10^-9 | 约 2.2 × 10^-16 |
| 宇宙大小 10^26 米 | 溢出 | 能存,附近间距约 1.7 × 10^10 |
定点数的间距处处都是 10^-9,平均但很窄;double 的间距在原子附近比原子还小 16 个数量级,在宇宙尺度上是 170 亿米,看着很大,可和 10^26 比起来,依然只差第 16 位。
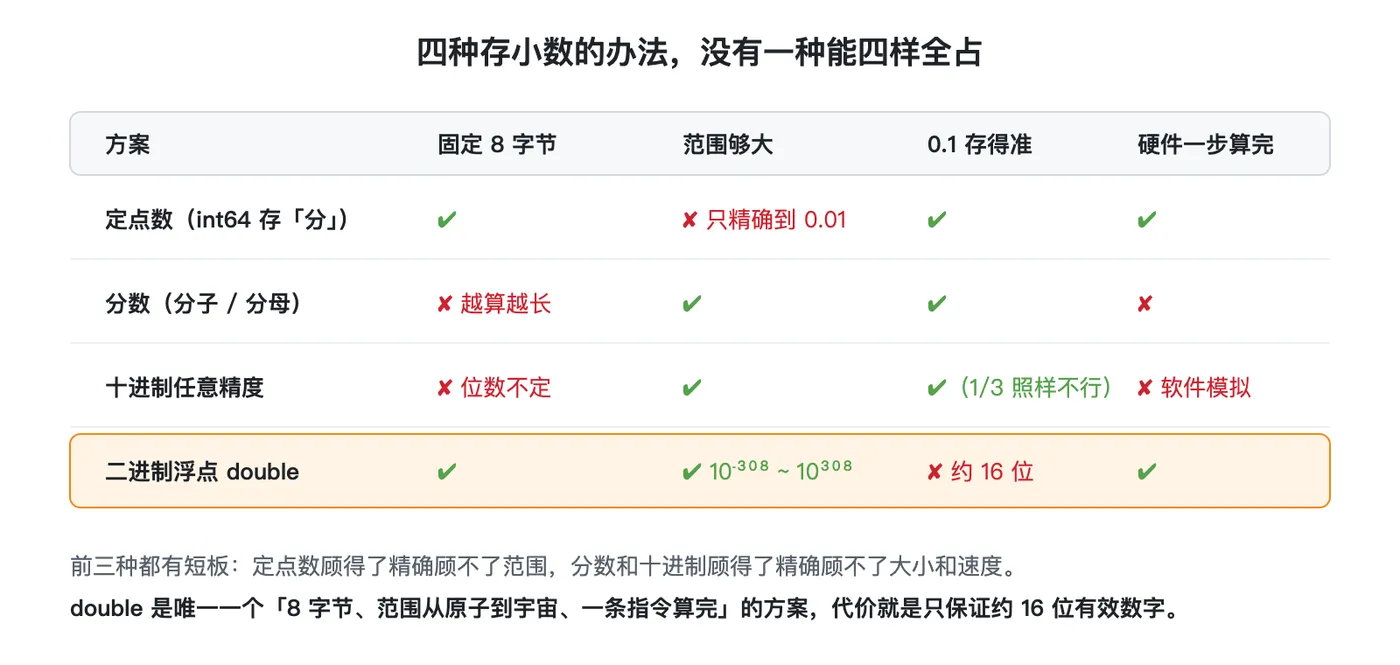
四个办法摆在一起就清楚了:「范围大」和「固定大小」本来是冲突的。8 字节只有 2^64 种组合,大约 1.8 × 10^19 个点。要覆盖 10^-308 到 10^308 这么宽的范围,如果像定点数那样均匀地铺,相邻两个点之间要隔 10^289 左右,别说 0.1,连 1 到 10 亿之间都一个点也没有。所以不可能处处都铺得一样密。浮点数的选择是:让点的密度跟着数值大小走。靠近 0 的地方铺得极密,越往外越稀,但每个位置的相对误差都一样小。
所以浮点数的精髓可以压成一句话:用固定的位数,换一把随数值缩放的尺子。测原子用纳米刻度,测星系用光年刻度,每次都量出大约 16 位有效数字。这和科学计算的需求刚好吻合:物理量本来就带测量误差,没有人关心一个星系的直径在第 17 位上是 3 还是 4。
想通这一点,前面那些「坑」就都是推论了:
0.1存不准,是因为选了二进制,硬件做二进制运算最简单最快,代价是十进制小数大多是近似值;0.1 + 0.2 != 0.3,是因为每一步运算后都要舍入到最近的点,误差随时会冒出来;- 大整数会丢,是因为尺子缩放到那里,刻度已经宽于 1。
为什么不干脆用十进制浮点? IEEE 754 在 2008 年确实加了十进制浮点格式(decimal64 等),IBM 的 POWER 处理器也有硬件支持。但主流的 x86 和 ARM CPU 都没有这类硬件单元,而且 1/3 照样存不准。对科学计算、图形、机器学习来说,十进制没有带来任何好处,只是变慢。只有「人类用十进制记账」这件事需要它,而这件事交给 long 或 BigDecimal 就能解决。
写代码时怎么跟它相处
明白了浮点数是「一把精度相对的尺子」,处理它的思路就只有两条:要么承认误差,要么换一个能精确表示的类型。落到 Java 业务里,最常见的是这四种场景:
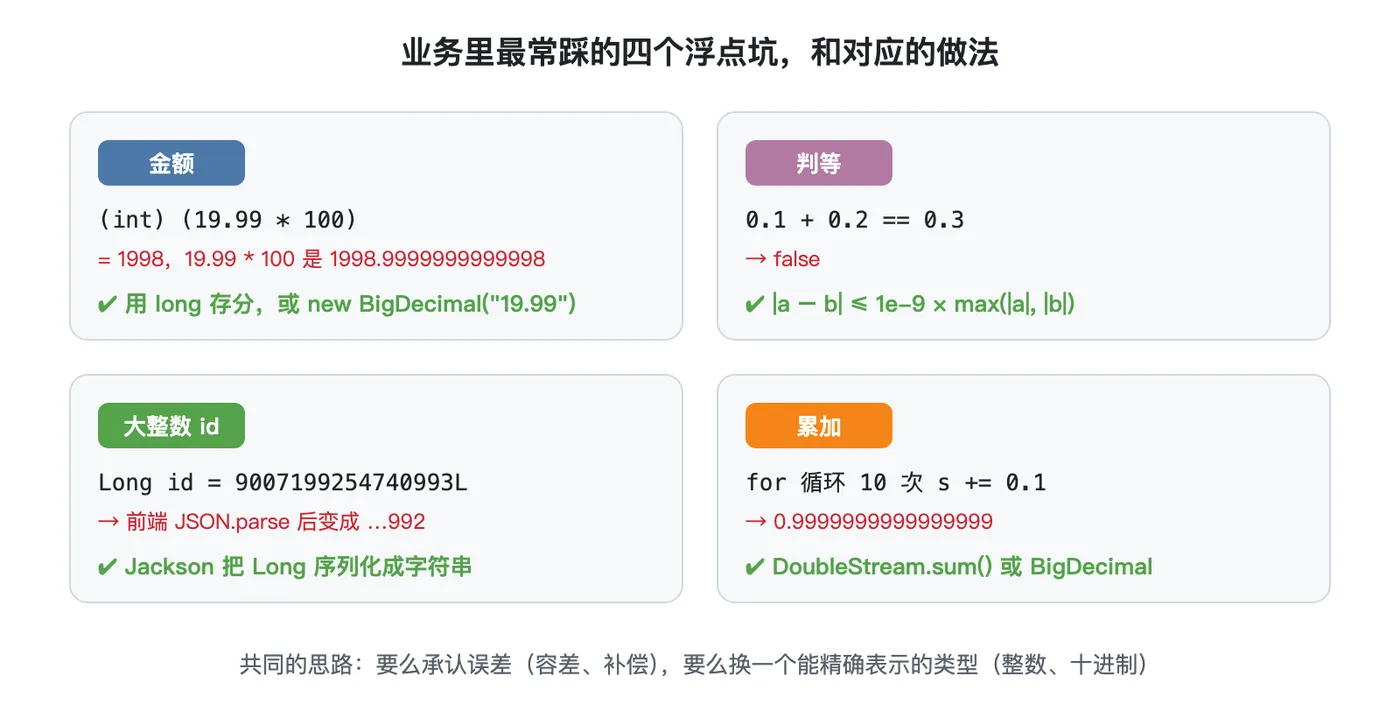
金额:别用 double,用
long存分或用BigDecimal。19.99 * 100等于1998.9999999999998,强转int就丢了一分钱。数据库用DECIMAL(p, s),代码里用long存分,或者用BigDecimal。BigDecimal的构造方式也有讲究:new BigDecimal(19.99) // 19.989999999999998436805981327779591083526611328125 BigDecimal.valueOf(19.99) // 19.99,走的是 Double.toString new BigDecimal("19.99") // 19.99,最稳妥第一种会把那个 double 的真实值原样搬过来,等于把误差也一起请了进来。另外,比较两个
BigDecimal要用compareTo,不要用equals:new BigDecimal("2.0").equals(new BigDecimal("2.00"))是false,因为equals连小数位数(scale)也一起比。判等:比误差,而且比相对误差。 不要写
a == b,要写|a − b| ≤ 容差。容差应该跟着数值大小变,原因就是上一节说的精度是相对的:在1e16附近,相邻两个 double 就差 2,固定的1e-9毫无意义。static boolean nearlyEqual(double a, double b) { return Math.abs(a - b) <= 1e-9 * Math.max(Math.abs(a), Math.abs(b)); }这个写法和 0 比较时会失效:
nearlyEqual(1e-20, 0)是false,因为 0 乘任何比例都是 0。和 0 比时要额外给一个绝对容差。大整数 id:超过 2^53 就当字符串传给前端。 雪花算法生成的 id 很容易超过
9007199254740991。在 Spring Boot 里,可以给字段加@JsonSerialize(using = ToStringSerializer.class),或者给 Jackson 全局注册一个把Long序列化成字符串的模块。Twitter 的id_str就是这个思路。累加:注意顺序,或者用补偿求和。 浮点加法不满足结合律:
(0.1 + 0.2) + 0.3得0.6000000000000001,0.1 + (0.2 + 0.3)得0.6。累加大量数据时,误差会一步步积起来,for循环加 10 次0.1得到0.9999999999999999。换成DoubleStream.sum()就好了:DoubleStream.generate(() -> 0.1).limit(10).sum()得1.0,因为 JDK 的实现用的是 Kahan 补偿求和,会把每一步舍掉的零头记下来补回去。
还有两个冷门但会出事的坑,都和 == 与 equals 不一致有关:
NaN不等于自己。0.0 / 0.0得到NaN,Double.NaN == Double.NaN是false,判断要用Double.isNaN()。但Double.valueOf(Double.NaN).equals(Double.NaN)却是true,否则NaN放进HashMap就再也取不出来了。0.0和-0.0。0.0 == -0.0是true,但Double.valueOf(0.0).equals(-0.0)是false,它们在HashMap里是两个不同的 key。浮点数有符号位,所以 0 也有正负两个。
最后回到开头的三个问题。浮点数是什么:二进制的科学计数法,64 位切成符号、指数、尾数三段,有效数字固定,小数点浮动。0.1 + 0.2 怎么变成了 0.30000000000000004:0.1 和 0.2 在二进制里都写不完,只能存近似值,两个近似值的和正好落在两个 double 的中点,按就近取偶舍入到了 0.3 隔壁的那个点上。为什么还要用它:因为在「8 字节、范围从原子到宇宙、硬件一条指令算完」这几个要求下,定点数、分数、BigDecimal 都至少缺一样,浮点数用「随数值缩放的尺子」换来了全部,代价只是每个数大约 16 位有效数字。
所以下次看到 0.30000000000000004,大家不必把它当成 bug,它是这把尺子在 0.3 附近能给出的最好答案 📏 真正该担心的,是用这把尺子去量钱。
