
一段视频换一份清单,这条链路今天能用
验收环节最耗人的部分集中在写清单上。现场走一圈拍回几十段画面,回来还要逐条敲位置、问题、级别,再翻上次的整改记录核对哪些没落实。千问4-Max 的目录里写明输入支持文本、图片和视频,视频这一路正好把那段人工抄写接过来。
我做的验证很朴素:用画图脚本生成 8 页现场画面,每页左上角是位置、中间是情况文字、底部一行判定参考,再用 ffmpeg 拼成 16 秒、每秒 2 帧的小视频。素材虚构,判定是实的,每页该出什么结论我提前写好对照表,模型回的每行都对着核。
结果是 7 秒回 8 行,位置、结论、严重度与对照表逐页一致,一处不差。服务端记到输入 9,274 个 token、输出 239 个,思考占 151 个。8 页覆盖问题与正常两类结论、高中低三级严重度,召回和分级都没有偏差。
视频怎么递:内联 base64 与命令行 --video
接入方第一个要定的是投递方式。这次两条路都通,而且回的是同一份答案。
接口面走 compatible-mode 的消息体,视频读成 base64 内联进 video_url 字段。好处是素材不必先挂到可公开访问的地址再等对面来拉,请求自包含;要注意的是请求体跟着素材体积涨,我那版 16 秒文件本身 64,077 字节。
{

  "model": "qwen4-max",
  "messages": [
    {

      "role": "user",
      "content": [
        {
   "type": "video_url", "video_url": {
   "url": "data:video/mp4;base64,XXXX..."}},
        {
   "type": "text", "text": "逐页输出:页码|位置|结论|严重度"}
      ]
    }
  ]
}
命令行面是 bl vision describe 加 --video 直接指本地文件,--model 指到 qwen4-max 也收。同一段视频 9 秒回 8 行,与接口面那一次逐行相同。
bl vision describe --video ./patrol.mp4 --model qwen4-max --prompt "逐页输出:页码|位置|结论|严重度"
两条通道给出同一份清单,这件事比单次准确率更有用:抽样和解读在这一档素材上是稳的,按自己的工程习惯任选一条即可。过滤条件也能直接写进提示词,追加一句只列严重度为高的页,5.8 秒回来正好三行,第 1、4、7 页,没有夹带中或低,也没有漏掉那处矛盾页,输入 9,283、输出 112、思考 80。
输出预算给小,正文直接归零
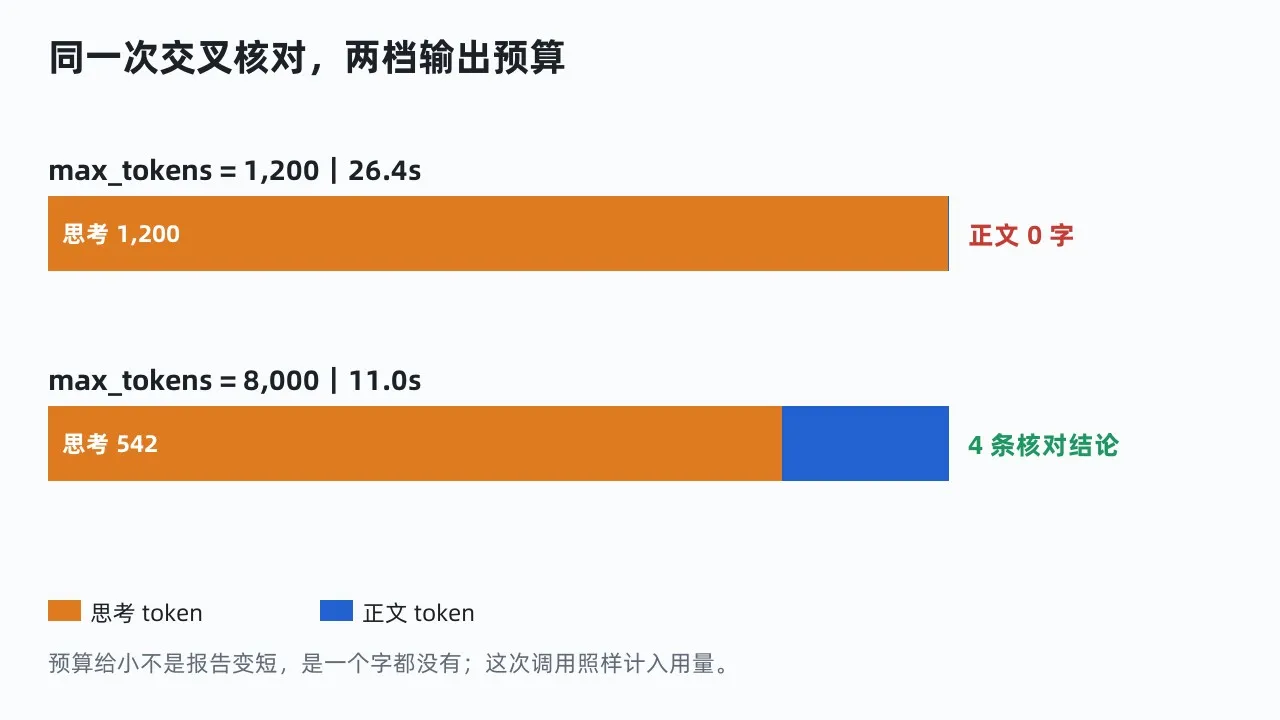
第二件事在交叉核对那一轮。我把一份上次的整改记录和视频一起递进去,记录里四条全写着已整改、复查通过:通道已清理、配电箱已加锁、指示灯已修复、标签已补贴,要求逐条核对,输出记录项、视频现状、判定。
第一次跑,26.4 秒,回来是空的,一个字都没有。输入 9,339 个 token,输出 1,200 个,思考正好 1,200 个。原因不复杂:这个模型默认开着深度思考,思考和正文共用一份输出预算,上限设成 1,200 时思考吃到顶,正文分不到一个 token。
把上限抬到 8,000 重跑,11 秒回来四条核对结论,输出 664 个、思考 542 个。四条全部判为记录与画面矛盾,其中指示灯那条还自己补了一句:第 7 页画面注明记录写已修复。它没有替任何一方圆场,记录和画面打架,它就把这件事写出来。
要落的规矩是:输出预算按你要的清单长度乘三去设。思考会先吃掉一大半,预算给小了不是清单变短,是清单消失。失败形态也麻烦,26 秒后返回一个空正文,不报错、不提示截断,排查时第一反应往往是以为素材没读进去。
一次能递多长的视频
16 秒素材记到 9,274 个输入 token,按这个密度外推,一分钟大约 34,800 个,模型单次上下文上限是一百万。也就是说别的参数不动,二十七八分钟就是这条链路的天花板,再长不是慢的问题,是递不进去的问题。
真要把两小时的监控录像过一遍,拆法分三层:先按时间切段,每段独立跑一次清单;再按事件抽关键帧,画面没变化的那四十分钟直接跳过;最后把各段清单合并去重。模型只干后两层的解读,第一层切分是你自己的脚本活。
还有一句要写进验收口径:清单每一行对应的是模型抽到的那些帧,不是每一帧,没抽到的地方就是没看见。出现漏检先查抽样覆盖,再怀疑模型能力。
两种情况它会拒绝给结论
素材本身不可读的时候。最早那版素材忘了给中文字体,页面上的字全是乱码色块,输入只记到 948 个 token、输出 505 个。模型没有硬编一份巡检结论,它逐页写画面为纯色块、底部文字乱码、无法巡检,并说明如需真实结论请重新上传。
视频里没有的依据。我在清单要求后追加一句:冷链柜内部温度是否超标。第 8 页画面只有柜门和外壁,没有任何温度信息。它在 8 行清单后单独回了一句视频未覆盖,整轮 8.3 秒,输入 9,298、输出 256、思考 157,清单部分仍 8 页全对。
这两条对接入方的价值是上层好写分支:异常输入下链路不会吐出一份看起来很正常的假结论,直接按这两类回复处理即可,不必再搭一套结果合理性判断。
上手三步与边界
第一步装命令行工具,入口在命令行安装页。第二步在控制台密钥页取 API Key。第三步按上面两条通道之一把视频递进去,模型 ID 写 qwen4-max,提示词里把输出格式一次说清:页码、位置、结论、严重度,只写画面里看得到的。
素材侧三条建议:关键画面在时间轴上多停留,别指望提高帧率补细节;中文字体缺失这类渲染问题在生成素材时就查掉,模型对不可读素材只会告诉你它不可读;输出预算按清单长度乘三设,长输出任务尤其要给足。
边界也要说清楚。它不是取证工具,清单每一行都来自模型对抽帧画面的理解,要逐帧可回溯的证据链,得用带时间戳归档的巡检系统。闭环最后一环仍然是人的:模型出清单,人把清单抄进整改记录,下次巡检时把上次的记录和这段视频一起递进去。适合的是门店自查、交房验房、活动场地检查、设备外观巡检这类走一圈回来要交纸的场景。
