
摘要:
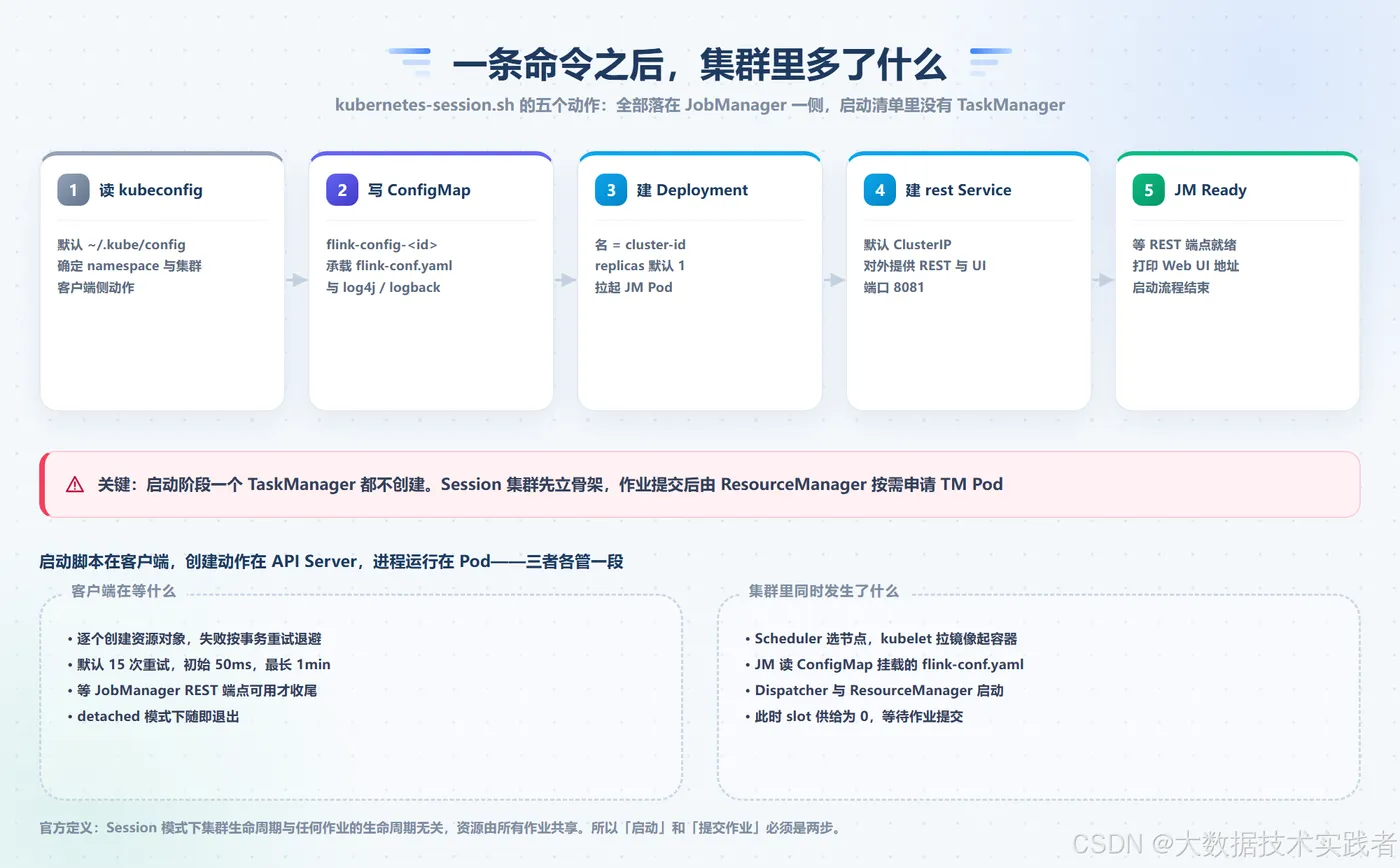
kubernetes-session.sh是 Flink 上 Kubernetes 最短的一条启动路径。但很多人没注意:这条命令跑完后,集群里一个 TaskManager 都没有。Session 启动只立骨架——ConfigMap、Deployment、rest Service 三类对象,配置在启动时一次定型,提交作业时改不动。本文基于 Flink 2.3 官方文档,拆解启动链路的五个动作、配置的"一次定型"边界、detached 与 attached 两种形态,以及启动失败的排查清单。
一、官方三步走里,藏着第四步
官方文档用三条命令演示 Native Kubernetes 的 Session 模式:
# (1) 启动 Session 集群
$ ./bin/kubernetes-session.sh -Dkubernetes.cluster-id=my-first-flink-cluster

# (2) 向集群提交作业
$ ./bin/flink run \
    --target kubernetes-session \
    -Dkubernetes.cluster-id=my-first-flink-cluster \
    ./examples/streaming/TopSpeedWindowing.jar

# (3) 删除集群
$ kubectl delete deployment/my-first-flink-cluster
第 (1) 步结束、第 (2) 步开始之前,藏着一段空窗:此时执行 kubectl get pods,你会看到 JobManager 的 Pod 在运行,TaskManager 一个都没有。这不是启动失败,而是 Session 模式的定义使然——官方在部署概览里写得很清楚:Session 模式下,集群的生命周期独立于任何作业的生命周期,资源由所有作业共享。
既然集群不依附于任何作业,"启动集群"和"提交作业"就必须是两个独立动作。启动阶段创建的是一副骨架:能接收作业、能按需申请资源的空集群。
对比 Application 模式会更清楚:Application 是"启动即带作业",main() 在集群内执行,集群随应用终止而清理,天生不需要这个空窗;Session 则是一台长期营业的"共享计算池",先开张、后接单。理解了这个空窗,后面所有设计——配置为什么一次定型、detached 为什么敢默认退出——都有了着落。
二、启动链路:五个动作,三处分工
把那条命令拆开,启动过程是五个动作,发生在三个不同的地方:
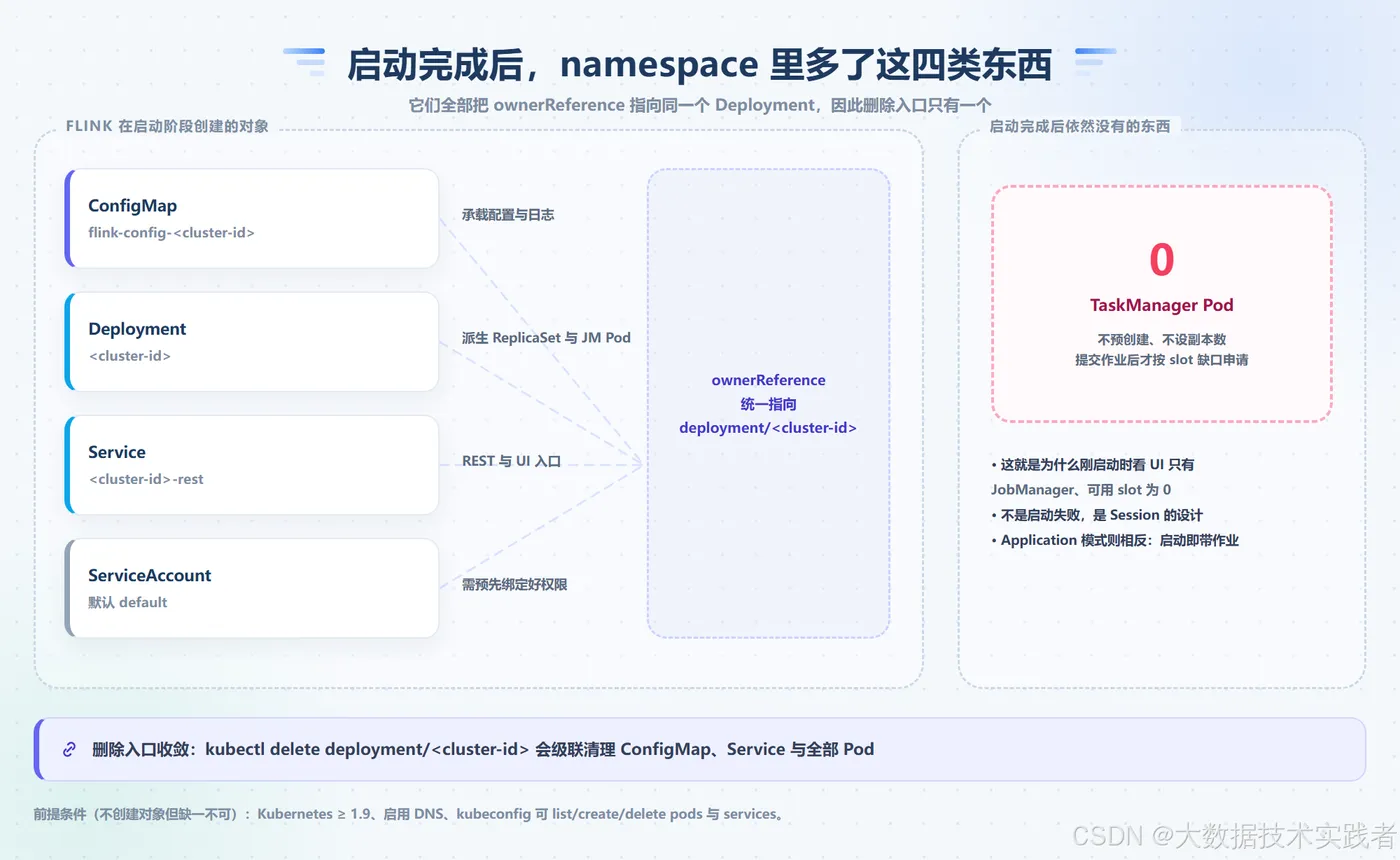
客户端读 kubeconfig(默认 ~/.kube/config),确定目标集群与 namespace;API Server 逐个接收创建请求;数据平面由调度器选节点、kubelet 拉镜像,把 JobManager Pod 跑起来。客户端真正创建的对象有三类:
- ConfigMap(
flink-config-<cluster-id>):承载flink-conf.yaml与log4j-console.properties、logback-console.xml,挂载进每个 Pod; - Deployment(名字就是
cluster-id):kubernetes.jobmanager.replicas默认 1,派生 ReplicaSet 与 JobManager Pod; - rest Service(
<cluster-id>-rest):Web UI 与 REST 端点的入口,默认 ClusterIP。
这份 ConfigMap 是整个集群的"配置母本":JobManager 与每个后续创建的 TaskManager,都从它挂载出来的文件里读取配置。日志配置也活在里面——官方支持直接编辑它来动态调整日志级别,改完对新启动的集群生效:
$ kubectl edit cm flink-config-prod-session-cluster
日常排查时很实用:不用重建镜像、不用进容器改文件,一条 kubectl edit 就能把某个组件的日志级别调到 DEBUG 再收回去。
这份 ConfigMap 是整个集群的"配置母本":JobManager 与每个后续创建的 TaskManager,都从它挂载出来的文件里读取配置。日志配置也活在里面——官方支持直接编辑它来动态调整日志级别,改完对新启动的集群生效:
$ kubectl edit cm flink-config-prod-session-cluster
日常排查时很实用:不用重建镜像、不用进容器改文件,一条 kubectl edit 就能把某个组件的日志级别调到 DEBUG 再收回去。
官方文档在资源清理一节明确:Flink 创建的所有资源——ConfigMap、Service、Pod——其 ownerReference 都指向 deployment/<cluster-id>。所以删除入口收敛为一个命令,不会留下孤儿对象。
启动之前还有四个前提:Kubernetes ≥ 1.9、启用 DNS、kubeconfig 具备 list/create/delete pods 与 services 的权限、默认 ServiceAccount 拥有 create/delete pods 的权限。官方给出的自检命令是 kubectl auth can-i <list|create|edit|delete> pods——启动失败时先跑它,能排除一大半环境问题。
三、一次定型:启动时定下的,提交作业时改不动
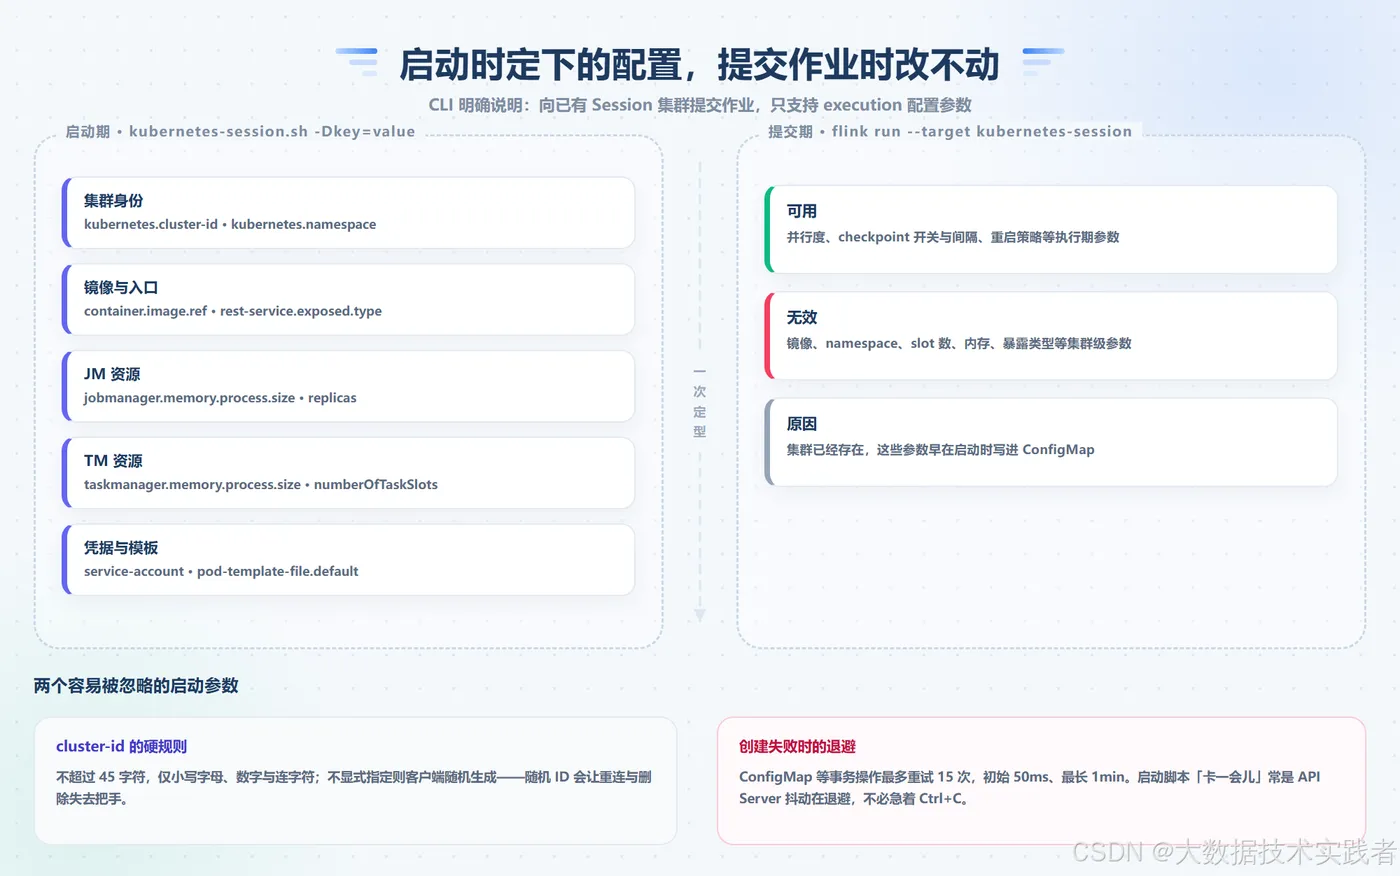
kubernetes-session.sh 支持 -Dkey=value,覆盖配置文件中的任意配置项。但有一个边界很多人踩过:向已存在的 Session 集群提交作业时,只有 execution 配置参数有效。CLI 文档原文:"When submitting a job to an existing session cluster, only execution configuration parameters are supported."
原因很直白:集群已经存在,镜像、namespace、资源、暴露类型这些参数早在启动时写进了 ConfigMap。这也是上一节那份"配置母本"的另一面——它是启动时一次写定的快照,不是每次提交作业都会重读的活配置。因此配置天然分成了两半:
| 启动期(kubernetes-session.sh) | 提交期(flink run) |
|---|---|
| cluster-id、namespace、ServiceAccount | 并行度 |
| 容器镜像、暴露类型 | checkpoint 开关与间隔 |
| JM/TM 内存、slot 数、replicas | 重启策略等执行期参数 |
| Pod 模板、nodeSelector、tolerations | 其余 -D 集群级参数无效 |
两个容易被忽略的启动细节:
第一,cluster-id 有硬规则。 不超过 45 个字符,只能含小写字母、数字与连字符,格式须满足 [a-z]([-a-z0-9]*[a-z0-9])。不显式指定时客户端会随机生成一个——随机 ID 能跑,但重连、删除、跨团队协作时你会失去唯一的把手,生产上务必显式命名。
值得单独说的是 slot 数。它看起来像作业参数,实际是集群参数:TaskManager 的内存与 CPU 是 ResourceManager 申请 Pod 时的模板,而每个 Pod 装几个 slot 决定了这个模板怎么算。作业提交时再改 slot 数,改的只是期望,Pod 的规格不会跟着变。
值得单独说的是 slot 数。它看起来像作业参数,实际是集群参数:TaskManager 的内存与 CPU 是 ResourceManager 申请 Pod 时的模板,而每个 Pod 装几个 slot 决定了这个模板怎么算。作业提交时再改 slot 数,改的只是期望,Pod 的规格不会跟着变。
如果启动时就确定要把 checkpoint 落在本地盘之外,PVC 也可以在启动参数里一并声明——PVC 须已存在于同一 namespace:
$ ./bin/kubernetes-session.sh -Dkubernetes.cluster-id=prod-session-cluster -Dkubernetes.persistent-volume-claims=flink-checkpoints-pvc:/opt/flink/checkpoints
第二,启动"卡一会儿"未必是故障。 对 ConfigMap 等资源的事务性操作自带退避重试:最多 15 次,初始 50ms,最长 1 分钟。API Server 短暂抖动时,脚本会安静地退避,Ctrl+C 反而会把一次本可成功的启动打成半途而废。
一条生产可用的启动命令通常长这样:
$ ./bin/kubernetes-session.sh \
    -Dkubernetes.cluster-id=prod-session-cluster \
    -Dkubernetes.namespace=flink-prod \
    -Dkubernetes.container.image.ref=flink:2.3 \
    -Dkubernetes.service-account=flink-service-account \
    -Dkubernetes.rest-service.exposed.type=ClusterIP \
    -Dtaskmanager.numberOfTaskSlots=4 \
    -Dresourcemanager.taskmanager-timeout=60 s
四、detached 与 attached:脚本退不退出的差别
同一个启动脚本有两种形态,差别只在客户端退不退出:
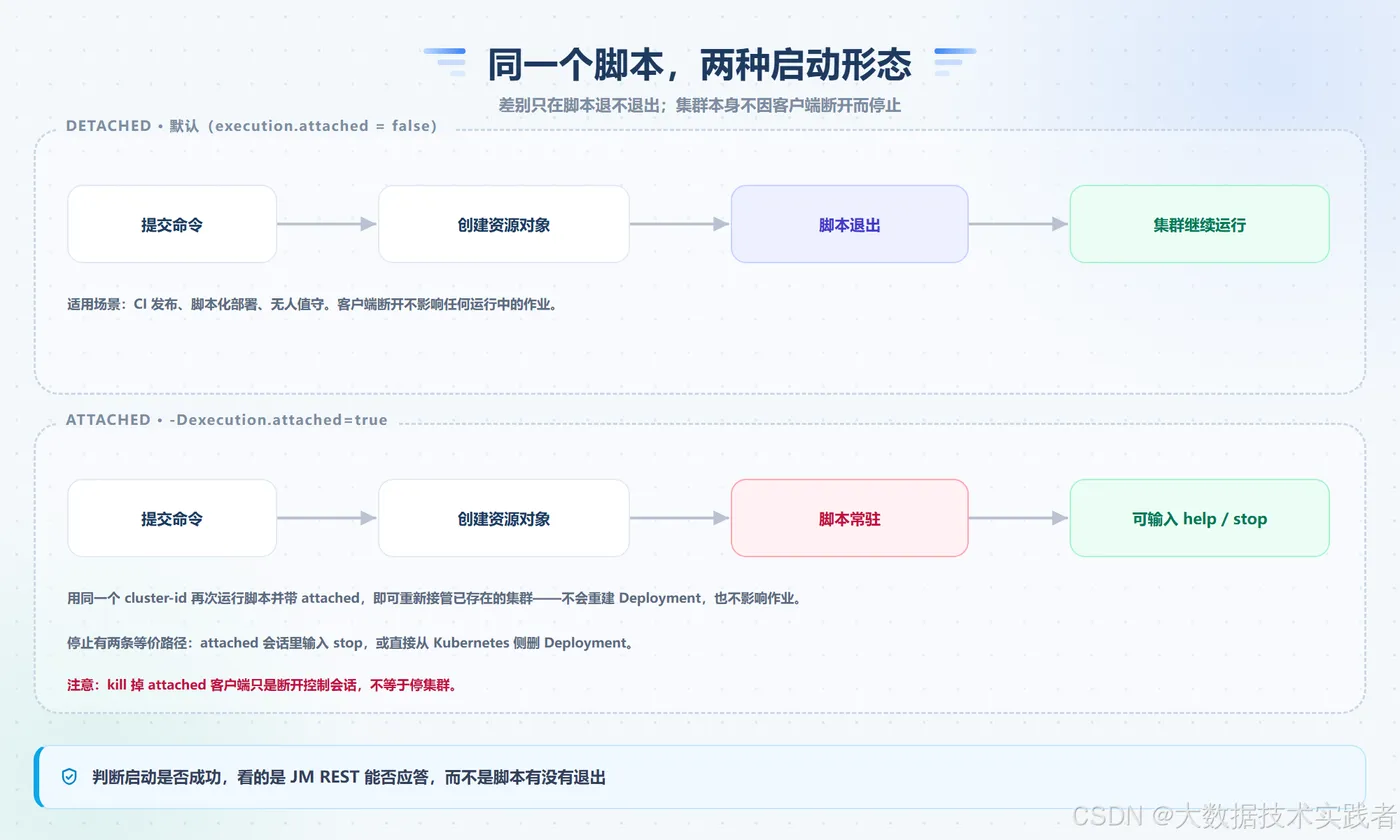
detached 是默认值(execution.attached = false):脚本部署完集群就退出,集群继续运行。适合 CI 发布与脚本化部署——客户端断开不影响任何作业。这个默认值还有一个隐藏理由:经 CLI 提交时 main() 在客户端执行,客户端要下载依赖、把代码转成 JobGraph,官方文档直言它可能是个不小的资源消费者——脚本早点退出,也是给开发机和跳板机减负。
attached 模式(-Dexecution.attached=true)让脚本常驻,可以输入 stop 停集群、help 查看支持的控制命令。对已存在的集群,用同一个 cluster-id 重新运行并带上 attached 参数即可重新接管:
$ ./bin/kubernetes-session.sh \
    -Dkubernetes.cluster-id=prod-session-cluster \
    -Dexecution.attached=true
顺带补全入口的选项表:kubernetes.rest-service.exposed.type 除了 ClusterIP、NodePort、LoadBalancer,还有第四个值 Headless_ClusterIP——不分配集群 IP,由客户端直连 Pod,多JM 或特定网络方案下会用到。
注意两点:重新 attach 不会重建 Deployment,也不会影响运行中的作业;反过来,直接 kill 掉 attached 的客户端进程只是断开控制会话,不等于停集群。停止有两条等价路径——attached 会话里输入 stop,或从 Kubernetes 侧删 Deployment(级联清理所有对象)。
re-attach 还有两个常见场景:换一台电脑接手运维、或者上个值班员忘了留下终端——只要 cluster-id 还在,任何人都能重新接管,这也是"务必显式命名 cluster-id"的第二个理由。验证集群是否在跑,脱离脚本也有办法:
$ kubectl get deployment/prod-session-cluster
$ kubectl get pods -l app=prod-session-cluster
re-attach 还有两个常见场景:换一台电脑接手运维,或者上个值班员忘了留下终端——只要 cluster-id 还在,任何人都能重新接管,这也是"务必显式命名 cluster-id"的第二个理由。验证集群是否在跑,脱离脚本也有办法:
$ kubectl get deployment/prod-session-cluster
判断启动是否成功的标准因此很清晰:看 JobManager 的 REST 端点能否应答,而不是看脚本有没有退出。默认 ClusterIP 只在集群内可达,本地验证要借助端口转发:
$ kubectl port-forward service/prod-session-cluster-rest 8081
五、启动失败的四个排查位
| 现象 | 根因位 | 处理 |
|---|---|---|
| 创建对象报 403 | ServiceAccount 权限不足 | 按 kubectl auth can-i 逐动词自检,绑定 clusterrole edit |
| Pod 停在 ImagePullBackOff | 镜像名或拉取凭证问题 | 核对 kubernetes.container.image.ref 与 imagePullSecrets |
| Pod 起不来、解析失败 | 版本或 DNS 不满足 | 确认 K8s ≥ 1.9 且 CoreDNS 可用 |
| 脚本结束但 UI 打不开 | 暴露类型为 ClusterIP | port-forward 后走 localhost:8081 |
前两类失败都指向同一个"钥匙"问题,与上一篇讲的权限链完全同源:提交侧用 kubeconfig,集群内用 ServiceAccount 的 token,两边要分别配对。第三类看起来像环境问题,实际最容易在自建集群上出现——小版本过旧或 DNS 没启用时,症状会伪装成"Pod 一直 Pending",把人往资源不足的方向带偏。
前两类失败都指向同一个"钥匙"问题,与上一篇讲的权限链完全同源:提交侧用 kubeconfig,集群内用 ServiceAccount 的 token,两边要分别配对。第三类看起来像环境问题,实际最容易在自建集群上出现——小版本过旧或 DNS 没启用时,症状会伪装成"Pod 一直 Pending",把人往资源不足的方向带偏。
多集群环境下还有一层容易漏掉:客户端连的是 kubeconfig 里哪个 context?kubernetes.config.file 可以指定配置文件,kubernetes.context 可以指定上下文——用它把不同 Flink 集群固定到不同 Kubernetes 集群,避免"起错地方"这种最难解释的事故。
最后附一份启动前检查清单,六项全绿再按回车:
- cluster-id 已显式命名,且满足 45 字符与小写规则;
- 目标 namespace、context 确认无误,
kubectl auth can-i逐动词通过; - 镜像引用正确,私有仓库的 imagePullSecrets 已挂到 SA 或 Pod 模板;
- 暴露类型与你的访问方式匹配,ClusterIP 配好 port-forward;
- slot 数与 TM 内存按"模板"算好,
-1等于 slot 数的默认值符合预期; - checkpoint 目录(远端 DFS 或 PVC)所有 Pod 可达。
六、从启动到第一份作业
启动只完成了一半。提交第一份作业后,ResourceManager 发现 slot 供给为零、缺口为正,才会创建第一个 TaskManager Pod——上一篇文章里那条"运行期申请 TM"的紫色回路,正是从这一刻开始工作的。刚启动时 UI 里可用 slot 为零,是设计使然,不是故障。
还有一个小差异值得知道:Session 模式下被认作用户 classpath 的,只有启动命令里指定的那一个 JAR;Application 模式则是启动命令的 JAR 加上镜像 usrlib 目录下的全部文件。所以 Session 集群里跑多个不同依赖的作业,依赖管理要靠 Docker 镜像和插件目录提前铺好,不能指望提交时临时带上。
还有一个小差异值得知道:Session 模式下被认作用户 classpath 的,只有启动命令里指定的那一个 JAR;Application 模式则是启动命令的 JAR 加上镜像 usrlib 目录下的全部文件。所以 Session 集群里跑多个不同依赖的作业,依赖管理要靠 Docker 镜像和插件目录提前铺好,不能指望提交时临时带上。
最后要提醒 Session 启动的隐性代价:资源共享意味着故障传染——官方文档明确指出,一个作业搞垮某个 TaskManager,同在该 TM 上的所有作业都会受影响,且大量作业同时重启可能把文件系统打满;所有作业的记账也压在同一个 JobManager 上。这也是官方建议生产环境用 Application 模式的原因:每个应用一个集群,隔离性和清理语义都更好。Session 更适合的场景是开发调试、SQL 交互式查询这类短平快的多作业共享环境。
