
这一突破性技术跳出了传统量化算法仅在数学公式层面局部优化的局限,首次从“校准数据同源性”维度入手,攻克了超大MoE模型在极低比特PTQ量化下的“系统性失效”难题,打通了万亿级MoE模型在国产算力及主流GPU上低成本部署的“最后一公里”。
ACL领域主席对该成果给予了高度评价
该工作切入了一个此前鲜有探索的关键领域,首次将“校准数据质量”提升为训练后量化的一等优化目标。“家族感知”核心假说通过蒸馏模型上干净、严谨的对抗消融实验得到直接证实,方法简单、模块化,具备极佳的系统流水线兼容性。反驳阶段的“先知对比实验”也彻底消除了数据污染疑虑,证明了极高的工业实用价值。
行业痛点:万亿MoE部署的三重困境
1.显存成本高昂
高性能模型部署的显存开销给企业级机房带来显著压力,模型量化成为绝对刚需。
2.硬件适配断层
主流GPU缺乏FP8 Tensor Core,无法直接调用推理算子,强行转换INT8/INT4格式将导致精度灾难性暴跌。
3.传统算法失效
MoE专家路由的稀疏性导致激活张量的极端稀疏与动态“离群值”,打破传统PTQ依赖“激活分布稳定”的理论假设,引发数值溢出,导致模型出现多语种混杂、重复输出等推理能力衰退现象。
传统通用校准数据与模型真实激活存在严重“分布鸿沟”。破局的重点,就在于为模型定制一份与其内部激活模式完全“同构”的校准数据。
技术突破:FAQ双引擎|以“家族同源数据”驯服离群值
针对传统校准数据的“分布鸿沟”,阿里云首创FAQ(Family-Aware Quantization)框架,通过两大核心机制实现突破:
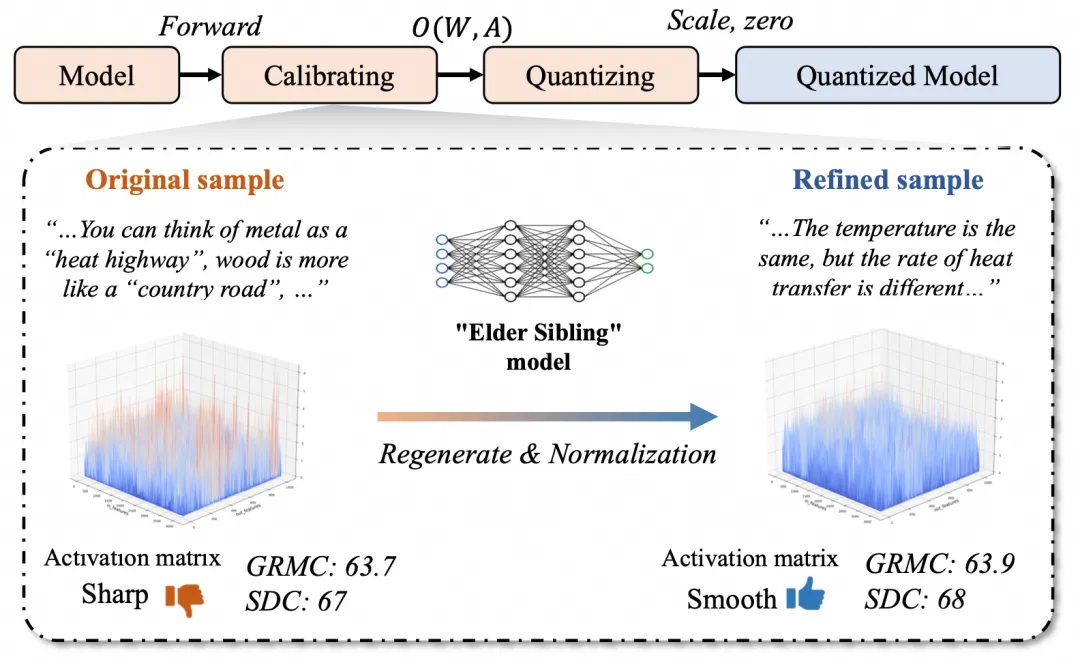
1. 同源重构:用“族长”生成完美校准数据
摒弃静态通用数据集,以高质量推理数据Numina 1.5作为种子,利用同家族最强模型(如Qwen3-235B)作为“族长”,对种子数据进行重推理并保留完整CoT思维链。生成的数据携带高度一致的激活特征,完美诱导目标模型产生平滑、自然的激活分布。
2. 双重严苛过滤:专家裁判+模版对齐
专家评审机制(Judge Selection):引入更强模型作为“裁判”,从多候选响应中精准剔除低质样本。
模版动态装配(Template Normalization):强制使用官方Chat Template格式化装配,确保输入结构与目标模型指令微调分布完全对齐。
📊 核心结论:“血统”优于“知识”
经DeepSeek-R1蒸馏到Qwen3-8B的消融测试中,在AWQ-INT4量化下,使用家族源数据比直接使用知识源数据,准确率高出1.37%,精度损失降低28.9%。对于量化而言,激活分布的同源性(家族血统)比知识来源更关键。
应用落地:护航智算集采项目,突破部署瓶颈
FAQ技术已在智算集采项目中成功验证:在缺乏FP8硬件的主流及国产算力上,通过FAQ技术,当前已实现DeepSeek-R1(671B)高精度部署,显存占用减半、吞吐量倍数级跃升,高难任务精度损失降低28.9%。未来,阿里云将推出一键式超大模型量化部署服务,以更低算力成本释放万亿参数模型的核心价值,加速AI在真实产业场景中的规模化落地。
