
ACL领域主席对该成果给予了高度评价
该工作跳出了“更大模型加更多rollout”的惯性思路,将焦点重新拉回到训练数据本身,提出的层级化经验框架通过对比蒸馏与多层级聚类,将原本随机散乱的轨迹转化为结构化、可复用的策略性经验,在多跳问答与数学推理两类异构任务、以及多种主流RL算法上均展现出一致且显著的提升,具有良好的通用性与工程价值。
行业痛点:智能体搜索的“随机探索”困境
随着LLM Agent与工具使用能力的快速演进,基于强化学习的智能体搜索(Agentic Search)正成为下一代企业知识系统的核心范式。然而,其规模化应用仍面临多重困境:
1.探索过度随机化,训练效益低下
主流方案高度依赖结果奖励驱动的随机轨迹采样,缺乏全局策略规划。Agent在多轮搜索-推理过程中反复“踩坑”,训练昂贵但收益降低。
2.训练严重不稳定,小模型“立不住”
多轮交互场景下奖励信号稀疏且不一致,端到端RL训练剧烈震荡,模型容易陷入次优策略,在复杂多跳问题与垂域专业问题下表现得尤为明显。
3.产业化阻力:“小模型不够用、大模型用不起”
在医疗、制药、金融等强专业领域,非专业用户使用AgenticRAG时常遭遇召回不全、证据不准等痛点。而高质量回答往往依赖千亿级大模型,企业面临“小模型不够用、大模型用不起”的真实阻力。
面向以上企业级AI训练过程中的常见问题,急需一种新型训练数据价值挖掘机制,让Agent摆脱“碰运气式”的随机探索,转而沿着可复用、可累积的经验路径不断收敛,使得小模型也能在垂域中真正“立得住”。
技术突破:HiExp双引擎|把“随机探索”升级为“经验制导”
阿里云团队提出了HiExp(Hierarchical Experience)框架,通过两大首创技术创新,破解上述难题:
1.智能经验抽取
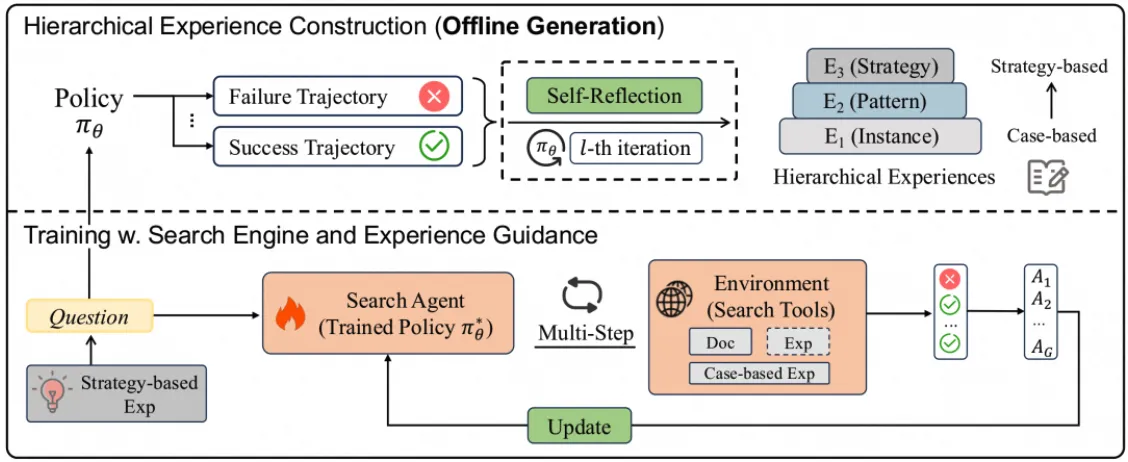
HiExp不再把rollout当成黑箱样本喂给RL,将成功轨迹与失败轨迹配对进行对比反思。
关键动作:自动抽取出“关键决策点”与“推理陷阱”,形成原子级实例经验。
效果:让Agent在训练前先“提炼历史经验”,把暗藏在轨迹中的隐性知识显式化。
2.层级经验抽象
在原子经验之上,HiExp通过语义嵌入与凝聚式聚类,将海量实例经验自下而上抽象为更高层的策略原则。
构建HEK:构建出层级化经验知识库(HEK,Hierarchical Experience Knowledge)。
动态制导:训练阶段,系统根据当前query的语义动态检索匹配的经验进行制导,把“无方向的随机搜索”重塑为“有经验可循的策略性搜索”。
📊多项实验结果表明,HiExp展现出显著的可扩展性和有效性:
- 多跳问答:在2Wiki、Musique、BrowseComp等主流基准上,HiExp相较强基线带来近双位数的F1提升;
- 数学推理:在AIME、AMC等任务上同样取得显著增益;
- 广泛兼容:在GRPO、GSPO等不同RL算法、本地检索与网页搜索等不同环境中均保持一致提升。
落地与展望:小模型解决真问题,数据价值驱动智能化
目前,HiExp方案已在阿里云AgenticRAG产品体系中持续打磨,并在与阿斯利康共建的医疗检索问答场景中完成产业级验证。在人工评测中,经HiExp训练的8B小模型在准确性、证据使用及完整性上超越千亿级旗舰大模型,综合效果相对提升约37%,真正实现了“低成本、高性能”的商业化闭环。
未来,阿里云将持续推动“小模型也能解决企业级真问题”的愿景加速落地。我们坚信,训练数据的真正价值,而非单纯的模型尺寸,将成为驱动企业智能化的核心燃料,助力医疗、制药、金融等强专业垂域以更优的成本结构释放AI核心价值。
