
这不是虚构的故事,而是很多大规模智算集群的运营中的真实日常。一个万卡集群,几乎每天都要面对GPU故障,而不少故障可能在常规演练中从未出现过。
与此同时,新一代AI芯片正加速涌入集群部署。每款新芯片从进场到稳定运行,都要经历漫长的验证。传统方式是什么?工程师盯日志、翻文档、猜根因、试修复——一个来回,一个月就过去了。
前线急着要算力,后方还在“人肉排障”, 这已成为制约智算集群从“能用”走向“好用”的核心瓶颈之一。
航空业给我们的新启示
Q:飞机首飞之前怎样验证安全性?
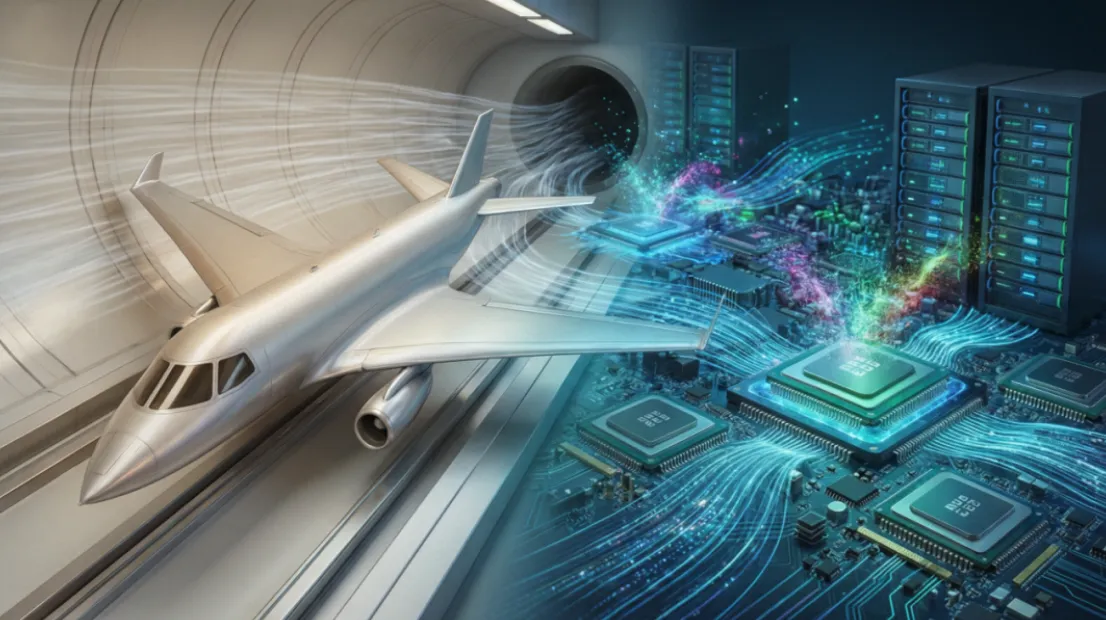
不是立即把飞行员送上天“试试看”,而是先借助地面风洞——用可控气流模拟暴风、失速、引擎熄火等上千种极端工况,把可能出问题的地方全部验证一遍。
我们想给智算集群也造一座这样的“风洞”。
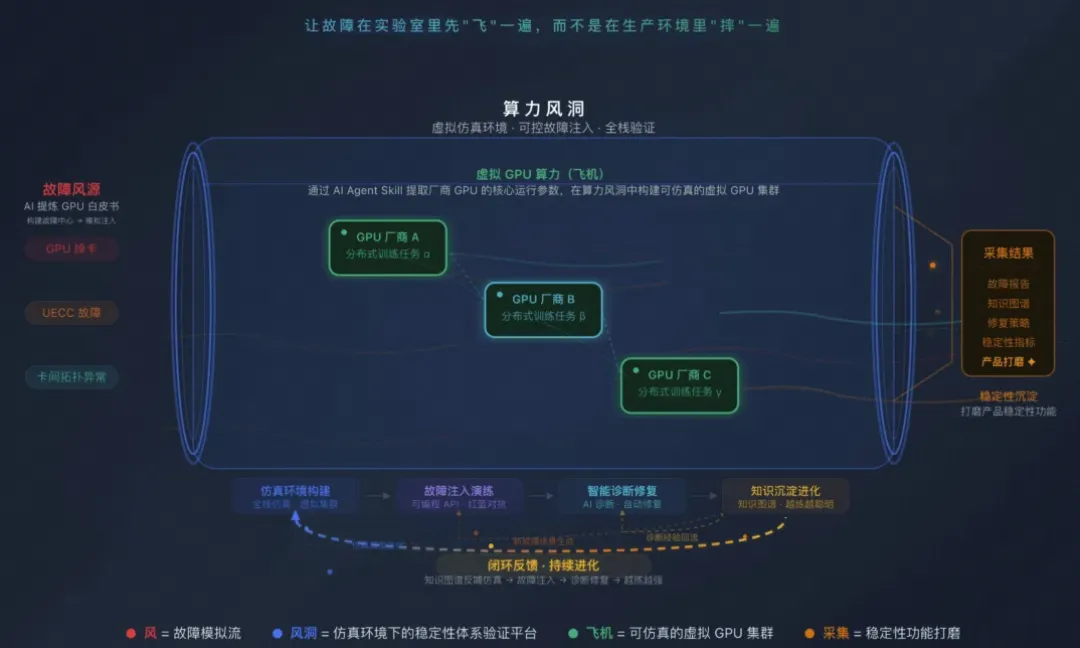
不是物理意义上的风洞,而是一座数字化的“算力风洞”——在虚拟环境中复刻真实集群的运行状态,用AI模拟各种GPU故障,在芯片上线之前就完成充分的稳定性验证。
让故障在实验室里先“飞”一遍,而不是在生产环境里通过“摔”摸索经验。这个想法,最终在阿里云专有云飞天企业版上落了地。
算力风洞,能帮客户解决什么?
作为承载政企客户核心智算业务的基础设施平台,飞天企业版天然需要解决多芯混部、大规模集群稳定性的问题——算力风洞,正是为这个痛点而生的。
对运营大规模多芯智算集群的客户来说,算力风洞的价值可以概括为三个关键词:
- 快:从“月级适配”到“天级上线”
过去,新GPU芯片从加入集群到高效被调度,需要工程师在真实环境中反复试错,周期动辄以月计算。
算力风洞改变了这个节奏——通过全栈仿真技术,直接模拟上百张卡的运行环境。GPU服务器进场前,AI已经“读完”了技术文档,构建好仿真模型,甚至把其他芯片踩过的坑提前"预演"了一遍。适配效率提升10倍以上,版本验证从月级压缩到天级。
- 全:从“常见故障”到“长尾场景”全覆盖
传统演练只能测“已知”故障。多卡同时掉线、网络风暴叠加等极端场景,没人敢真拿生产集群做"破坏性实验"。
但在风洞里,故障被变成了可编程的API,AI还会主动“出难题”——红蓝对抗机制让系统挑最刁钻、最冷门的故障来演练。那些“防不胜防”的长尾故障,也正在被逐一纳入防线。
- 智:从“被动救火”到“越用越聪明”
传统稳定性方案是静态的。而算力风洞是一个“活”的系统——每次演练结果自动沉淀为知识,AI分析每一步决策是否最优,然后更新自己的"故障知识图谱"。知识长在平台里,不会因为人员变化而失效。
系统越练越聪明,故障恢复也从小时级压缩到分钟级。
算力风洞,让算力部署更快、运行更稳
在某次端到端验证中,系统在虚拟节点上启动分布式训练任务,然后AI向其中一个节点注入“GPU缺失”故障——模拟三张卡突然掉线。
接下来完全自动:监控秒级感知异常,AI接手诊断,从观测指标到检索知识图谱到执行修复,全程无需人工介入。训练任务自动迁移到健康节点,从最新检查点恢复训练。从故障发生到业务恢复,压缩在分钟级别。
演练结束后,系统自动生成故障报告,并将新经验写入知识图谱。下次再遇到类似故障,系统也会更快、更准。
这不是实验室里的“理想态”,而是经过生产落地应用的真硬核技术。在飞天企业版的多个智算集群交付项目中,算力风洞正在帮助客户将新芯片适配周期从月级压缩到天级,让大规模集群的稳定性从“靠人盯”变成“靠系统保”。
写在最后
大模型时代,算力就是生产力。当集群从千卡迈向万卡甚至十万卡,稳定性不再只是技术指标——它是业务连续性的底线。
算力风洞做的事情,本质上是用AI把“稳定性”这件最依赖人的事情,变成了可量化、可验证、可进化的工程体系。对客户来说,最直观的感受就是:新芯片上线更快了,故障更少了,恢复更快了,系统更聪明了。
从“人盯屏幕”到“AI闭环”,从“被动救火”到“主动防御”——阿里云专有云飞天企业版,把这条路变成现实,为企业级AI提供稳定高效的基础设施。
