一句话定位:这不是"AI 扫描准不准",而是"一条告警在流程里拥有多大权力"——载体是 PR 上的扫描结果,对象是它能不能改变合并决定。同样的判断可迁移到接口契约检查、单元测试覆盖率门禁、依赖漏洞扫描的准入规则。
摘要
GitHub 在 2026 年 10 月 15 日把面向 PR 的 AI Scan 转为正式可用(GA),它补的是 CodeQL 尚未覆盖的语言与框架:PHP、Shell/Bash、Terraform(HCL)、Dockerfile、JSP、Blazor 等。结果与 CodeQL 并排显示、带 AI 标识、可附修复建议——但公告写明它是 advisory:不会让 code scanning 检查失败,也不能通过 ruleset 阻止合并,且不在 fork 与 Dependabot 的 PR 上运行。本文讲这个"只提示不拦路"的设计给测试团队留下了什么活。
打开一个 PR,Files changed 标签页里多了一条带"AI"标记的告警:某段 Terraform 里的访问策略写宽了。
你想把它设成"必须修复才能合并"。设不了。
这不是配置没找对。GitHub 在 2026 年 10 月 15 日的 Changelog 里把话说得很直:AI Scan 的结果是 advisory,不会让 code scanning 检查失败,也不能通过 ruleset 要求阻止合并。
它到底补了哪块
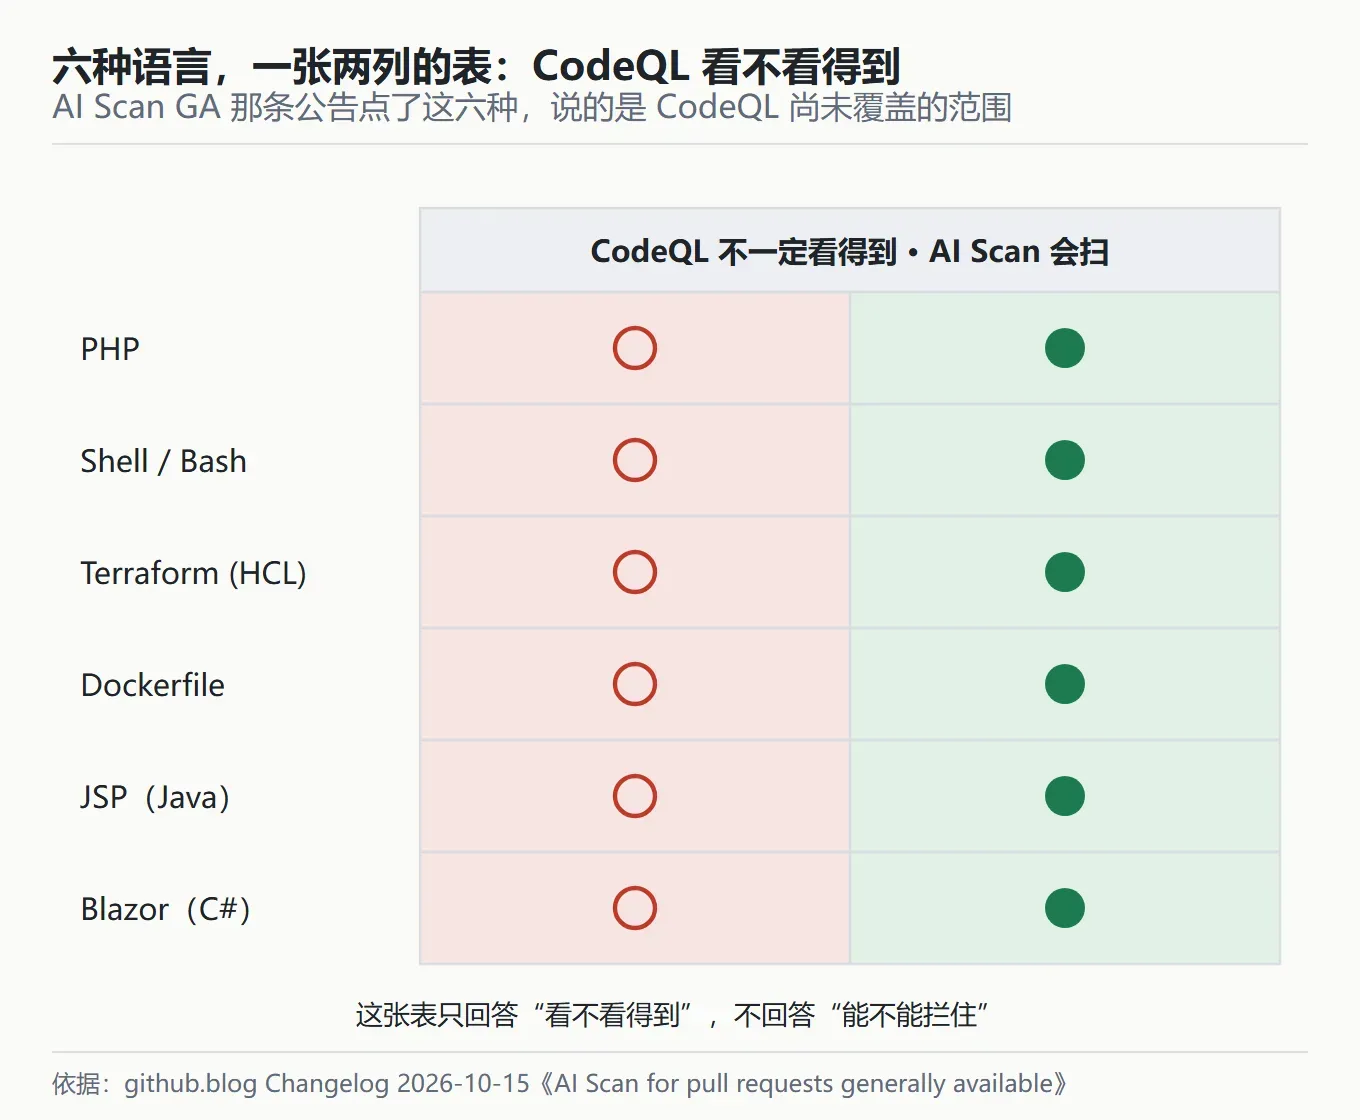
公告原话是:它补充 CodeQL,在 CodeQL 目前不覆盖的语言和框架里找 PR 变更的漏洞,包括 PHP、Shell/Bash、Terraform 配置(HCL)、Dockerfile、面向 Java 的 JSP、面向 C# 的 Blazor 等。
"CodeQL 覆盖不到"这个前提值得单独说一句。CodeQL 靠的是把数据流建模,一种语言要建模就得先写查询和数据库,成本高;这套体系的强项是深,弱项是广。剩下的长尾语言、配置文件、构建脚本,长期是空白的。AI Scan 填的正是这条缝。
运行条件也写明了:仓库启用 code scanning 且该仓库的 AI Scan 设置为开时,PR 打开和每次新提交都会跑,且不需要 build。收费走 Code Security AI Credits;公开仓库可用,私有与内部仓库需要 GitHub Code Security 或 GitHub Advanced Security,但不要求 Copilot 许可证。
advisory 这三个字的重量
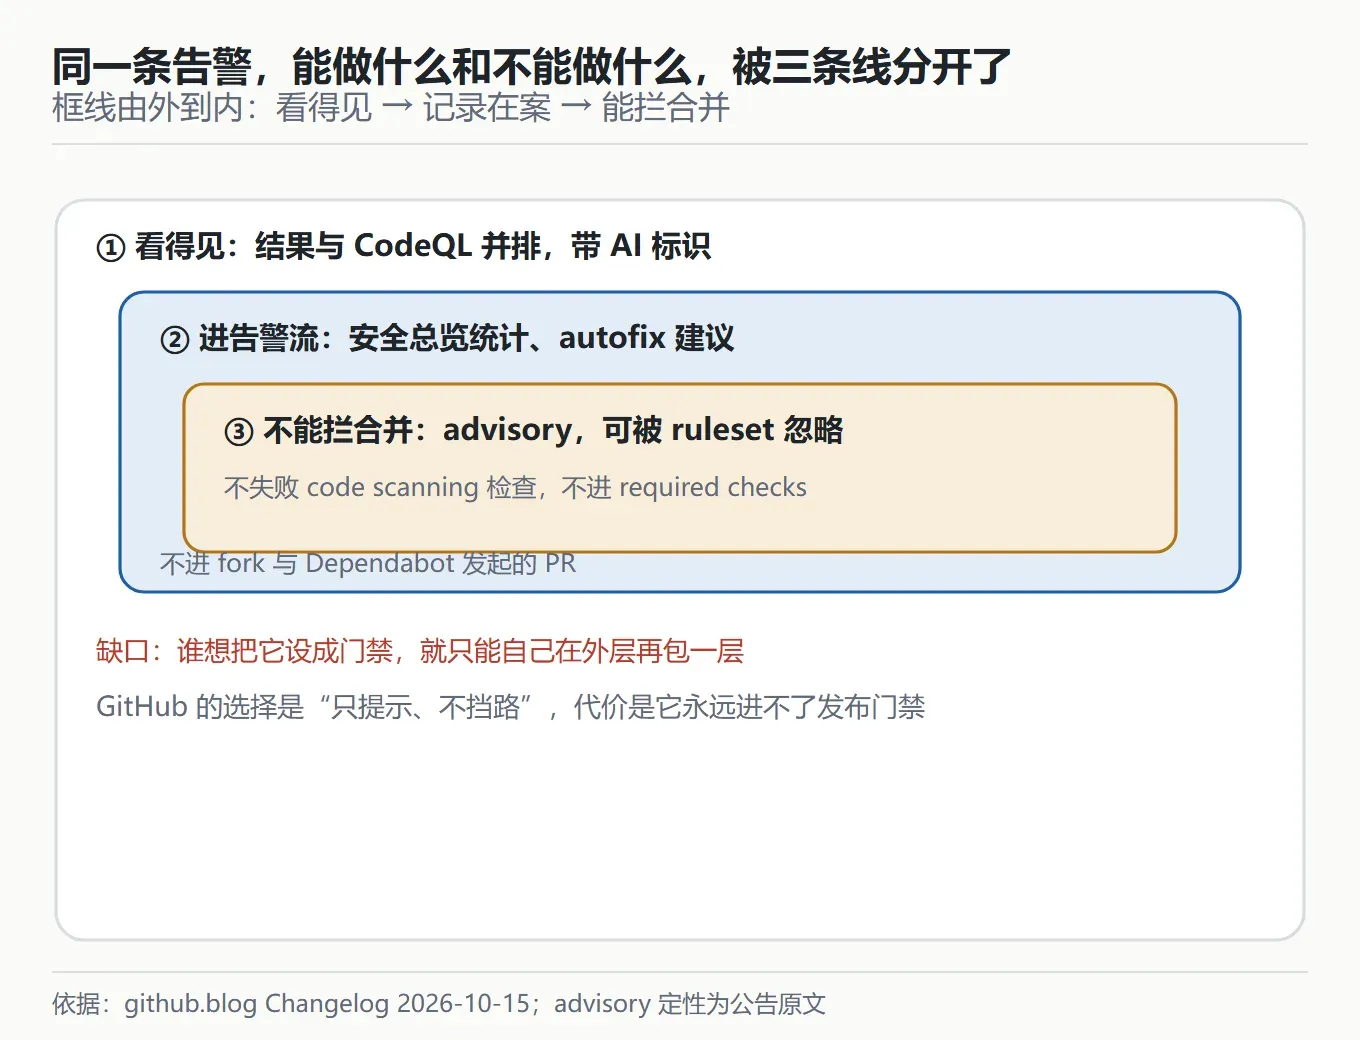
这是一个刻意的设计,而且我认为它对。理由很简单:LLM 的判断是概率性的,它给的是"这里像是有问题",不是"这里一定有漏洞"。把一个概率判断接进合并门禁,团队很快会学会点"忽略",然后连真正的阻断也一起被忽略。
但设计对的代价是,它在流程里的位置被固定在"参考"这一层。
对测试团队来说,这个位置决定了三件事:
第一,它不能替代原有的必过检查。原本用 CodeQL 必过项守住的仓库,加了 AI Scan 之后并不等于"长尾语言也有人守了",因为那条告警没有任何强制性。
第二,它能改变的是分诊队列。公告说结果会进安全总览统计、可附 autofix 建议。也就是说,它给你的是"值得看的一批东西",而不是"必须处理的一件事"。
第三,想让它真的进发布门禁,只能在外层再包一层:拉 alert API、按严重度过滤、自己判定阻断条件。这层包装写起来不难,难的是判定标准——什么算"必须修"。
那些没被覆盖的 PR
公告里有一条容易被跳过的限定:AI Scan 不在来自 fork 的 PR 上运行,也不在 Dependabot 创建的 PR 上运行。
开源项目里,绝大多数外部贡献正好是 fork PR。也就是说,对一个靠外部贡献的仓库来说,这项能力的实际覆盖面比清单看起来小得多。
这条限定在测试设计上的含义很直接:如果你要评估"接入 AI Scan 之后漏洞拦截率提升了多少",不能拿全量 PR 当分母。分母得先扣掉 fork 与 Dependabot,否则提升会被算低,或者反过来,你会以为覆盖了而实际没覆盖。
与 agentic autofix 配合时的两层关系
同一天上线的还有 agentic autofix:把最多 25 条 code scanning 告警指派给 Copilot,它会探索代码库、提出修复、重跑 CodeQL 验证、提交草稿 PR 供人工评审。公告的范围是 GitHub Enterprise Cloud。
两者拼起来是一个挺完整的闭环:AI Scan 发现长尾语言的问题,agentic autofix 针对已有告警出修复。但闭环缺了关键一环——验证。
autofix 自己重跑的是 CodeQL。而 AI Scan 发现的很多问题,CodeQL 根本不覆盖,重跑它能验证什么?公告没有讲这一层。这是我读这条时最大的疑问,也是测试团队应该问的问题:如果一条 PHP 告警由 Copilot 出修复,谁来判断修好了?
可行的答案是自建验证:给这类仓库配一套运行时的复现用例,或者至少配一条规则化的静态检查。这不是 GitHub 的责任,是接入方的责任。
一条被低估的限制:它不扫整个仓库
这次 GA 的范围是PR 变更。公告写的是"find vulnerabilities in pull request changes",不是全仓库扫描。整仓扫描的形态在另一条 Changelog 里(2026 年 10 月 28 日进入公开预览),而且预览版分析的是默认分支的全量代码。
这两种模式的区别,正好对应测试里常说的"增量检查"与"全量检查"。
增量检查的优点是快、噪音少、能拦住新引入的问题;缺点是历史存量完全看不见。一个已经跑了两年的 PHP 后台,接入 AI Scan 之后,PR 里新增的代码会被看,但那段写着 shell_exec($_GET['cmd']) 的老代码不会因为"今天有人改了旁边的注释"而突然被发现——除非它出现在本次 PR 的变更里。
所以接入策略要写清楚:它负责不新增,存量要靠单独一轮全仓扫描。这两件事在报表上应该分开算,混在一起会得出"接入即清零"的错觉。
判定标准落到谁手里
把上面的东西合起来,这项功能其实把一件老问题重新推到了测试团队面前:当工具只给建议、不给结论时,谁来决定放行。
GitHub 给了一个态度鲜明的答案(不拦),把这个决定权留给了接入方。这个答案合理,因为只有你才知道你的仓库能承受什么风险。但它也意味着,接入之后的第一份工作不是配置,而是写判定规则:
| 你的选择 | 需要写清的东西 |
|---|---|
| 完全参考 | 不阻断,进入周度分诊队列;谁来分诊、多久一次 |
| 部分阻断 | 哪几类问题算阻断(注入、访问控制),哪几类只记录 |
| 自建门禁 | API 拉取、严重度映射、与现有 ruleset 的关系 |
三行选一行就好,但必须选。默认状态(什么都不写)实际上等于选了第一行,而很多人以为自己选了第三行。
与同类工具的参照
CodeQL 这条路线走了很多年,它的取舍是"建模越深、覆盖面越窄"。AI Scan 走的是另一个方向:覆盖优先,深度与确定性交给人工判断。
这两种路线的组合,正在成为主流形态——确定性工具负责必过门禁,概率性工具负责扩大视野。这个分工本身不新鲜,新鲜的是它第一次以产品形态出现在 PR 页面里,而且明确标注了 AI 标识。
标注 AI 标识这件事值得单独说一下:它让读者知道这条告警是"模型说的",而不是"规则算出来的"。分类可见,比准确率更高更重要——因为没有标注,分诊时就没法给两类告警设不同的处理节奏。
我的建议:把它当"第二双眼睛",别当"第二道门"
落地层面,我认为三件事值得做:
一是分层设门。必过门禁继续用确定性工具(CodeQL、单测、构建),AI 扫描放在"分诊"层,按周批量看,不按 PR 逐条看。逐条看会让团队疲劳,批量看才能看出模式。
二是给 AI 告警单独记账。记录发现数、采纳数、误报数、修复耗时。GitHub 的安全总览里已经有 AI Scan 的指标(出现在 10 月 13 日的预览里),接入方要做的是把它和自己的工单系统对起来。
三是把"不能不拦"写进流程文档。这听起来很废话,但很多团队的误解恰恰在这里:以为接了 GA 功能就等于有了门禁。写清楚它的权限层级,比写清楚它的覆盖语言更重要。
一句话总结
这项功能最值得学的地方,不是它用 AI 找漏洞,而是它明确规定了 AI 判断在流程里的权力边界——只提示、不拦截、可被忽略。这个边界一旦写清楚,团队就知道自己该补哪一层。
反过来,如果一项 AI 能力悄悄被设成必过项,那才是要担心的:它不是更严格,只是更容易被绕过。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。