一句话定位:这不是"哪个模型更强",而是"多个 Agent 并行产出结果时,谁来判定这些结果是真的"——载体是一支 Agent 团队,对象是它们彼此的产出与验证关系。同样的方法可迁移到多角色审批、客服工单多人协办、库存扣减的多系统对账、发布上线的多人复核。
摘要
Google DeepMind 2026 年 11 月 10 日发布 Gemini 4 Carbon,同时预告了 Antigravity 里的 /swarm:一句提示词派出一支 Agent 团队,每个 Agent 在独立的隔离工作区并行干活,另外还有 "adversarial verifiers"(对抗式验证器)逐一检验每一处改动。这条产品描述只有一句,却把多 Agent 系统最难的验收问题摆到了台面上。本文拆"验证者与生成者分离"为什么是必要条件、它在什么条件下会失效、以及一个三人团队怎么在现有 CI 里复刻这个结构。
一句提示词,派出去一支团队,每个成员在各自隔离的环境里干活,然后有一个角色专门负责指出哪里不对。
这是 Google 在 2026 年 11 月 10 日发布 Gemini 4 Carbon 时,对 Antigravity 新功能 /swarm 的描述。原文只有一句,但这句话里有一个词值得单独拎出来:adversarial verifiers,对抗式验证器。
在它之前的所有描述都是关于"怎么做得更多"——更深的推理、更多的 token、更长的验证循环、并行的隔离工作区。只有这半句在讲"怎么知道自己做错了"。而后者,才是把多 Agent 系统从演示推进到生产的真正关口。
先把事实边界划出来
需要说清楚这条信息的属性。这是 Google 官方博客里对 /swarm 的一段预告性描述,属于产品发布公告,不是评测报告,也不是第三方复现。博客给的相关数字也都是 Google 自报:Carbon 在 CursorBench 4.0、Perplexity 的 WANDR、Zapier 的 AutomationBench 上排第一,同时每次任务成本比次优的外部模型低两倍以上;与 Artificial Analysis 合作推出的多模态知识 Agent 基准(MKA)上,Carbon 排第二,平均每次任务成本比第一名低六倍以上。
这些数字在本文里只作为"这个能力被宣称存在"的佐证,不作为本文论点的证据。本文要拆的是结构,不是分数。
另外需要标明:Google 在 11-16 之前还发布了 Gemini Robotics 2.5,其中提到一个开源的越狱测试基准 ASIMOV-Jailbreak,以及 Gemini 4 Argon 在该基准上 99.5% 的抗越狱率、对比前代 82% 的基线。那个数字属于 Argon,不属于 Robotics 2.5,也不属于本文讨论的 Carbon。同机构短期内连发多条公告时,数字串味是最常见的错误,这里先划清。
为什么"多 Agent 并行"一定会带来一个新的验收问题
单 Agent 的验收逻辑很直接:它输出一个结果,你拿一个标准去比对。多 Agent 并行时,这个逻辑断在两处。
第一处是归因。当一支团队并行产出七个结果,最后汇总成一个交付物,如果这个交付物有问题,问题在哪个成员身上?在隔离工作区的设计里,每个成员的中间过程是分开的,汇总时才合到一起。这时候"谁的错"不是靠读代码能看出来的,得靠回溯到每个成员各自的产出。
第二处是串通。这个更微妙。假设你让三个 Agent 互相检查,A 说没问题、B 说没问题、C 说没问题,三个声音一致。但一致不等于正确——它们可能用了同一套错误的判断依据,也可能因为提示词里"友好协作"的措辞而倾向于不否定同伴。Anthropic 在 11 月初公布的多人协作实验里就记录过一个相关现象:两个 Agent 反复互相礼让、谁都不下决定,形成了"礼貌死锁"。协作性好不等于判断准。
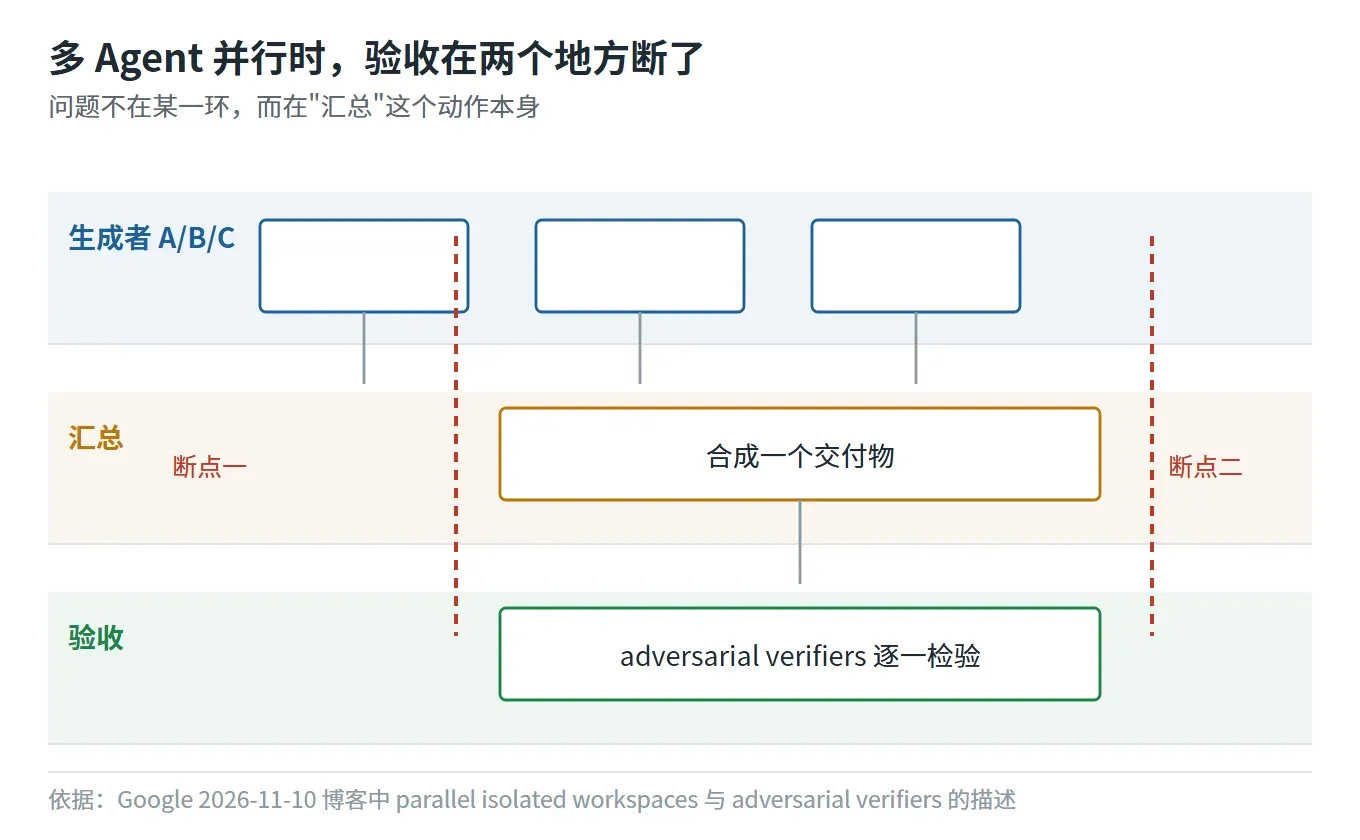
这两处问题指向同一个结论:验证者不能是生成者的同类项。同一个模型、同样的提示词风格、同样的上下文,检查出来的只会是同一个盲区。
对抗式验证器解决的是哪一半
adversarial verifiers 这个词落在"adversarial"上,含义是:这个角色的任务不是确认,而是否证。它的目标函数和生成者相反——生成者要让东西成立,验证者要让它不成立。只有推翻不了,才算通过。
这个结构在软件工程里不新。N-版本编程要求同一功能由不同团队独立实现再比对;代码评审里有一条常识叫"写代码的人不评自己的代码";安全测试里的红队,任务就是突破而不是确认。Google 把这条原则搬到了 Agent 团队内部,让它成为 /swarm 的一个组成部分而不是外部环节。
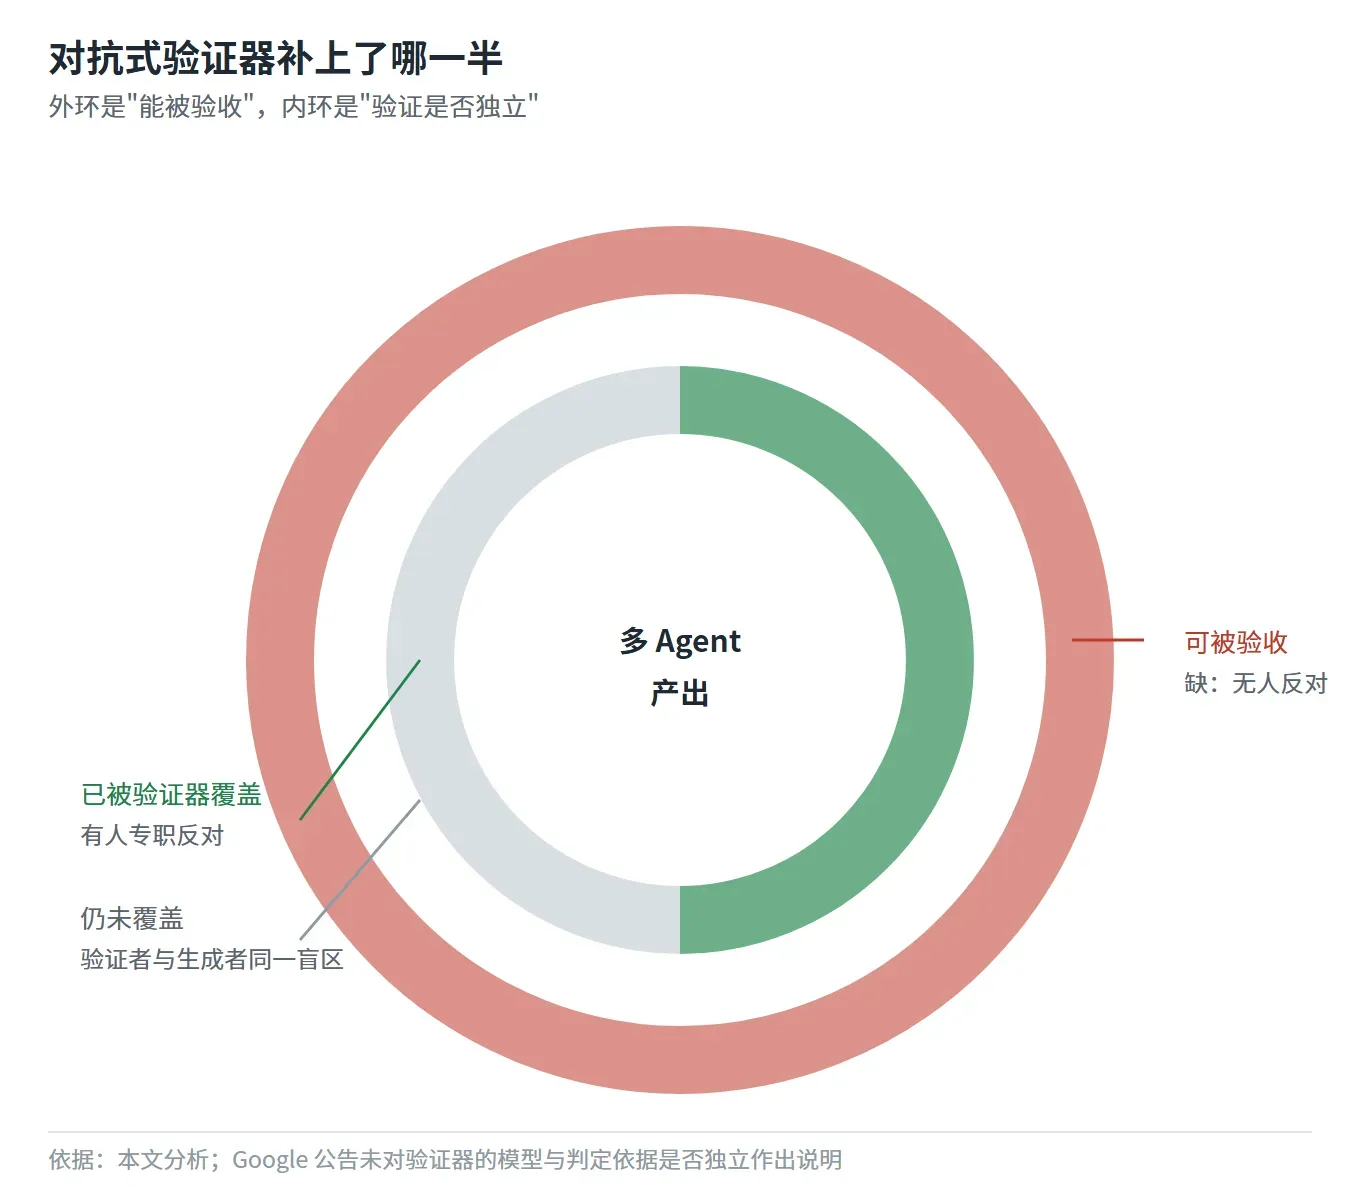
它解决的是"串通"那一半:因为验证者被赋予了反对的立场,"一致"不再是它追求的结果。它也部分解决了归因那一半:如果每个改动都被逐一检验,出问题的位置在检验环节就能被标出来,不用等汇总。
但它解决不了盲区那一半。如果验证者和生成者用的是同一个模型、读的是同一批资料,那它的"反对"仍然只能在同一个知识边界内反对。这一点 Google 的公告没有说,因为它是一句产品预告,不是一篇方法论。
所以我在自己的判断里,把这条能力记为"必要但不充分"。必要,是因为没有它,多 Agent 的产出无法验收;不充分,是因为它只保证有人反对,不保证反对得对。
在 CI 里复刻这个结构,最小可行版本
三人以下的团队做不了 /swarm,但可以复刻它的核心结构。三个动作:
动作一:把验证者的输入切断。 验证者不读生成者的推理过程,只读产出物和判定标准。这一条最难执行,因为工程师天然想看 Agent 是怎么想的。但读了推理过程,验证者就会被生成者的叙事带走,独立性立刻消失。
动作二:把验证者的目标写成否定式。 不是"检查这段代码是否符合规范",而是"找出这段代码在什么输入下会出错"。前一个是确认任务,后一个是证伪任务。同样的模型,换一个任务描述,产出的东西完全不同。
动作三:让验证结论可被反证。 每一条验证意见都要带一个具体的复现条件。"这里可能并发有问题"是无效意见;"两个请求同时携带同一个幂等键、间隔小于 50ms 时会重复扣减"是有效意见。前者无法验证,后者跑一次就知道对不对。
第三条是我认为最有区分度的一条。它把"验证"从一种态度变成了一种可执行的动作,也顺带解决了 Agent 意见过多、人读不完的问题——读不完是因为大部分意见没有落点。
一个反例:什么时候这个结构会浪费成本
不能只说好处。以下三种情况下,加一个对抗式验证者是负收益:
产出物本身可被机器直接判定。 编译过不过、类型对不对、单测跑不跑得通,这些有现成的判定器,再加一个 Agent 去"反对"是多余的开销。
任务高度确定、变化极少。 一条跑了三年没出过问题的数据同步脚本,加验证者只会增加延迟。
验证者拿不到判定依据。 如果没有人能写清"什么算对",那验证者的意见只能靠它的先验知识,而先验知识恰好是最容易和生成者重合的部分。这时候加验证者,得到的是两份相似的猜测。
换句话说,对抗式验证器的价值不在"多一双眼睛",在"多一套独立的判定依据"。眼睛可以借,依据借不了。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。