
做消防设备上云时,很多问题不是出在协议,而是出在事件表设计。系统里只有一张 `event` 表,用 `status=1/0` 表示发生和恢复;报警、故障、屏蔽、短路隔离、设备掉线全塞进同一个字段。页面能弹出消息,历史却很难解释:这条故障是设备自己报的,还是网关判的?这次离线是设备故障,还是网络断了?人工确认以后,火警到底恢复了没有?
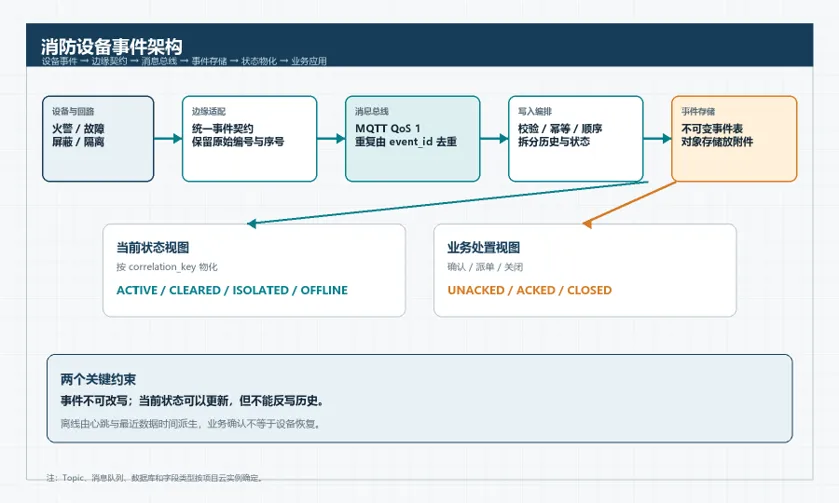
我更愿意把设备行为拆成四个事件族,再把“发生过的历史”和“现在是什么状态”分开。原始事件不能被后续操作覆盖,当前状态则从事件流中物化出来。这样既能保留证据,也能给值班页面一个直接可查的状态视图。
先把事件和当前状态分开
事件是一条已经发生、不可改写的事实。比如 14:05:10,03 回路 42 号设备产生火警;14:07:31,该火警恢复。它们是两条独立事件,不能把前一条事件的类型、设备编号和时间一起改掉。
当前状态是另一个数据结构。它可以随着新事件更新,只回答“此刻处于什么状态”。同一个设备可能同时有火警、故障和屏蔽,所以设备状态不能设计成一个互斥枚举。用 `normal` 一支笔覆盖全部分类,迟早会出现“火警还在,页面却显示正常”的情况。
GB 50166-2019第4.3.2条在控制器功能检查中列出了屏蔽、故障报警、短路隔离保护和火警优先等内容。这些是设备侧的业务边界,不是云端字段表。设计事件模型时可以沿用这些语义,但不能把某一家设备的协议码直接当成跨平台数据标准。
事件与状态分开写
四类事件各有边界
报警事件表达需要消防响应的危险状态。它至少要区分事件发生和恢复,是否已经人工确认则另做业务字段。火警是否保持到控制器复位,要跟设备自身的锁存策略或项目规定走,不能因为值班员点过“确认”,就把技术状态改成恢复。
故障事件表达设备或线路的工作异常。主电故障、备电故障、回路短路、部件通信异常都可能被控制器归到故障,但它们的故障码、影响范围和恢复条件并不相同。事件模型需要保留原始故障码和对象范围,不能只存一个笼统的 `FAULT`。
隔离还要再分两条路。人工屏蔽是操作员把设备暂时从监控逻辑中停用;短路隔离器动作则可能是线路异常后触发的保护状态。两者都可能表现为“这个设备暂时不参与正常监视”,但操作者、原因和恢复动作不同。事件里应保留 `isolation_mode`、作用范围、操作人、原因和恢复时间。
离线是链路可用性事件,通常由平台或边缘网关根据心跳和最近数据时间判断,不一定由现场控制器产生。设备离线不等于设备故障,设备在线也不等于探测器正常。把这几个概念揉在一起,最后会出现一条网络抖动把全场设备同时刷成故障的告警风暴。
一条事件至少带这些字段
下面是一份只表达数据契约的 JSON 示例。字段名称可以按项目调整,但语义不要省。
{
  "spec_version": "fire.event.v1",
  "event_id": "01JCGZ4XKJ8N9R3Q6M2A7T5B1C",
  "tenant_id": "tenant-01",
  "site_id": "site-a",
  "asset_id": "asset-loop03-addr042",
  "source_device_id": "ctrl-01",
  "source_point": "loop-03/addr-042",
  "event_family": "ALARM",
  "event_code": "FIRE_ALARM",
  "transition": "RAISED",
  "severity": "CRITICAL",
  "occurred_at": "2026-11-17T14:05:10.231+08:00",
  "received_at": "2026-11-17T14:05:10.487+08:00",
  "source_sequence": 1842,
  "correlation_key": "ctrl-01:loop-03:addr-042:fire",
  "quality": "GOOD",
  "details": {
    "controller_zone": "A-2F-03",
    "raw_code": "0x01"
  }
}
`event_id`要由事件生产者生成,重试和补传时保持不变。平台收不到原始 ID 时,可以在边缘侧按站点、设备、事件序号和时间生成,但生成后要落本地缓存,不能每发一次都换新 ID。
`asset_id` 是平台侧稳定资产标识,`source_device_id` 和 `source_point` 保留厂家设备与点位信息。不要用 IP 地址或 Topic 路径当资产主键,网络配置一改,历史数据就会断链。
`occurred_at` 和 `received_at` 必须分开。前者回答事情什么时候发生,后者回答平台什么时候收到。设备时钟可能有偏差,补传也可能晚到几个小时;只存接收时间会把故障顺序全部打乱。
`source_sequence` 适合在同一设备或同一网关内判断先后。它不是全站统一递增编号,也不能拿来给不同设备的事件排序。跨设备排序仍要看时间、站点分区和业务关联键。
`correlation_key`用来把发生、恢复和对应的当前状态串起来。它必须能准确落到业务对象,不要只写设备类型。一个控制器下面可能有多个回路、多个地址,只有 `FIRE_ALARM` 三个词无法判断是谁。
技术状态和业务处置分开
技术状态关心设备是否还在报警、故障或隔离。业务处置关心这条事件有没有人看见、谁确认、是否派单、工单是否关闭。两者生命周期不同。
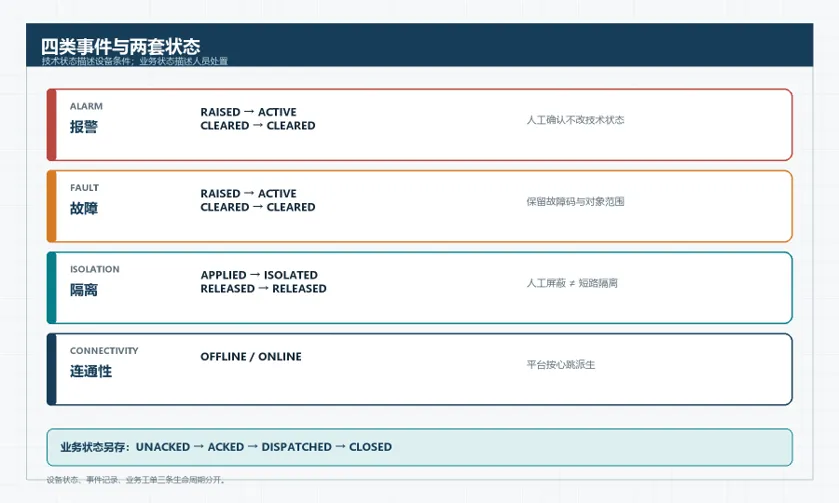
报警可以处于 `ACTIVE` 或 `CLEARED`,故障可以处于 `ACTIVE` 或 `CLEARED`,隔离可以处于 `ISOLATED` 或 `RELEASED`,连通性可以处于 `ONLINE` 或 `OFFLINE`。这些才是事件族自己的技术状态。
确认和关闭走另一组字段,例如 `ack_state`、`ack_by`、`ack_at`、`work_order_id`。值班员确认以后,火警仍可能没有恢复;工单关闭以后,设备层面也不等于自动正常。页面可以把两组状态一起展示,但数据库里不要互相覆盖。
TECHNICAL_TRANSITIONS = {
    ("ALARM", "RAISED"): "ACTIVE",
    ("ALARM", "CLEARED"): "CLEARED",
    ("FAULT", "RAISED"): "ACTIVE",
    ("FAULT", "CLEARED"): "CLEARED",
    ("ISOLATION", "APPLIED"): "ISOLATED",
    ("ISOLATION", "RELEASED"): "RELEASED",
    ("CONNECTIVITY", "OFFLINE"): "OFFLINE",
    ("CONNECTIVITY", "ONLINE"): "ONLINE",
}
这段映射只是把事件转换成语义状态。实际状态表还要保留每个事件族的更新时间、最后事件 ID 和最后序号,防止旧事件覆盖新状态。
四类事件别混状态
离线判定不要等设备来报
设备已经断网时,它通常没有办法发送一条“我离线了”。因此离线事件应由平台或边缘侧派生,依据是心跳、会话和最近有效数据时间,而不是等控制器给出故障码。
心跳不要每条都写进业务事件表。高频心跳适合进入时序库或状态缓存,离线事件只在状态跨越阈值时生成一次。阈值不能拍脑袋写死,应结合设备上报周期、网络抖动和项目运维要求配置。工程上可以用连续错过多个上报周期再判离线,并设置恢复防抖,避免一分钟内反复产生离线、在线事件。
一个常见的顺序问题是:设备已经恢复在线,网关才把之前缓存的离线事件补传上来。写入链路要以设备时间、序号和当前连接状态共同判断,不能因为补传包晚到,就把当前状态改回离线。
写入链路先处理重复和乱序
MQTT QoS 1 只保证消息“至少一次”到达,重连、云产品流转和消费重试都可能产生重复。事件写入必须用 `event_id` 做主键去重,而不是在页面查询时临时过滤。
下面是一张最小事件表和当前状态表的示意,具体字段类型可按数据库调整。
CREATE TABLE fire_event (
  event_id         VARCHAR(40) PRIMARY KEY,
  tenant_id        VARCHAR(40) NOT NULL,
  site_id          VARCHAR(40) NOT NULL,
  asset_id         VARCHAR(80) NOT NULL,
  event_family     VARCHAR(20) NOT NULL,
  transition       VARCHAR(20) NOT NULL,
  occurred_at      TIMESTAMPTZ NOT NULL,
  received_at      TIMESTAMPTZ NOT NULL,
  source_sequence  BIGINT,
  correlation_key  VARCHAR(160) NOT NULL,
  details          JSONB NOT NULL DEFAULT '{}'::jsonb
);

CREATE TABLE fire_state_current (
  correlation_key  VARCHAR(160) PRIMARY KEY,
  event_family     VARCHAR(20) NOT NULL,
  technical_state  VARCHAR(20) NOT NULL,
  last_event_id    VARCHAR(40) NOT NULL,
  last_sequence    BIGINT,
  last_event_at    TIMESTAMPTZ NOT NULL,
  ack_state        VARCHAR(20) NOT NULL DEFAULT 'UNACKED',
  work_order_id    VARCHAR(40)
);
事件表保存历史,状态表保存结果。告警页面直接查状态表,追溯页面再回查事件表和工作单。原始报文、附件地址或大段诊断信息放对象存储,事件表只留索引和摘要。
上线前拿七种坏数据试一遍
同一个 `event_id` 重复投递,数据库里仍只能有一条事件。旧序号的事件晚到,不能覆盖新状态。设备时间快十分钟,状态机仍要保留设备时间和接收时间,不能直接删除“看起来异常”的记录。
设备连续发生报警和恢复,要设置防抖和事件合并策略,但不能把真实反复报警隐藏掉。屏蔽解除和短路隔离恢复要分别测试,不能只用一个“恢复”事件把两种场景混在一起。设备离线后恢复在线,当前状态要回到在线,缓存区里的旧离线事件仍保留历史。人工确认以后火警未恢复,技术状态必须继续是报警。工单关闭以后故障仍在,也不能显示设备正常。
这几种场景都跑通,事件模型才不只是“能接收 MQTT 消息”。它还能解释发生了什么、谁产生的、什么时候到达、现在是否仍然存在,以及业务上处理到了哪一步。
以上为消防设备事件建模的技术讨论,不构成特定平台或设备接口承诺。事件字段、离线阈值、消息顺序、存储保留和业务状态,应以项目接口文档、设备协议以及当前云平台配置为准。
资料来源:GB 50166-2019《火灾自动报警系统施工及验收标准》第4.3.2条。
资料来源:GB 50116-2013《火灾自动报警系统设计规范》附录A。
资料来源:GB/T 26875.3-2011《城市消防远程监控系统 第3部分:报警传输网络通信协议》。
资料来源:GB/T 26875.4-2011《城市消防远程监控系统 第4部分:基本数据项》。
